人居微环境视觉检测系统
2026-10-112
✨ 项目核心亮点
- 完全本地私有化推理 所有图片、数据都在本机处理,依托Ollama运行LLaVA多模态大模型,图片不会上传公网,隐私友好。
- 前后端完整链路,开箱Demo可用
- 后端:FastAPI提供接口,模块化分层架构(Router / Service / Utils)
- 前端:静态HTML页面,支持图片上传提交,可视化展示评估结果
- 架构解耦:路由层、业务服务层分离,代码结构清爽,方便后续扩展
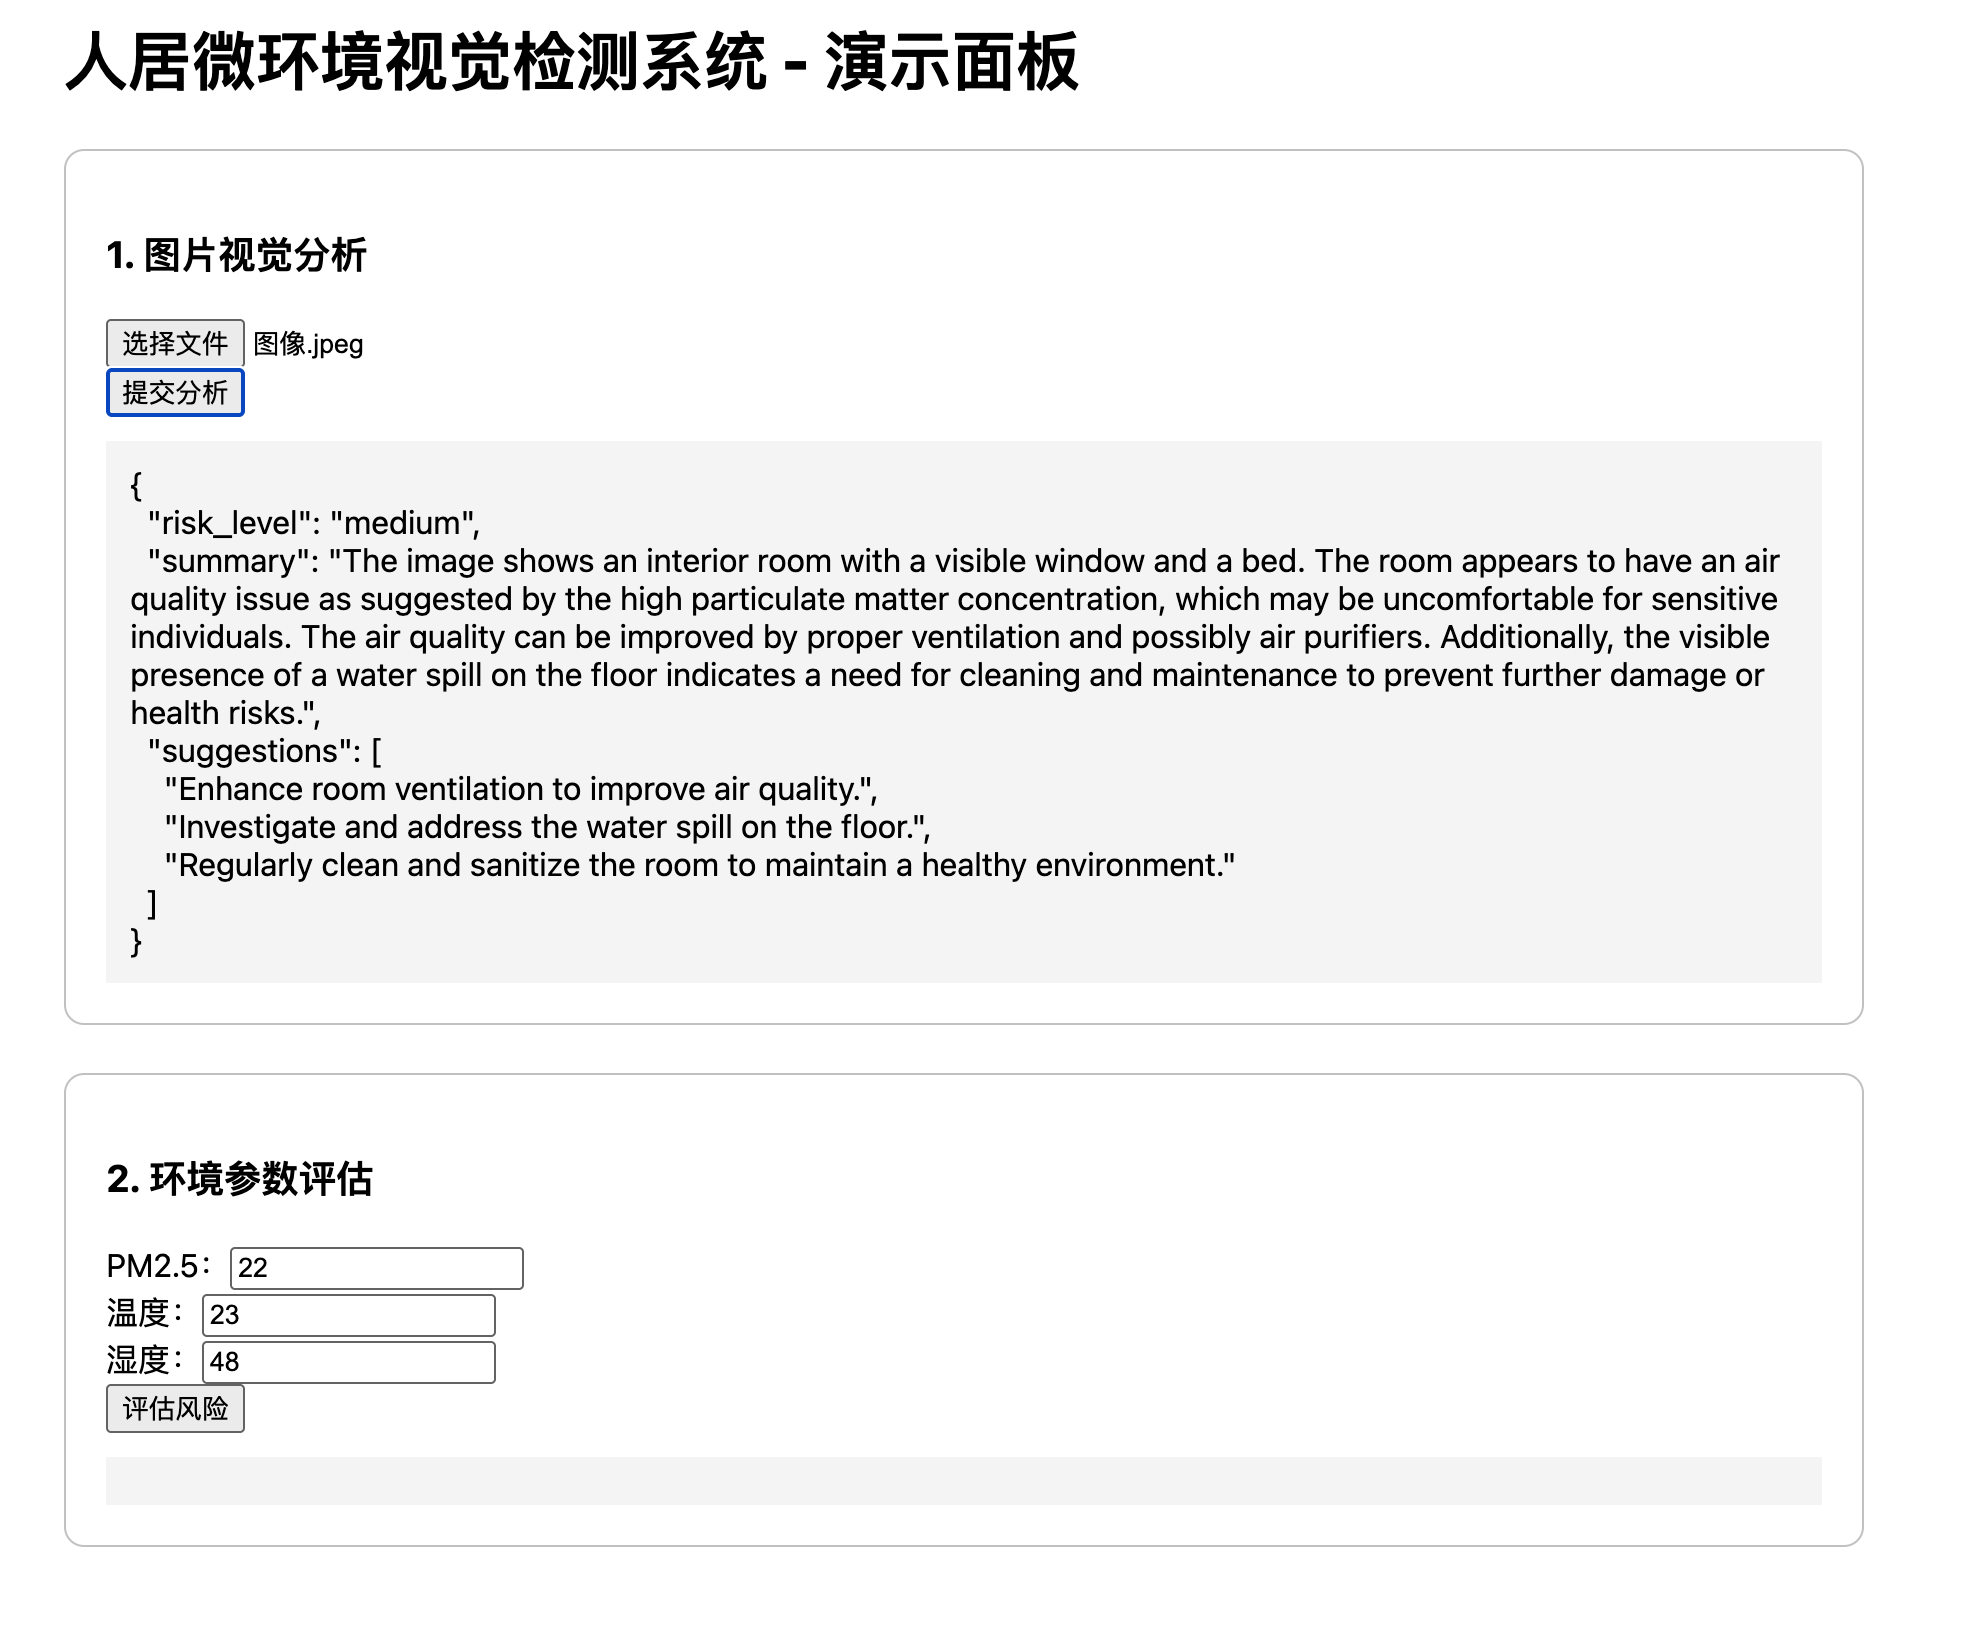
- AI视觉分析人居环境风险 上传室内实拍图片,LLaVA识别画面内隐患,按固定JSON格式输出:
- risk_level:风险等级 low / medium / high
- summary:环境情况总结
- suggestions:整改建议列表 可识别:积水、霉菌、杂物堆积、能见度差(空气污染)等室内人居隐患。
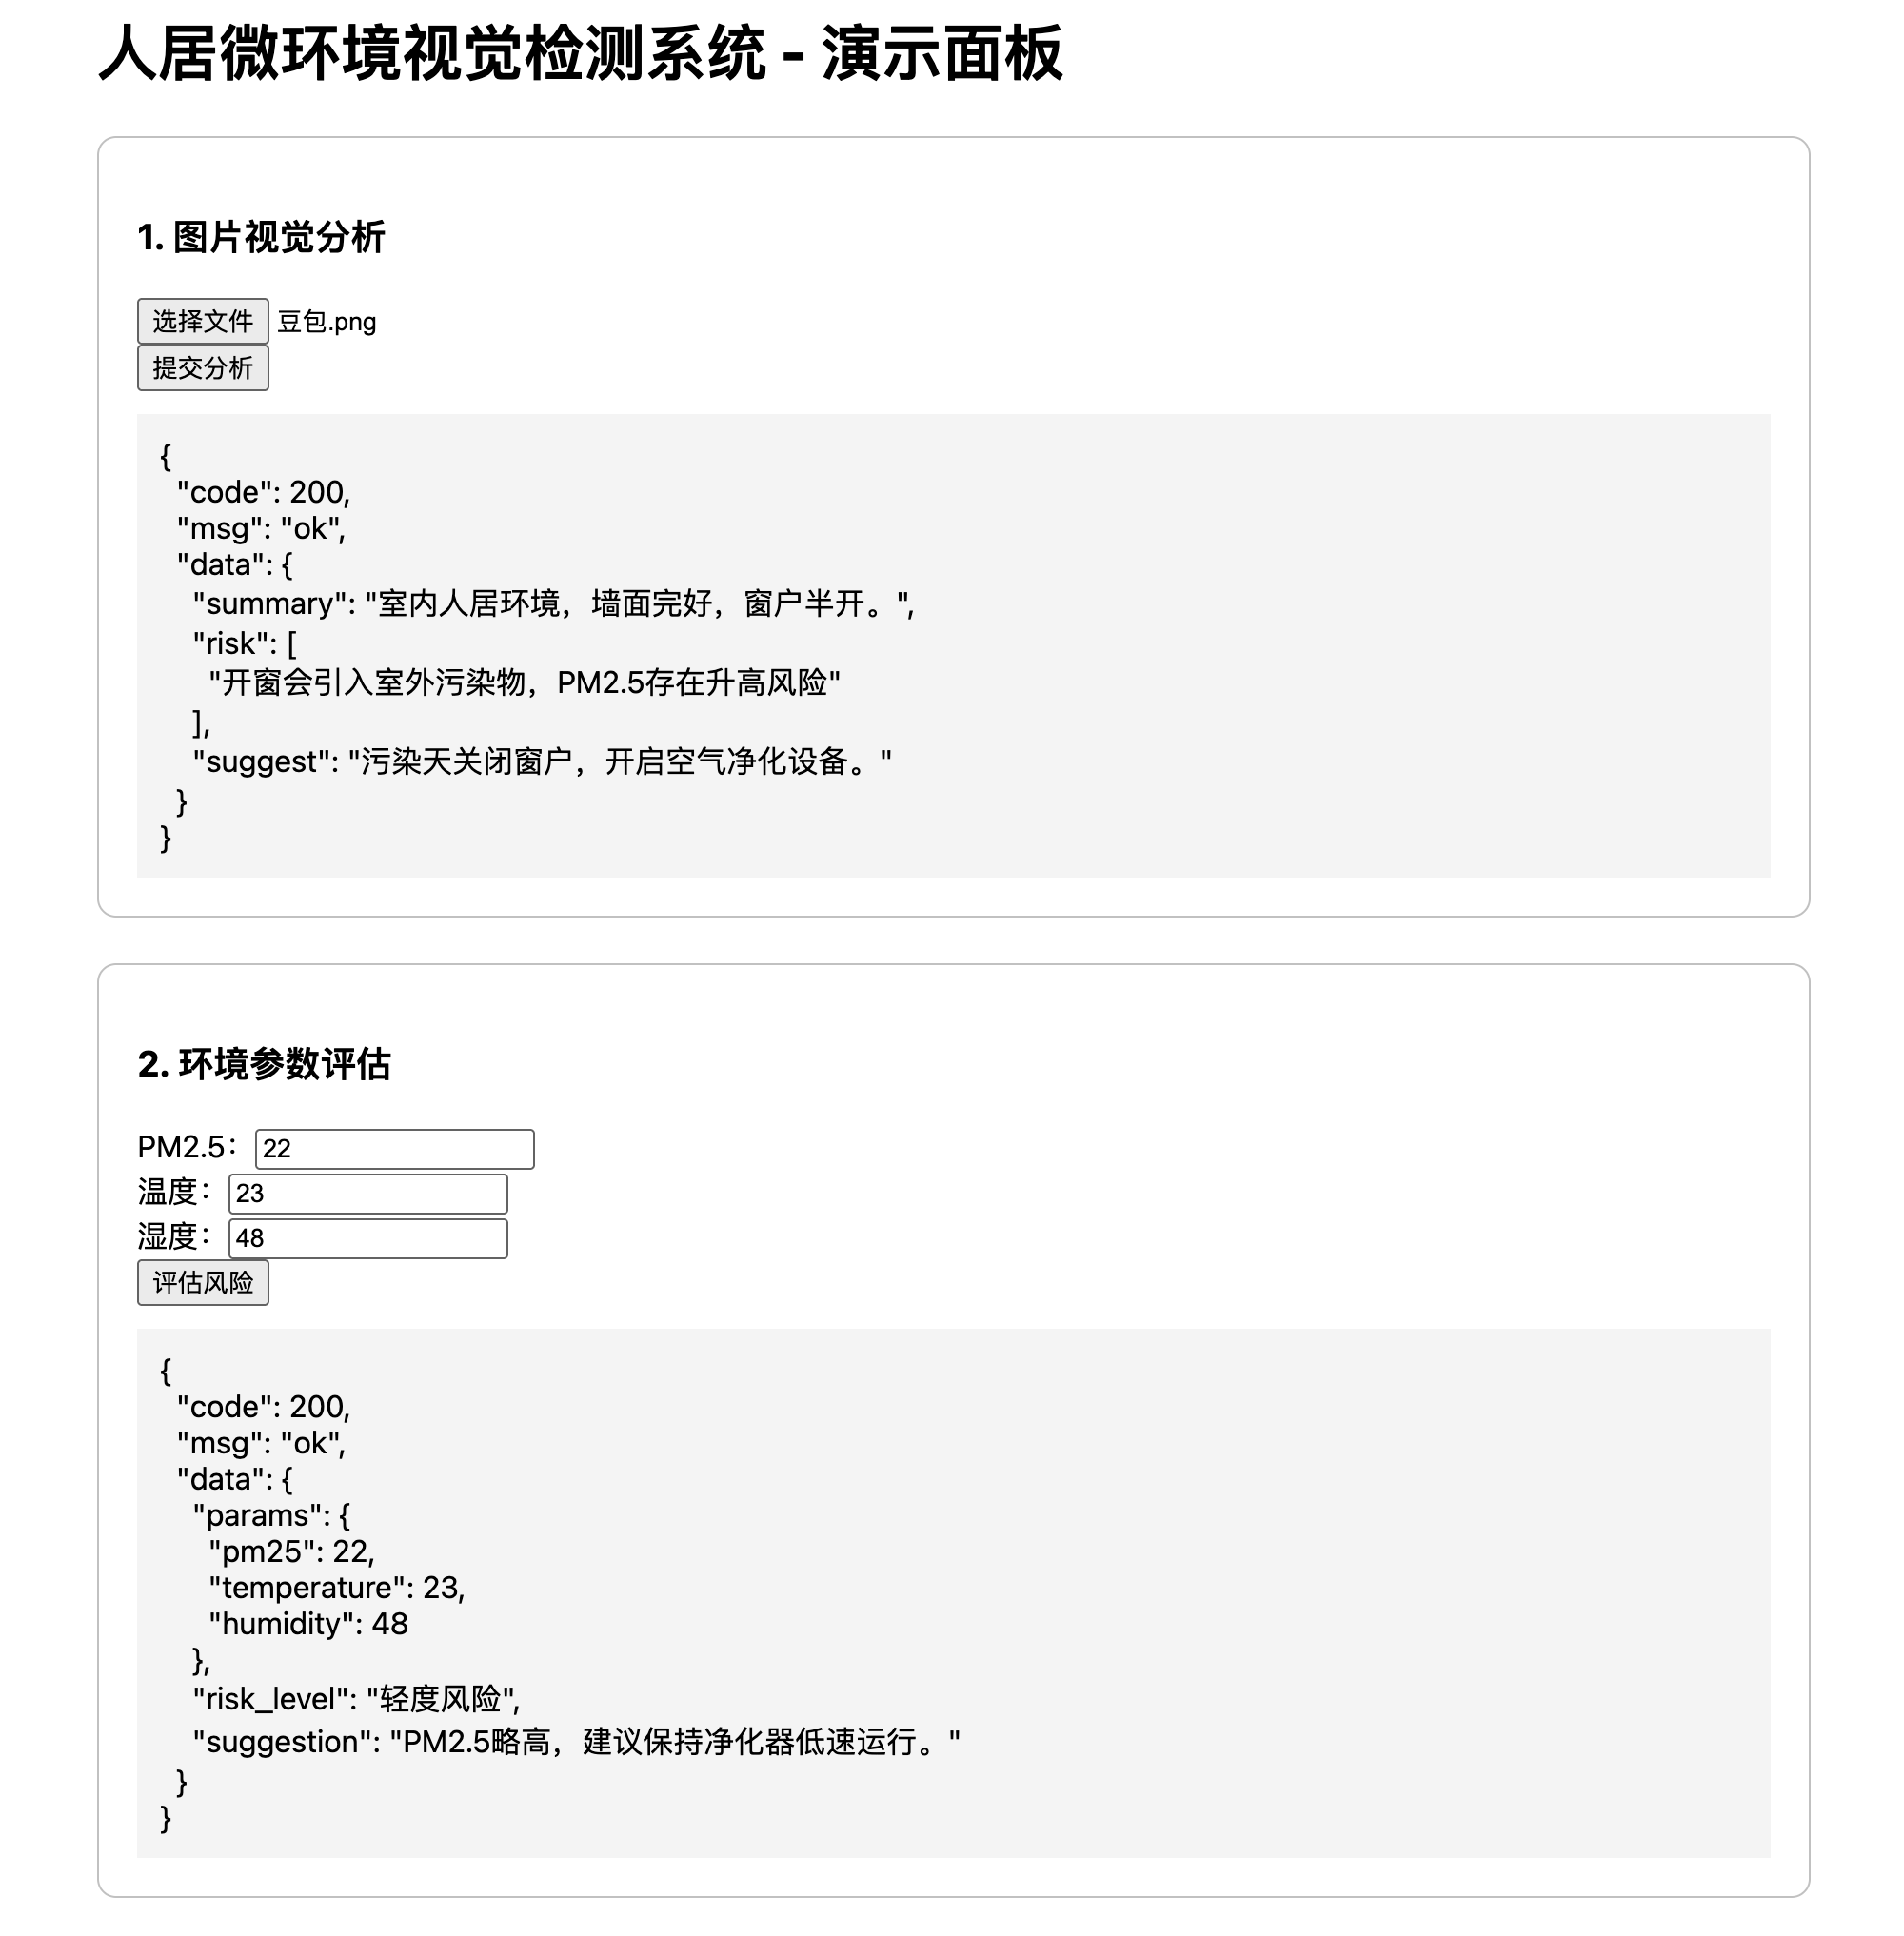
- 最小闭环开发思路,Mock先行再接入大模型 开发流程:先用Mock数据打通前端、接口全链路,验证交互逻辑;链路跑通后,直接替换为真实多模态大模型调用。 优势:调试简单,不会因为大模型不稳定导致整体服务崩溃;内置异常降级,模型调用失败自动返回兜底评估结果。
- 模块化设计,方便二次扩展 预留扩展方向:
- 接入RAG知识库,导入人居环境标准规则,降低大模型幻觉
- 对接传感器(PM2.5、温湿度),视觉+传感数据融合综合评估
- 增加视频帧采样分析,持续监控环境变化
- 新增更多场景规则(地下室、密闭舱体等封闭空间)
📦 技术栈
- Python + FastAPI:后端接口服务
- Ollama + LLaVA:本地多模态视觉大模型
- HTML原生前端:静态页面,无需前端框架
- httpx:异步HTTP客户端调用Ollama接口
- 项目目录规范,自带
.gitignore,可直接Git版本管理
📷 功能演示流程
- 启动Ollama本地服务,提前拉取LLaVA模型
- 启动FastAPI后端服务,浏览器访问本地首页
- 前端页面选择室内图片上传,提交请求
- 后端接收图片文件,转Base64,调用LLaVA视觉模型
- AI返回结构化评估结果,前端页面展示风险等级、总结、整改建议
📁 项目目录结构
human_env_api/
├── main.py                 # FastAPI入口,静态页面挂载
├── routers/
│   └── vision_router.py    # 图片分析接口路由
├── services/
│   ├── vision_service.py   # 视觉业务逻辑
│   └── llama_service.py    # Ollama LLaVA调用封装
├── html_basic/static/      # 前端静态页面(index.html)
├── utils/                  # 工具函数目录
├── config/                 # 配置文件目录
├── knowledge/              # 知识库目录(预留RAG扩展)
├── requirements.txt        # 依赖清单
└── .gitignore
📌 当前状态
✅ 已完成:图片上传链路、Base64处理、LLaVA本地调用、结构化JSON返回、前端页面展示、异常降级兜底。 ⏳ 待迭代:RAG知识库融合、多传感器数据接入、视频帧检测、更多场景规则优化。
💬 分享说明
本项目是DIY本地AI工具,代码开源分享,欢迎创客、硬件/环境爱好者交流讨论,一起迭代人居微环境检测方案。