把一滩水搬到行空板K10上:FluidBox 移植实录
前言
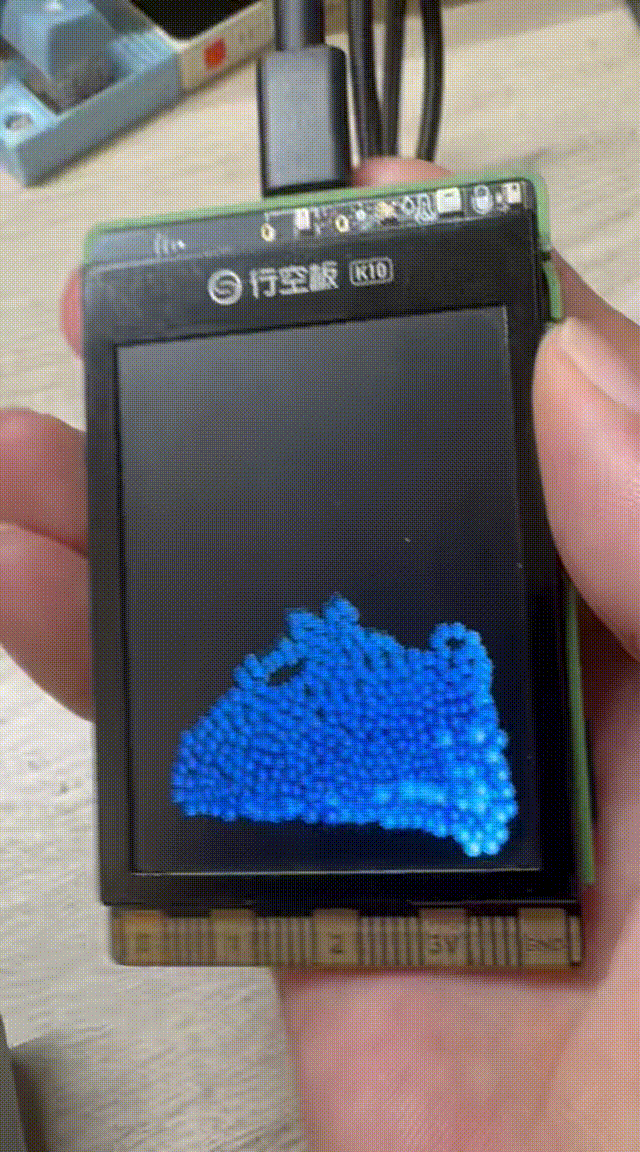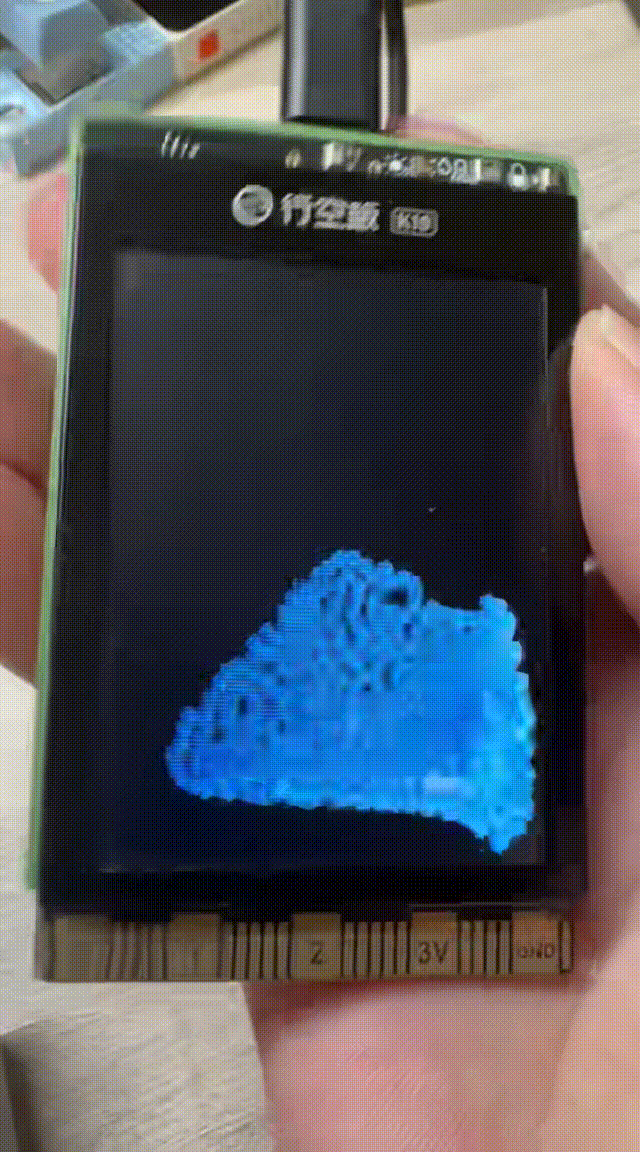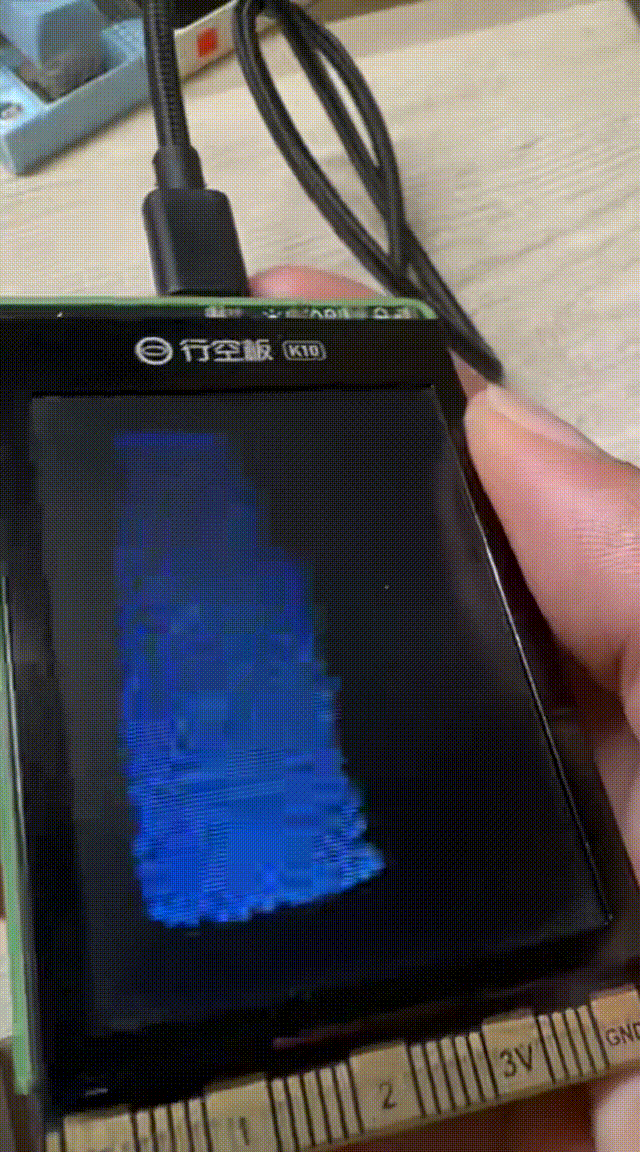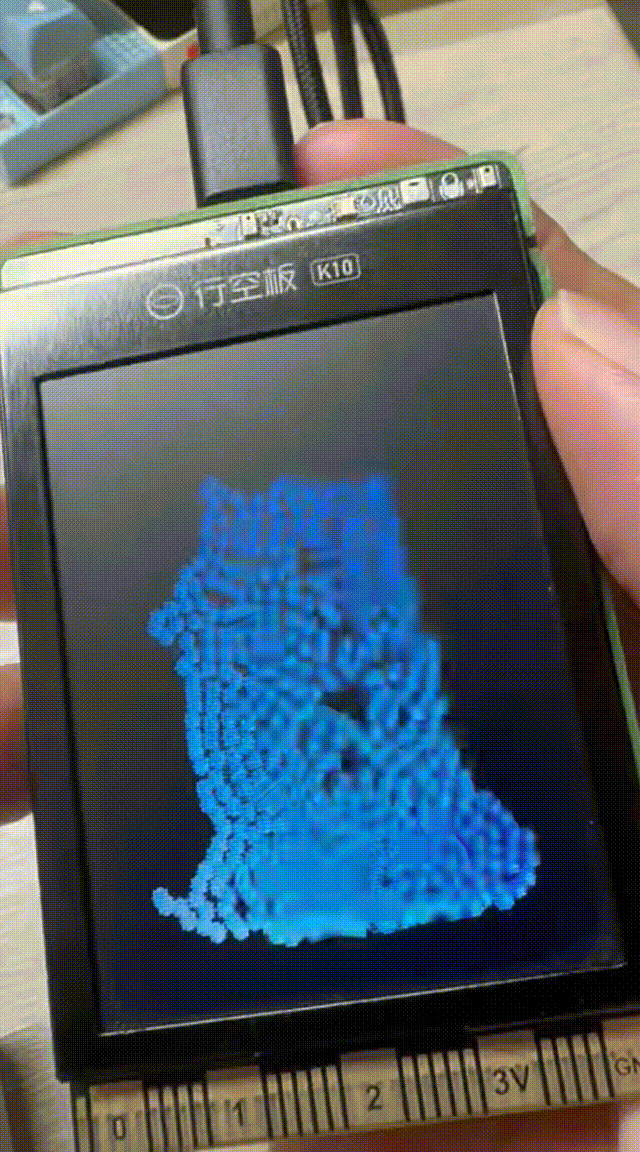
初期看到这个项目,我就被惊艳到了:一块没有 GPU、没有浮点加速器、连整帧显存都放不下的 ESP32-S3 小掌机,屏幕里居然养着一滩会晃、会溅、会沉底的 3D 流体——倾斜板子,水就跟着流;甩一下,水花撞上壁面再荡回来。画面的流畅程度完全不像这块芯片该有的水平。
第一反应是好奇:到底使用了什么魔法,才能在几百 KB 内存、240 MHz 主频的芯片上得到如此流畅的效果?
带着这个问题把源码通读了一遍,答案逐渐清晰。看懂之后,头自然冒出来:这么好的东西,能不能搬到更多人的板子上?于是有了这次移植,也就有了这篇文章。
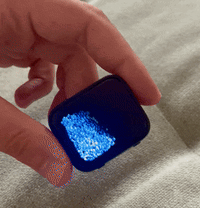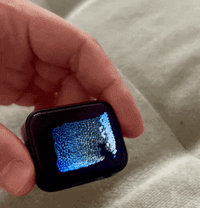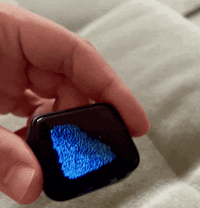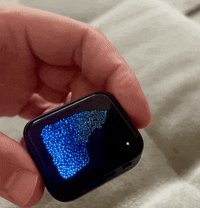
https://github.com/V4C38/esp32-fluidbox
一、移植的目的与意义
原项目本身运行稳定,做这次移植并不只是简单把 Demo 在新硬件跑通。原 FluidBox 项目深度绑定特定进口掌机,硬件获取门槛较高,不少感兴趣的开发者只能观看演示视频,而 DFRobot K10 在国内教育和创客社群保有量很大,同样搭载 ESP32‑S3,移植之后普通爱好者只需一条烧录命令就能运行这套粒子流体效果,让开源项目落地到更多人的开发板上;同时这次移植也是对项目宣称的 “算法与硬件完全解耦” 架构最严苛的实测,更换屏幕、移除陀螺仪、重写全部按键输入后,sim.c、render.c 实现零改动,印证前期架构设计的有效性;除此之外,整个移植过程沉淀下来的硬件差异梳理、BSP 复用、IMU 标定、受限硬件下图形方案取舍这一套可复用工作流,也可以给后续其他物理仿真、小游戏、可视化项目的跨板移植提供参考。
本文记录完整移植过程,聊清楚哪些代码必须修改、哪些逻辑绝对不能动,还有调试周期里最棘手的坐标轴标定问题。本文面向 ESP32 创客与嵌入式开发者,文中包含代码和数学公式,尽量侧重工程实践思路,即便不写代码,也能读懂一套完整的嵌入式项目移植工作方法。
二、盘点差异,分点击破
动手改代码,切忌直接打开工程,遇到报错就到处修补。第一件事,整理两块开发板全部外围硬件差异,逐项处理验证。
源项目 xiaocheng‑fluidbox 运行在 Waveshare ESP32‑S3 掌机,一共 400 个流体粒子,双核分工,核 1 负责流体求解,核 0 执行分条 DMA 屏幕渲染。
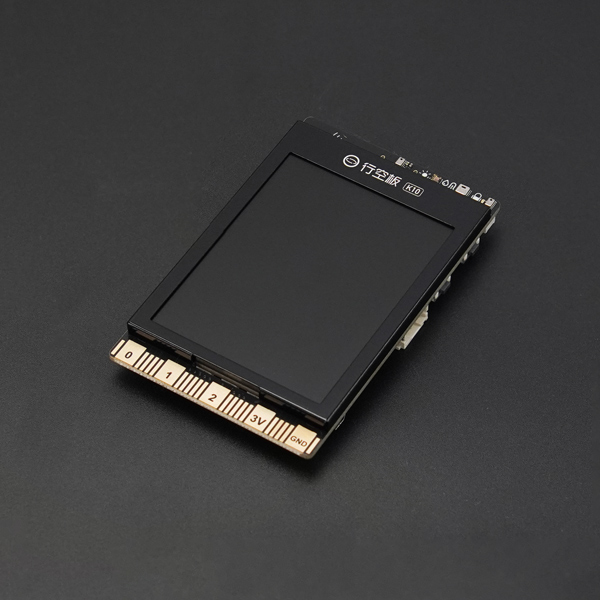
目标硬件 DFRobot K10,主控同样是 ESP32‑S3(16MB Flash / 8MB PSRAM),但是所有外设全部不同。
| 部件 | 原板(waveshare) | 目标板(DFRobot K10) | 是否需要修改 |
|---|---|---|---|
| 屏幕 | ST7789(AMOLED 排线) | ILI9341(SPI,竖屏物理贴装) | ✅ 更换面板驱动 |
| IMU 传感器 | 加速度计 + 陀螺仪 | SC7A20H,仅三轴加速度计 | ✅ 移除陀螺依赖,软件估算角速度 |
| LCD 上电 / 复位控制 | 普通 GPIO 直驱 | TCA9555 IO 扩展器输出 | ✅ 新增 I2C 扩展器上电时序 |
| LCD 硬件复位引脚 | 物理引脚可用 | 无硬件复位脚 | ✅ 改用寄存器软件复位 |
| 背光控制 | GPIO 可控开关亮度 | 无硬件控制脚,永久常亮 | ✅ 删除背光控制逻辑 |
| 按键输入 | 独立 PWR 电源按键 | TCA9555 扩展的 10 键矩阵键盘 | ✅ 重写按键扫描、消抖逻辑 |
| I2C 总线引脚 | 板载固定引脚 | SDA=47 / SCL=48,速率 400kHz | ✅ 修改 I2C 硬件引脚配置 |
流体求解 sim.c |
— | — | ❌ 一行代码未改动 |
粒子渲染 render.c |
— | — | ❌ 一行代码未改动 |
双核任务调度 main.c |
— | — | ❌ 仅改动外设初始化片段 |
全部硬件层面改动,收敛在 main/config.h 的板级配置段。仿真参数、物理常数、渲染逻辑和底层硬件彻底隔离开。移植本质是替换硬件抽象层,而不是重写上层业务。
三、移植思路
整理完硬件差异,在移植之前,要确定屏幕画面输出方案。ESP32 做图形开发一般有三条路径:Arduino 图形库、LVGL GUI 框架、乐鑫原生 esp_lcd API 自行实现渲染。
1. 为什么放弃 LVGL?
移植的初期,尝试过保留LVGL漂亮的界面,最终导致全面失败,耽搁了好一段时间,差点失去复刻的兴趣。
LVGL 擅长处理按钮、列表、弹窗这类复杂交互 UI。但本项目没有任何控件,只有 400 个粒子持续输出 60Hz 动画。LVGL 的场景图、脏区刷新、布局计算都会产生额外开销,对流体动画没有实际作用。
显存压力更加棘手,ILI9341 屏幕 320×240,RGB565 的完整帧缓冲就要 150KB。ESP32‑S3 的内部 SRAM 总共只有三百多 KB,仿真、任务栈、系统协议栈都要占用高速内存。单一个帧缓存就占掉一半 SRAM,方案不可行。
PSRAM 的访问速度远低于内部 SRAM,流体仿真的热路径绝对不能放在 PSRAM 上运行。
2. 为什么不用 TFT_eSPI 这类 Arduino 图形库?
TFT_eSPI 默认维护一整块完整帧缓存再推送到屏幕,同样会遇到 150KB 的内存瓶颈。就算开启分块缓冲模式,库自带的画圆、填充等通用绘制逻辑,和项目现有的分条 DMA、像素直写的渲染链路完全两套体系。我们移植的核心是流体算法,没必要额外引入一套通用图形栈。
3. esp_lcd 原生接口 + 自绘渲染,才是适配这个项目的形态
esp_lcd 只做很薄的一层封装:把一段内存缓冲区的数据输出到屏幕指定矩形区域。
esp_lcd_panel_draw_bitmap(panel, x0, y0, x1, y1, buf);
缓冲区内部像素内容完全交给开发者自己实现。
项目内部的渲染逻辑,包含针孔投影、颜色 LUT 查表、圆盘 Span 填充,直接向 320×16 的窄条缓冲写入像素,写完直接交给 DMA 搬运刷新,不存在多余图形抽象层,开销压到最低。
厘清我们的工作方向后,如果白手起家,难度也是挺大的,最好你有适当的研究基础,才下手。
- 构建好可用的 ESP-IDF 环境——装好对应版本(本项目用 ESP-IDF 6.1.0),
idf.py build能在命令行完整跑通,能正常烧录、能开 monitor 看日志。环境没调通之前,任何方案讨论都是纸上谈兵; - 有一个点亮屏幕的基础工程——从最简单的例程起步:初始化 SPI 总线 + 面板驱动,往屏幕上刷一块纯色。这个"Hello Screen"工程是后面所有工作的试验台:上电时序对不对、引脚配置对不对、像素时钟稳不稳,都在这一步验证。
行空板 K10 扩展板 ESP‑IDF 完整 BSP 驱动开源实践
在这两篇基础参考文章基础上继续推进我的项目,似乎就没那么难了。
四、分点击破
差异清单里的每一项,按"先让屏幕亮,再让输入通,最后对齐传感器"的顺序逐项击破。
击破点①:先让屏幕成功点亮
ILI9341 有官方维护组件 espressif/esp_lcd_ili9341,在idf_component.yml添加一行依赖就可以引入驱动。真正耗时间的,是 DFRobot K10 这块板子特殊的上电时序。
1. 藏在 IO 扩展器里面的上电脉冲
K10 的 LCD 电源不受普通 GPIO 控制,由 I2C 接口的 TCA9555 16 位 IO 扩展芯片的 P0.0、P0.1 引脚控制。屏幕上电必须严格执行对应的脉冲时序,跳过这一步,无论怎么写寄存器,屏幕始终黑屏。
// TCA9555 P0.0/P0.1 —— LCD上电脉冲时序掩码
#define TCA_PIN_PULSE_MASK 0x03
移植有一个很实用的经验,不要凭空猜测时序。优先查阅厂商官方 BSP 代码。这里直接参考 K10 官方示例 esp‑claw 里 setup_device.c 的复位序列,省去大量反复试错。
2. 没有硬件复位脚、没有背光控制脚
没有物理复位引脚,无法电平操作复位屏幕面板,改用 ILI9341 自带的软件复位寄存器完成复位;硬件没有背光控制引脚,屏幕始终常亮,直接删掉背光渐变的相关任务。
3. 竖屏面板 swap_xy,埋下坐标系大坑
这块 ILI9341 面板物理是 240×320 竖屏贴装,项目需要横向输出画面,代码开启坐标交换:
esp_lcd_panel_swap_xy(panel, true);
写这行代码的时候看不出问题,它只是旋转屏幕输出。但是流体仿真内部坐标系没有同步跟着旋转,这个细节,给后续坐标轴调试埋下很大隐患。
击破点②:保留按键重置流体的行为
原版掌机按下 PWR 电源键,流体全部重置。K10 的所有按键全部挂在 TCA9555 扩展器上,属于 10 键矩阵键盘,低电平有效。
拆解实际需求,我们并不限定某一个特定按键,只需要一个外部触发信号来重置流体模拟。逻辑可以大幅简化:读取扩展器 port1 的按键掩码,任意按键拉低就判定按键按下,叠加 50ms 软件消抖,一百多行 button.c 就实现全部功能。
移植不要死板复刻旧硬件的实现细节,优先抓住底层行为需求。旧硬件需要指定按键,新板子只需要任意输入事件,代码完全可以做减法。
击破点③:丢掉陀螺仪,旋涡效果怎么救回来?
原设备 IMU 同时带加速度计与陀螺仪,甩动板子产生旋涡,直接读取陀螺仪输出的角速度。
K10 搭载的 SC7A20H 只有三轴加速度计,没有陀螺仪。第一反应,旋涡功能只能直接砍掉。
但通过数学推导,可以复原大部分旋涡效果。加速度计测不出绕重力轴的自转,却可以持续拿到重力向量 \hat{g}。刚体旋转状态下重力向量满足:
\frac{d\hat{g}}{dt} = \omega \times \hat{g}
等式两边左叉乘重力单位向量 \hat{g},就可以解算出垂直重力方向的角速度分量:
\omega_\perp = \hat{g} \times \frac{d\hat{g}}{dt}
板子抬头、低头、左右倾斜,这类改变重力朝向的旋转动作,都可以通过加速度的微分反推角速度。有一个客观局限:拿着板子绕竖直重力轴原地转动,这个运动原理上无法观测,对应角速度只能固定为 0,这点硬件局限需要接受。
微分运算会放大传感器噪声,项目增加三层参数做噪声抑制:
| 参数 | 功能说明 |
|---|---|
GYROLESS_GAIN |
总增益开关,置 0 直接关闭旋涡模拟 |
GYROLESS_OMEGA_LP_HZ |
估算角速度后,经过 6Hz 低通滤波,压制高频噪声 |
GYROLESS_SHAKE_GATE_G |
0.35g 甩动门限;剧烈晃动时重力观测失效,角速度做半衰衰减,而不是直接清零 |
为什么选择半衰而不是直接清零?旋涡属于物理惯性量,如果瞬间清零,流体视觉效果会非常生硬,逐步消散更符合真实观感。
移植不等于照搬功能清单,读懂每个参数背后的物理逻辑,才能在硬件变更时做出合理取舍。
这里还有意外收获:原版带陀螺仪时,经常要处理赝矢量跟随屏幕镜像翻转带来的符号错误。现在角速度直接在仿真坐标系内部完成估算,镜像变换带来的符号问题直接消失,去掉硬件传感器,反而解决一类难缠 bug。
五、坐标轴映射
整个移植过程,调试耗时最多的不是屏幕、不是按键,是 IMU 坐标轴映射。表面看只是三行宏,背后横跨三层坐标系,任意一层方向、符号出错,倾斜板子水流方向就会错乱。
①芯片传感器坐标系(ax/ay/az) → ②仿真坐标系(x向右/y向下/z穿入壳体) → ③屏幕显示坐标系
        由芯片贴片硬件决定        IMU_MAP_*映射宏        swap_xy / mirror镜像
项目这里有一处隐蔽陷阱:render.c 的粒子投影逻辑本身不带坐标旋转,而 display.c 开启了 swap_xy(true)。叠加之后,仿真内部 X 轴,对应屏幕画面竖直方向。
人的直觉习惯屏幕上下对应 Y 轴,如果跟着直觉来回修改正负符号,怎么调效果都是错的。
经过多轮上板实测标定,最终得到正确映射,写在main/config.h:
#define IMU_MAP_X(ax, ay, az) (ay)    // 屏幕【竖直轴】 ← 芯片 ay
#define IMU_MAP_Y(ax, ay, az) (ax)    // 屏幕【水平轴】 ← 芯片 ax
#define IMU_MAP_Z(ax, ay, az) (az)    // 壳体深度轴 ← 芯片 az
三组映射全部直接取用原始数值,没有取反;重力反向处理已经写在imu.c内部 dx = -s_lp,映射层不再叠加负号,做到职责分离。
调试坐标轴,不要依靠观察水面现象猜正负。打开main.c的AXIS_CALIB_LOG串口打印开关,直接输出传感器原始读数。把板子摆到四个典型姿态,每种姿态静止 3 秒,就可以反解完整坐标轴映射,完整数学推导参考仓库文档 docs/IMU_AXIS_MAPPING.md。
六、流体力学模拟:超纲了
前面移植工作介绍完毕。sim.c八百五十行代码是整套流体的物理内核,全程没有改动。看完这一节就能明白:仿真代码完全不关心自己跑在哪块板子上,只接收外部传入的重力、角速度向量。
1. 水不是算力,是算粒子位置
现实水体分子数量极其庞大,嵌入式设备不可能逐个模拟。本项目用 400 个粒子代表一小团团水体,算法是 PBF Position‑Based Fluids,基于位置的流体。
这套算法思路和传统物理模拟不太一样:优先修正粒子位置,而不是一步步计算受力。
传统仿真流程:计算合力→积分加速度→积分速度→更新位置,每一步都会不断累积计算误差。
PBF 的处理流程,先用惯性预测粒子下一时刻位置;之后校验粒子之间是过于拥挤还是过度分散,直接修正粒子坐标,再反向推导出速度。这套逻辑稳定性很强,就算大幅度甩动板子,也不会出现粒子飞散爆炸。
2. 高效寻找邻居:格子划分 + 计数排序
流体只和附近粒子产生相互作用,如果两两暴力计算距离,400 粒子每帧要做 16 万次运算,MCU 负担太重。
解决方案,把仿真空间切分为 15×12×3 = 540 个空间格子,每个粒子只检索自身格子和周边 26 个相邻格子。
做完格子检索之后,再执行计数排序,三轮 O (n) 循环把粒子按照格子编号在内存重新排布。这一步带来三重收益:
- 同一格子粒子内存连续,CPU 缓存命中率明显提升;
- 相邻格子的数据在内存地址上大多靠近,硬件预取可以生效;
- 格子编号以 z 深度为主序,排序完成天然按深度有序;渲染反向遍历,直接实现从后往前绘制。
在缓存只有几百 KB 的 MCU 上,内存排布优化带来的性能提升,很多时候比算法本身修改效果还要明显。
3. 一聚一散,成就液态效果
通过平滑核函数算出每个粒子的局部密度,分离两种压力项:
// 普通压力,可正可负
press = K_PRESSURE * (density - rest_density);
// 近距排斥压力,永远大于0
press_near = K_NEAR_PRESSURE * density_near;
| 符号 | 作用 | |
|---|---|---|
| 普通压力 | 有符号 | 密度过高推开粒子,密度过低拉近粒子;水面张力属于系统涌现行为,不需要手写表面张力公式 |
| 近压力 | 恒正 | 只做排斥,避免多个粒子互相堆叠 |
普通压力负责把水体聚拢,近压力负责粒子互相弹开,两项平衡,才能呈现出水的视觉效果。
4. 看不见的物理容器
屏幕画面看不到容器边框,但物理模拟内部存在一个圆角盒子。边界检测没有写大量 if‑else 区分墙面、拐角,统一用一套数学处理逻辑。
把粒子坐标夹持到圆角圆心构成的内矩形,剩余偏移指向轮廓最近点;x、y 压缩为径向坐标,再在径向‑深度平面再做一次夹持,一套逻辑处理全部边界几何形态。
5. 旋转参考系:三种伪力带来真实晃动手感
倾斜、甩动板子,流体处于加速旋转的非惯性参考系。除重力之外,还需要叠加三种伪力:
acc += gravity;                              // 重力
acc += ROTATION_GAIN * (r * w2 - ...);       // 离心力:快速甩圈水贴向容器边缘
acc -= ROTATION_GAIN * (alpha × r);          // 欧拉力:板子急停,水体产生切向冲劲
acc -= ROTATION_GAIN * 2.0f * (omega × v);   // 科里奥利力:旋转参考系内粒子偏转
只单纯施加重力,晃动板子水会像一堆硬质颗粒生硬摆动。三种伪力一起参与运算,才能得到贴近真实的晃动手感。
6. 时间缩放:慢放真实物理
#define TIME_SCALE 0.100f // 时间缩放系数,0.1倍速运行
现实中水运动速度很快,当前模拟盒子的尺寸条件下,重力会让水几毫秒就撞击盒底,人眼看不清流动细节。项目直接把全局时间放慢十倍。全部物理常数维持真实数值,只拉长时间尺度。
对比调小重力:修改重力会直接改变流体本身特性;时间缩放只是播放慢动作,所有物理关系完整保留。

七、烧录、验收
移植合格标准不是屏幕有水跑起来,核心验收条件:流体运行行为和原版硬件保持一致。
粒子数量、平滑半径、压力系数、时间缩放,全部沿用原项目仿真参数。两块板子做相同倾斜、甩动操作,水面涟漪表现应当完全一致,这就是软硬件解耦带来的好处。
工程版本存在差异,原项目基于 ESP‑IDF 5.5;本次 K10 移植版本使用 ESP‑IDF 6.1.0。
编译烧录命令:
idf.py set-target esp32s3
idf.py build
idf.py -p <你的串口设备> flash monitor
sdkconfig.defaults里面几项配置直接影响流体热路径性能,需要逐项核对:
CONFIG_ESP_DEFAULT_CPU_FREQ_MHZ_240=y   # CPU拉满240MHz,仿真需要充足算力
CONFIG_FREERTOS_HZ=1000                 # RTOS节拍1000Hz,保证仿真渲染时序精确
CONFIG_SPIRAM=n                         # 仿真热路径完全运行在内部SRAM,不走PSRAM
CONFIG_COMPILER_OPTIMIZATION_PERF=y     # 开启性能级别编译优化
串口每两秒输出诊断日志,包含帧率、流体求解分段耗时、传感器原始数据。判断移植有没有完整复现原版行为优先看串口数值,不要只靠肉眼观察屏幕画面。
写在最后:移植完成不是终点
必须承认,把项目成功移植到 K10 上,看着水流在另一块板子的屏幕里晃出同样的涟漪,是挺有成就感的。但这份成就感是短暂的——烧录成功的那个瞬间,成就感就开始贬值了。
真正的意义不在"跑起来了",而在往深处走:
- 吃透流体模拟的实现原理。 位置约束为什么比力的积分更稳定?双密度松弛里一聚一散怎么平衡?计数排序为什么能一石三鸟?这些设计背后是计算物理和实时系统的交叉知识,值得逐行读懂
sim.c,甚至动手改参数、破坏它、再修好它。 - 理解整个项目的构思细节。 无陀螺仪怎么用数学救回角速度、没有帧缓冲怎么把 DMA 藏进渲染循环、圆角容器怎么用两次夹持零分支解决——这套"在资源上限下做取舍"的思维方式,才是能带走的东西。下次面对的不是流体,可能是任何受约束的实时系统,思路是相通的。
- 把 K10 实现当作随手可得的实验平台。 这次移植真正的产出,是在一块保有量很大的板子上搭好了一个可视化的沙盒:调参立刻能看到画面变化,串口日志随手可读。有了它,学习流体力学、验证新想法、做自己的物理仿真实验,都不再需要任何门槛。
移植是手段,平台是载体,深入理解原理才是目的。 屏幕上那滩水跑起来只是开始——愿你把它拆开、改坏、再修好,从"它能动"走到"我懂它为什么能动"。
可以直刷固件体验: