给 DFR1221 圆屏装上「小智 AI」:从零适配、触摸修复到会说话的三套动态角色
一块 1.85 寸圆屏、ESP32-S3R8、PDM 麦克风 + PCM5100A,官方 Wiki 里找不到能直接跑小智 AI 的板级源码。
于是我从原理图和官方示例里把引脚一个个抠出来,给开源项目 xiaozhi-esp32 新增了一套完整板型,
顺手修好了「点屏没反应」,再加上语音定时提醒、一只能自动校时的圆形时钟和和三套会动嘴的原创角色。
文末提供编译好的固件,不想装 ESP-IDF 也能直接烧来玩。
一、背景:Wiki 很详细,但缺了最关键的那份源码
这块板子是 DFRobot 的 DFR1221 ESP32-S3 1.85 寸圆形触摸屏开发板,官方 Wiki:
硬件本身很讨喜:360×360 圆屏、电容触摸、板载 PDM 麦克风、PCM5100A 立体声 DAC、TF 卡座,甚至还有 Qi 无线充电。拿来做一个桌面 AI 小伙伴再合适不过。
但真动手把开源项目 小智 AI(xiaozhi-esp32) 移植上去时,遇到两个绕不开的问题:
- Wiki 没有提供适配小智 AI 所需的源码。 Wiki 和配套资料包给的是产品规格、原理图、Arduino / ESP-IDF 的屏幕显示示例,属于「让你把屏点亮」的层级;而小智 AI 是 ESP-IDF + LVGL + MCP 的完整固件,需要的是一个
Board派生类:显示、触摸、音频编解码、背光、按键、唤醒词全部按框架接口接好。这份板级驱动并不在官方资料里,需要自己写。 - Wiki 页面的引脚说明不够完整。 QSPI 六根数据/时钟线、触摸的 RST/INT、DAC 的 XSMT 静音脚等关键信号,需要对照官方原理图以及示例工程
ST77916_LVGL_DEMO里的pincfg.h才能补齐。少一根线,屏就可能不亮、触摸就永远没反应。
所以这个项目做的事情,本质上是把「官方硬件资料」翻译成「小智 AI 能直接编译的板型」,并把结果完整开源,让后面拿到同一块板子的朋友不用再啃一遍原理图。
在这里也感谢 DFRobot 提供了原理图和可运行的显示示例,屏的 184 条初始化命令正是从官方 scr_st77916.h 逐条比对来的。
最终成果一览
| 项目 | 结果 |
|---|---|
| 新增板型 | dfrobot/df-s3-1.85-round,已接入 Kconfig 与构建脚本 |
| 显示 / 触摸 | ST77916 QSPI 360×360、CST816S 电容触摸,点屏可唤醒对话 |
| 音频 | PDM 麦克风采集 + PCM5100A I2S 播放,XSMT 静音控制 |
| 语音定时提醒 | 3 个 MCP 工具,支持每隔 N 分钟 / 重复 N 次 / 查询 / 取消,NVS 持久化,断网可用 |
| 自定义角色 | 3 套皮肤 × 8 种状态 = 24 个 GIF,对话时嘴型随真实音量张合 |
| 交互 | 左右滑动切换角色,选择写入 NVS,重启保持 |
| 固件 | 16MB 合并镜像 + 5 个分分区 bin,Flash Download Tool 可直接烧 |
| 最终 app 大小 | 2,802,192 B,app 分区剩余 32% |
二、硬件与准备
材料清单
| 序号 | 材料 | 说明 |
|---|---|---|
| 1 | DFRobot DFR1221 开发板 | ESP32-S3R8,16MB Flash,8MB OPI PSRAM |
| 2 | Type-C 数据线 | 必须支持数据,不能是纯充电线 |
| 3 | 3.5mm 有源音箱 / 耳机 | 板子不带功放和喇叭,不接就完全没声音 |
| 4 | Windows PC + ESP-IDF v6.1 | 只想烧固件的话可跳过,直接用 Flash Download Tool |
| 5 | 2.4GHz WiFi | 小智 AI 需要联网激活与对话 |
重要提醒:这块板的音频输出是 Line out,不是扬声器输出。第一次调试「完全没声音」时,先确认外接的是有源音箱。
引脚总表(本次适配的核心产出)
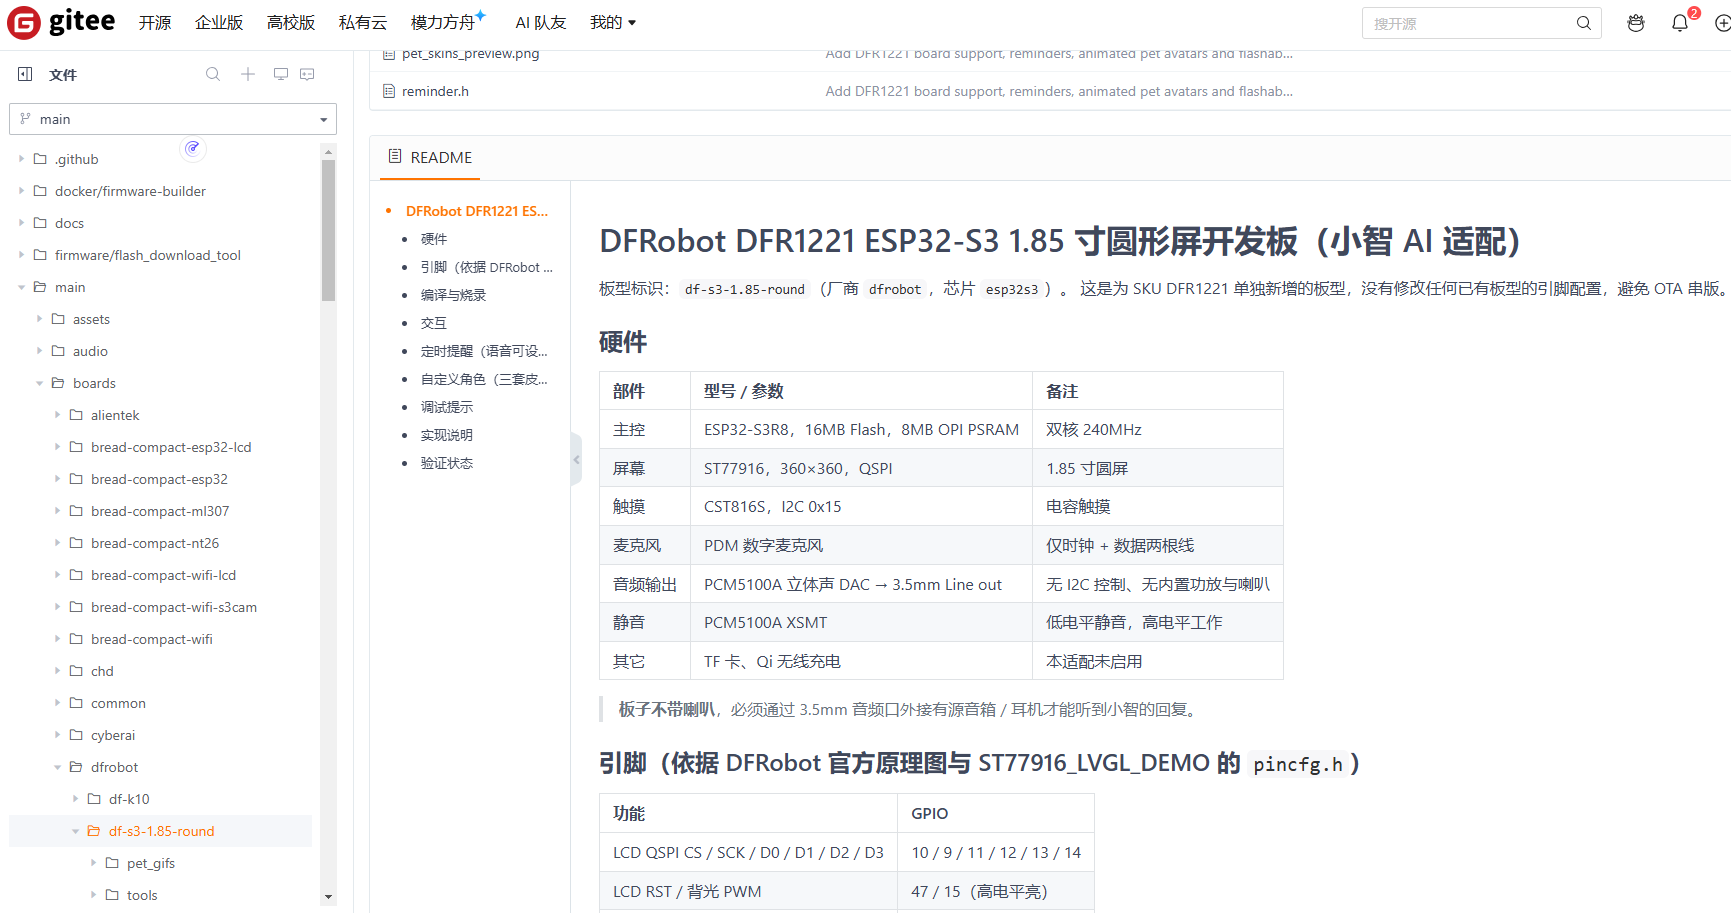
依据官方原理图与示例 pincfg.h 整理,全部集中在 main/boards/dfrobot/df-s3-1.85-round/config.h:
| 功能 | GPIO |
|---|---|
| LCD QSPI CS / SCK / D0 / D1 / D2 / D3 | 10 / 9 / 11 / 12 / 13 / 14 |
| LCD RST / 背光 PWM | 47 / 15(高电平亮) |
| 触摸 CST816S SDA / SCL / RST / INT | 7 / 8 / 40 / 41 |
| PDM 麦克风 CLK / DATA | 45 / 46 |
| I2S DAC BCLK / WS / DIN | 18 / 16 / 17 |
| DAC XSMT(解除静音) | 48 |
| BOOT 按键 | 0 |
屏幕走 SPI2_HOST、50MHz QSPI;触摸 I2C 地址 0x15;音频输入 16kHz、输出 24kHz;TF 卡占用 GPIO 1~6,本适配未启用,与上述外设不冲突。
三、第一步:把板型接进小智 AI 工程
小智 AI 通过 Kconfig 选择板型,再由 main/CMakeLists.txt 把对应目录编进来。新增板型要做三件事。
1)在 main/Kconfig.projbuild 里注册选项:
config BOARD_TYPE_DF_S3_1_85_ROUND
    bool "DFRobot ESP32-S3 1.85inch Round Display (DFR1221)"
    depends on IDF_TARGET_ESP32S3
2)在 main/CMakeLists.txt 里加分支,指向 boards/dfrobot/df-s3-1.85-round,并把字体/emoji 资源一并加入。
3)写板型目录,config.h 定义上面的引脚,.cc 里完成初始化:
- 显示:
esp_lcd_st77916组件 + 184 条厂商初始化命令(与官方scr_st77916.h逐字节一致),QSPI 32-bit 命令字; - 触摸:
esp_lcd_touch_cst816s,通过lvgl_port_add_touch()挂到默认显示器; - 音频:
NoAudioCodecSimplexPdm(PDM 采集 + 标准 I2S 播放),派生Pcm5100aAudioCodec管理 XSMT 静音脚; - 背光:
PwmBacklight,亮度可从设置中恢复。
编译(ESP-IDF v6.0.1 以上,推荐 release/v6.1):
idf.py set-target esp32s3
python scripts/build.py dfrobot/df-s3-1.85-round --name df-s3-1.85-round --language zh-CN
idf.py -p COM10 -b 921600 flash monitor
也可以在 idf.py menuconfig → Xiaozhi Assistant -> Board Type 里选 DFRobot ESP32-S3 1.85inch Round Display (DFR1221) 后直接 idf.py build。项目默认就是 16MB Flash + partitions/v2/16m.csv + Octal PSRAM,不需要额外覆盖 sdkconfig。
配图建议:这里放一张 menuconfig 里能看到 DFR1221 选项的截图,或编译成功的终端截图。
四、踩坑一:屏亮了,但怎么点都没反应
第一次烧完,屏、触摸驱动、WiFi、唤醒词全都正常,可点击屏幕完全不触发对话,只能用 BOOT 键。
排查后发现问题不在硬件:lvgl_port_add_touch() 只是把 CST816S 注册成 LVGL 的输入设备,并不会自动产生「点击唤醒」这个业务动作。而小智 AI 通用 UI 里创建的屏幕、容器、聊天气泡默认都不是 clickable,也没有挂 LV_EVENT_CLICKED 回调。换句话说,触摸坐标进得来,但没有任何对象「接」这个事件。
修法是派生一个自己的 Display 类,在基类 SetupUI() 之后补上可点击标记和事件回调,并让后创建的聊天气泡把事件冒泡上来:
class DfrobotS3Round185Display : public PetAvatarDisplay {
public:
    using PetAvatarDisplay::PetAvatarDisplay;

    void SetupUI() override {
        PetAvatarDisplay::SetupUI();
        DisplayLockGuard lock(this);

        // 覆盖屏幕 / 容器 / 聊天区,保证点到哪里都能唤醒
        for (lv_obj_t* obj : {lv_screen_active(), container_, content_}) {
            if (obj == nullptr) continue;
            lv_obj_add_flag(obj, LV_OBJ_FLAG_CLICKABLE);
            lv_obj_add_event_cb(obj, PressCb,   LV_EVENT_PRESSED,  this);
            lv_obj_add_event_cb(obj, ReleaseCb, LV_EVENT_RELEASED, this);
            lv_obj_add_event_cb(obj, GestureCb, LV_EVENT_GESTURE,  this);
            lv_obj_add_event_cb(obj, TapCb,     LV_EVENT_CLICKED,  this);
        }

        // 聊天气泡是运行期逐条创建的,让它们把事件上抛
        lv_obj_add_event_cb(content_, [](lv_event_t* e) {
            lv_obj_t* chat = static_cast<lv_obj_t*>(lv_event_get_user_data(e));
            uint32_t n = lv_obj_get_child_cnt(chat);
            if (n > 0) {
                lv_obj_t* bubble = lv_obj_get_child(chat, n - 1);
                lv_obj_add_flag(bubble, LV_OBJ_FLAG_EVENT_BUBBLE);
                lv_obj_add_flag(bubble, LV_OBJ_FLAG_GESTURE_BUBBLE);
            }
        }, LV_EVENT_CHILD_CREATED, content_);
    }
};
修完做了 300 秒串口监听,点屏后日志打印 Touch press at (178, 144) / Touch tap at (178, 144),状态机 idle -> connecting -> listening,随后完整跑通一轮对话:录音识别 → MQTT 会话 → TTS 回复 → speaking -> listening → 收到 goodbye 回到 idle。触摸唤醒、录音、网络对话、播放全链路闭环,无 panic、无重启循环。
五、功能一:说一句话就能设个定时提醒
小智 AI 支持 MCP 工具,云端大模型可以直接调用设备端能力。我给这块板注册了 3 个工具:self.reminder.set / self.reminder.list / self.reminder.cancel。
于是配网激活后,直接说自然语言就行:
| 说什么 | 效果 |
|---|---|
| 每 10 分钟提醒我喝水 | 每 600 秒一次,一直重复到取消 |
| 10 分钟后提醒我开会 | 600 秒后提醒一次 |
| 每 5 分钟提醒我吃药,一共 3 次 | 300 秒一次,触发 3 次后自动结束 |
| 现在有哪些提醒 | 列出内容、间隔、剩余次数、距下次秒数 |
| 取消喝水提醒 / 取消所有提醒 | 按内容关键词或 all 全部取消 |
实现上有几个刻意的设计:
- 纯相对时间:基于
esp_timer的 1Hz 心跳,不依赖 RTC、SNTP,也不依赖服务端调度,断网照样提醒。 - NVS 持久化:最多 8 条,用
Settings("reminder")存 JSON,重启后按完整间隔重新计时。 - 到点反馈:屏幕通知 + 本地 OGG 提示音 + 角色切到 happy 蹦跳,8 秒后由
Schedule(DismissAlert)自动复位界面,不会把状态栏一直占着。 - 离线可用:默认是文字 + 提示音;
voice=true时才额外请求云端 TTS 播报(设备端没有本地 TTS 引擎)。
端到端实测(12 分钟串口监听):
语音:「30秒之后提醒我站起来」
  → Reminder: set r0f3211221: '站起来活动一下' every 30s, repeat=1
  → 32 秒后 Reminder: FIRE: 站起来活动一下
语音:「取消提醒」
  → cancelled 1 reminder(s) with 'all'
语音:「现在有哪些提醒?」
  → self.reminder.list 返回空,小智回复「现在一个提醒都没有喔」
中间还修了两个静态审查发现的体验问题:提醒到点后 Application::Alert() 留下的消息一直挂着;有限次数提醒的 repeat_left 递减没写回 NVS,重启后会多送几次。现在每次递减都持久化。
配图建议:放一张提醒弹出时的屏幕实拍,以及串口日志截图。
六、功能二:三套会动的角色,说话时嘴真的会张
小智 AI 自带的表情是静态 Emoji 集合,我想给这块圆屏做一个「有生命感」的桌面伙伴,于是自己画了三套角色。
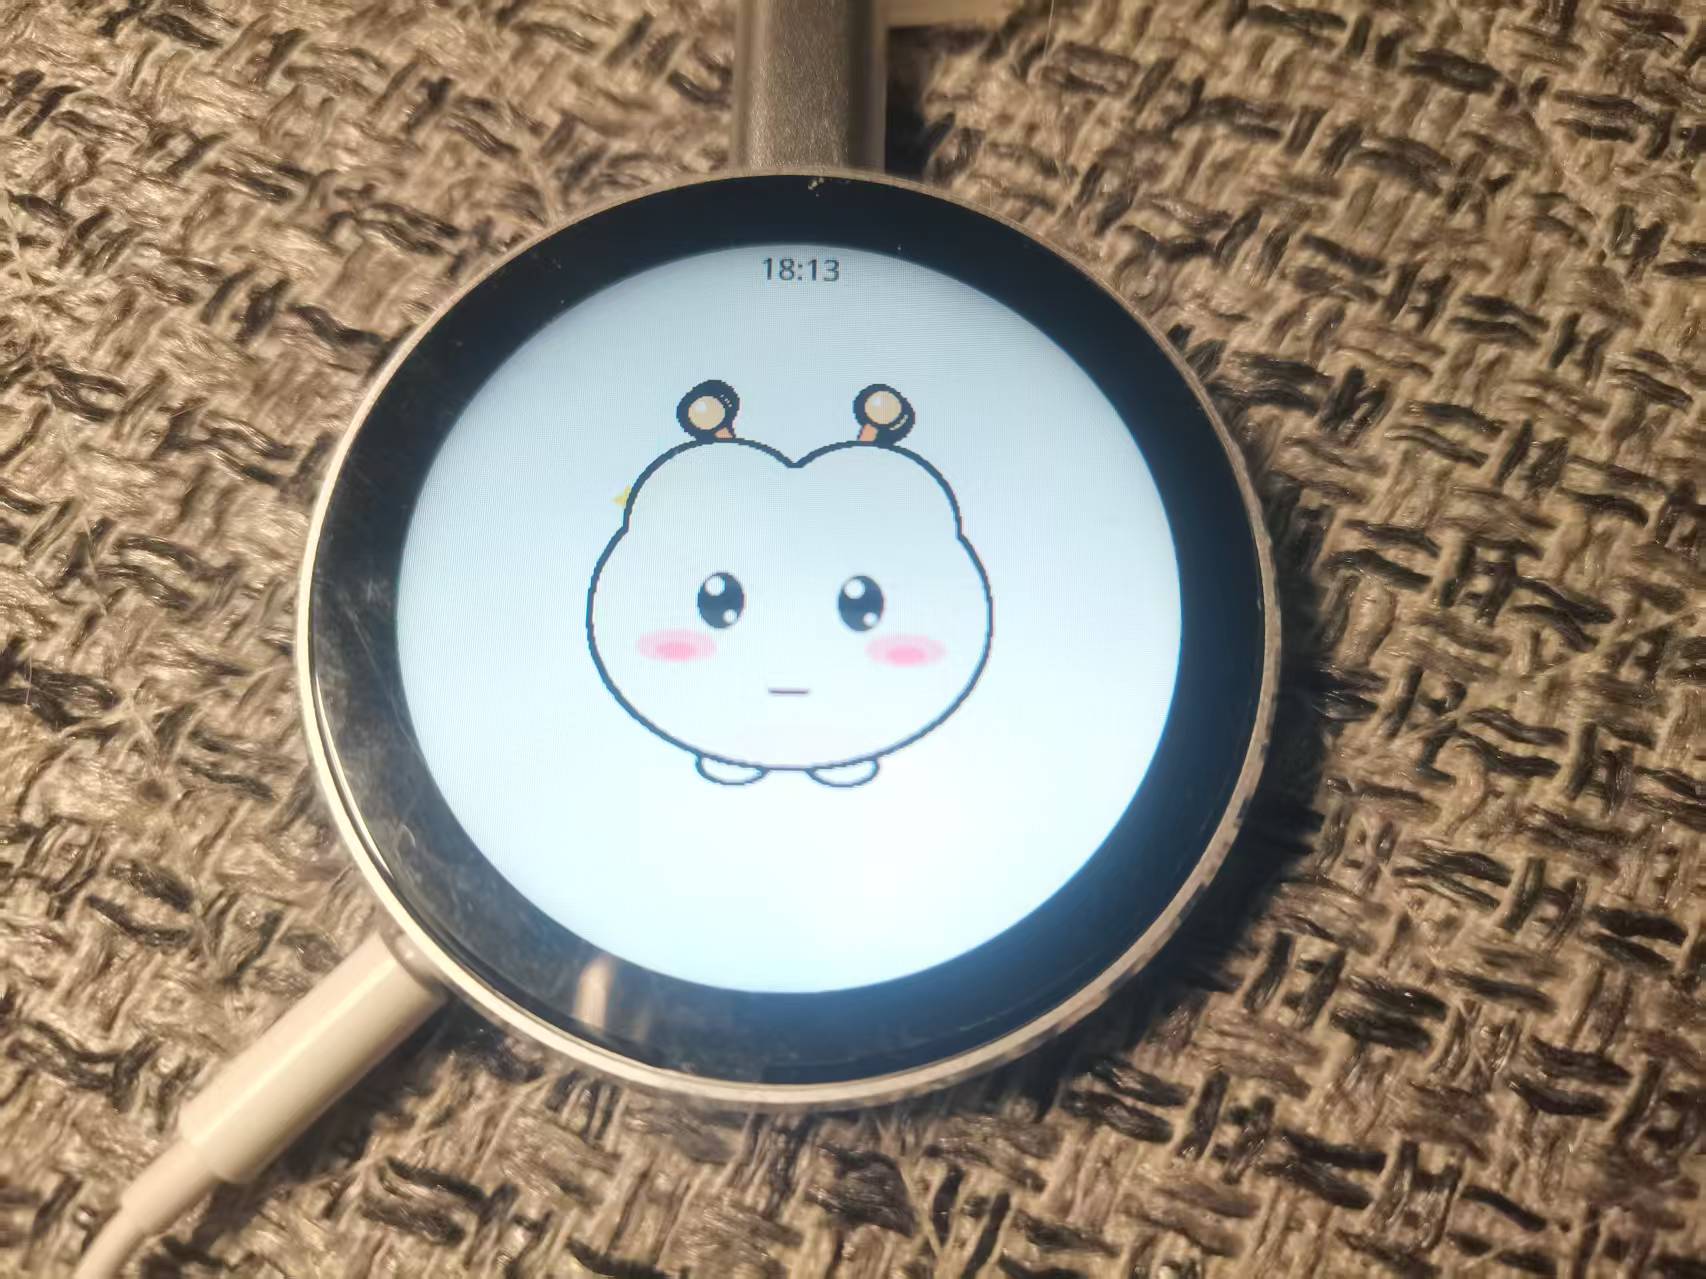
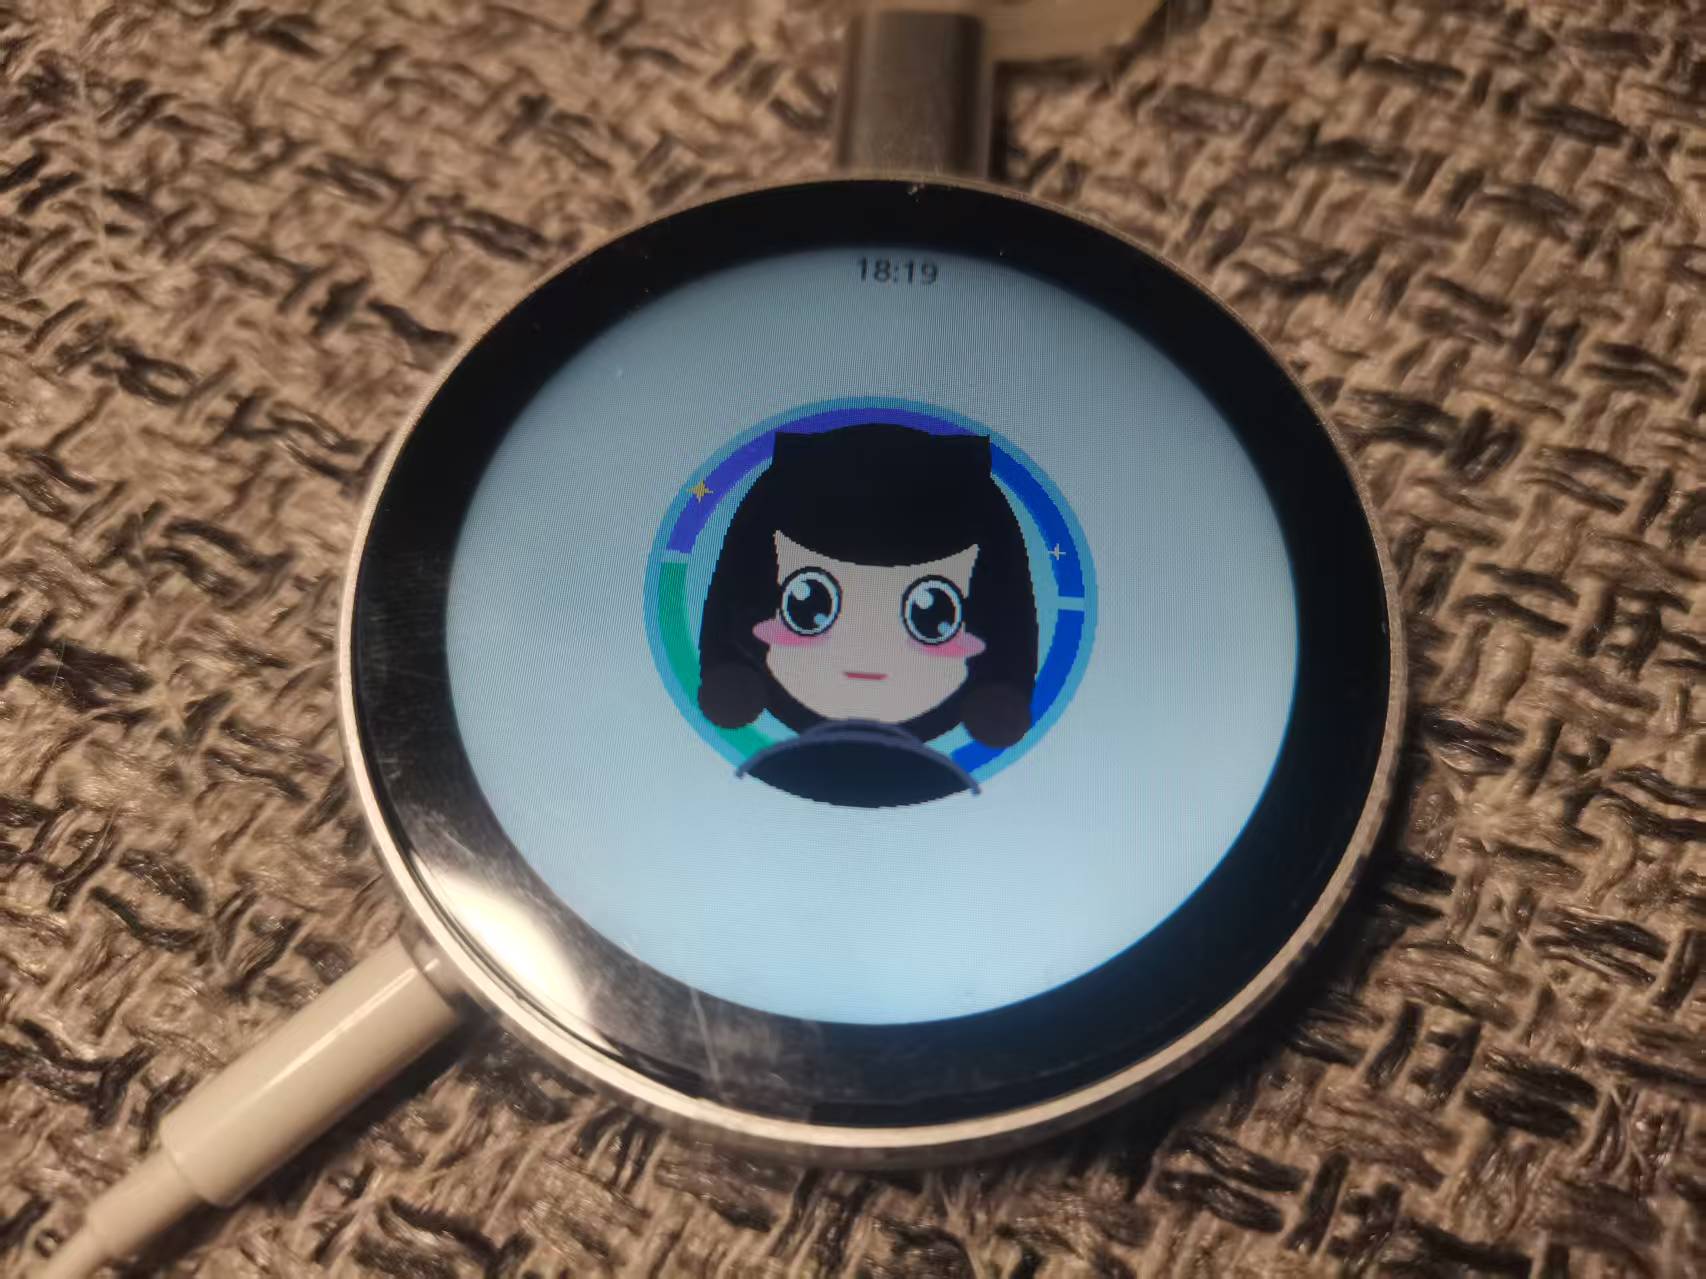
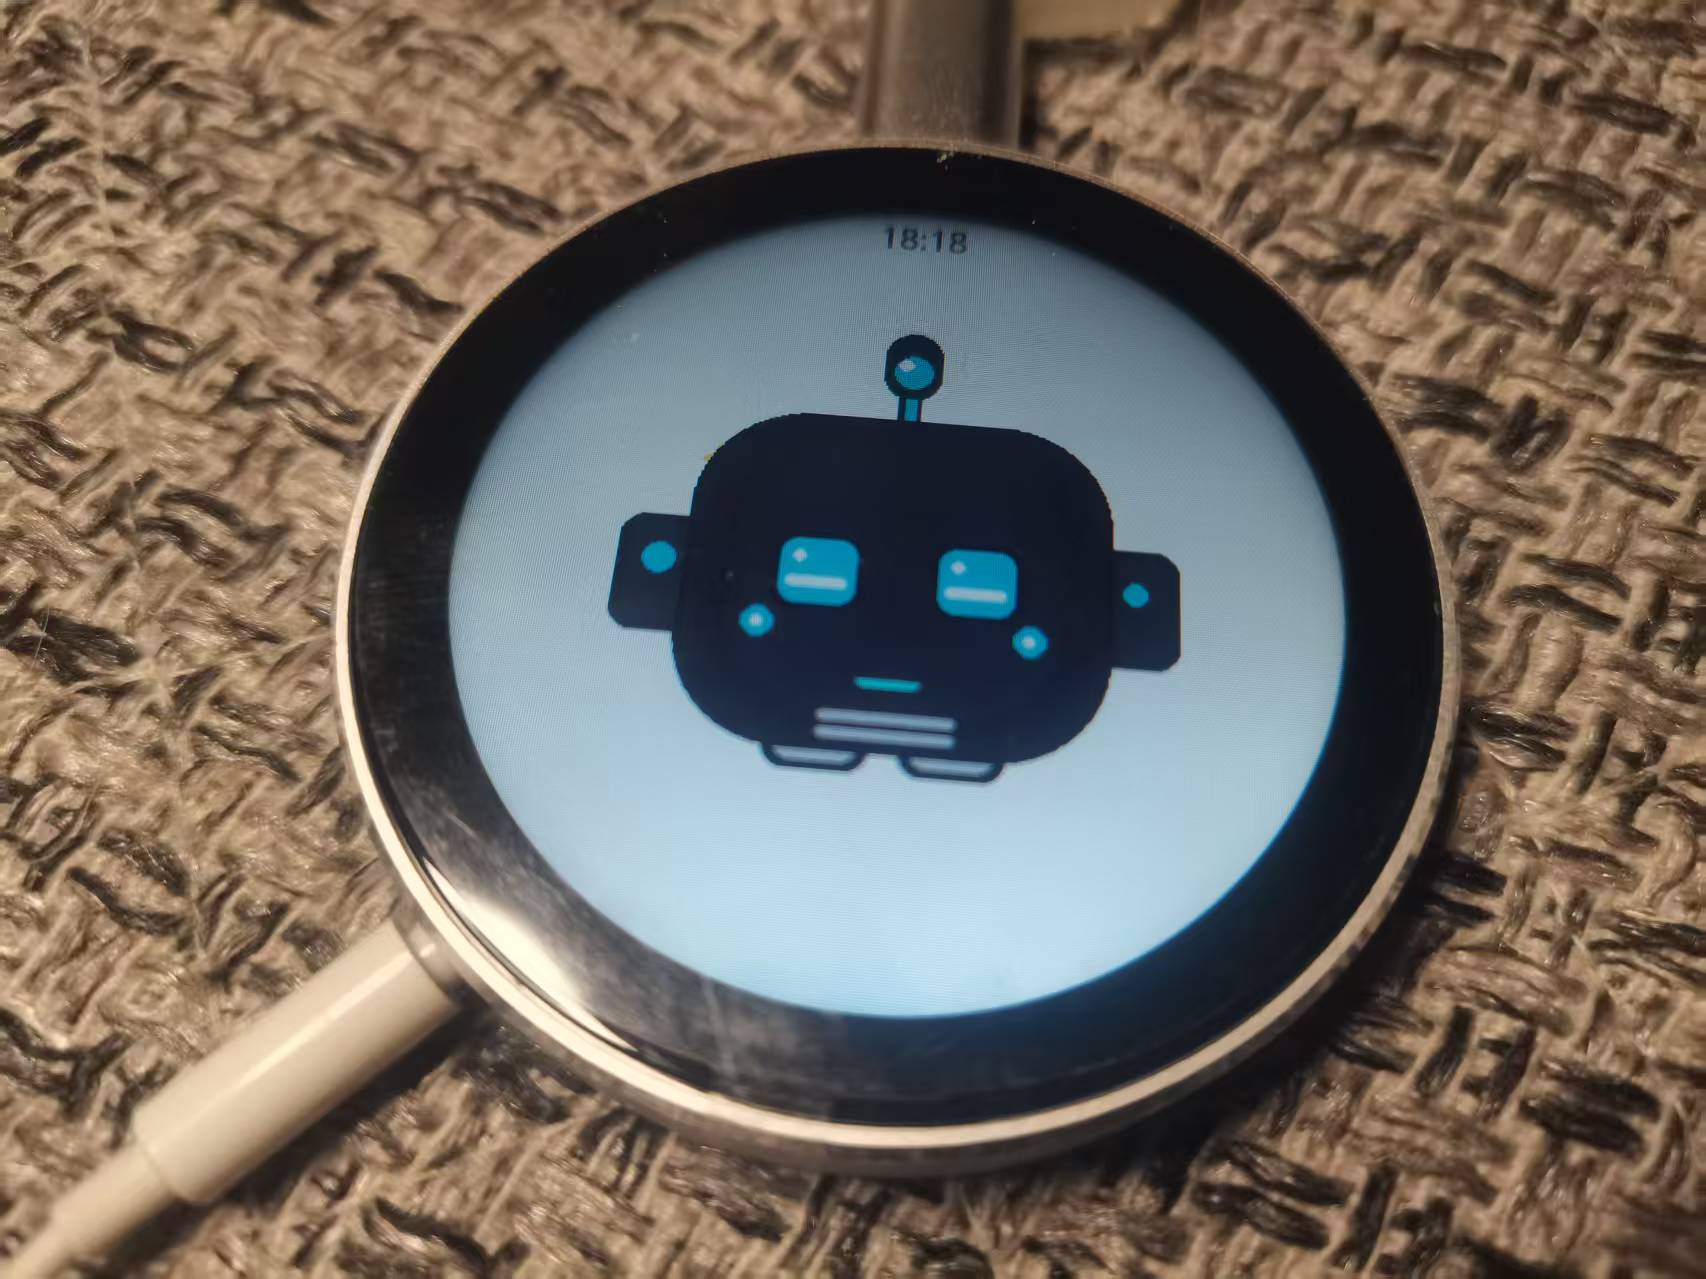
| 皮肤 | 形象 | 嘴型 |
|---|---|---|
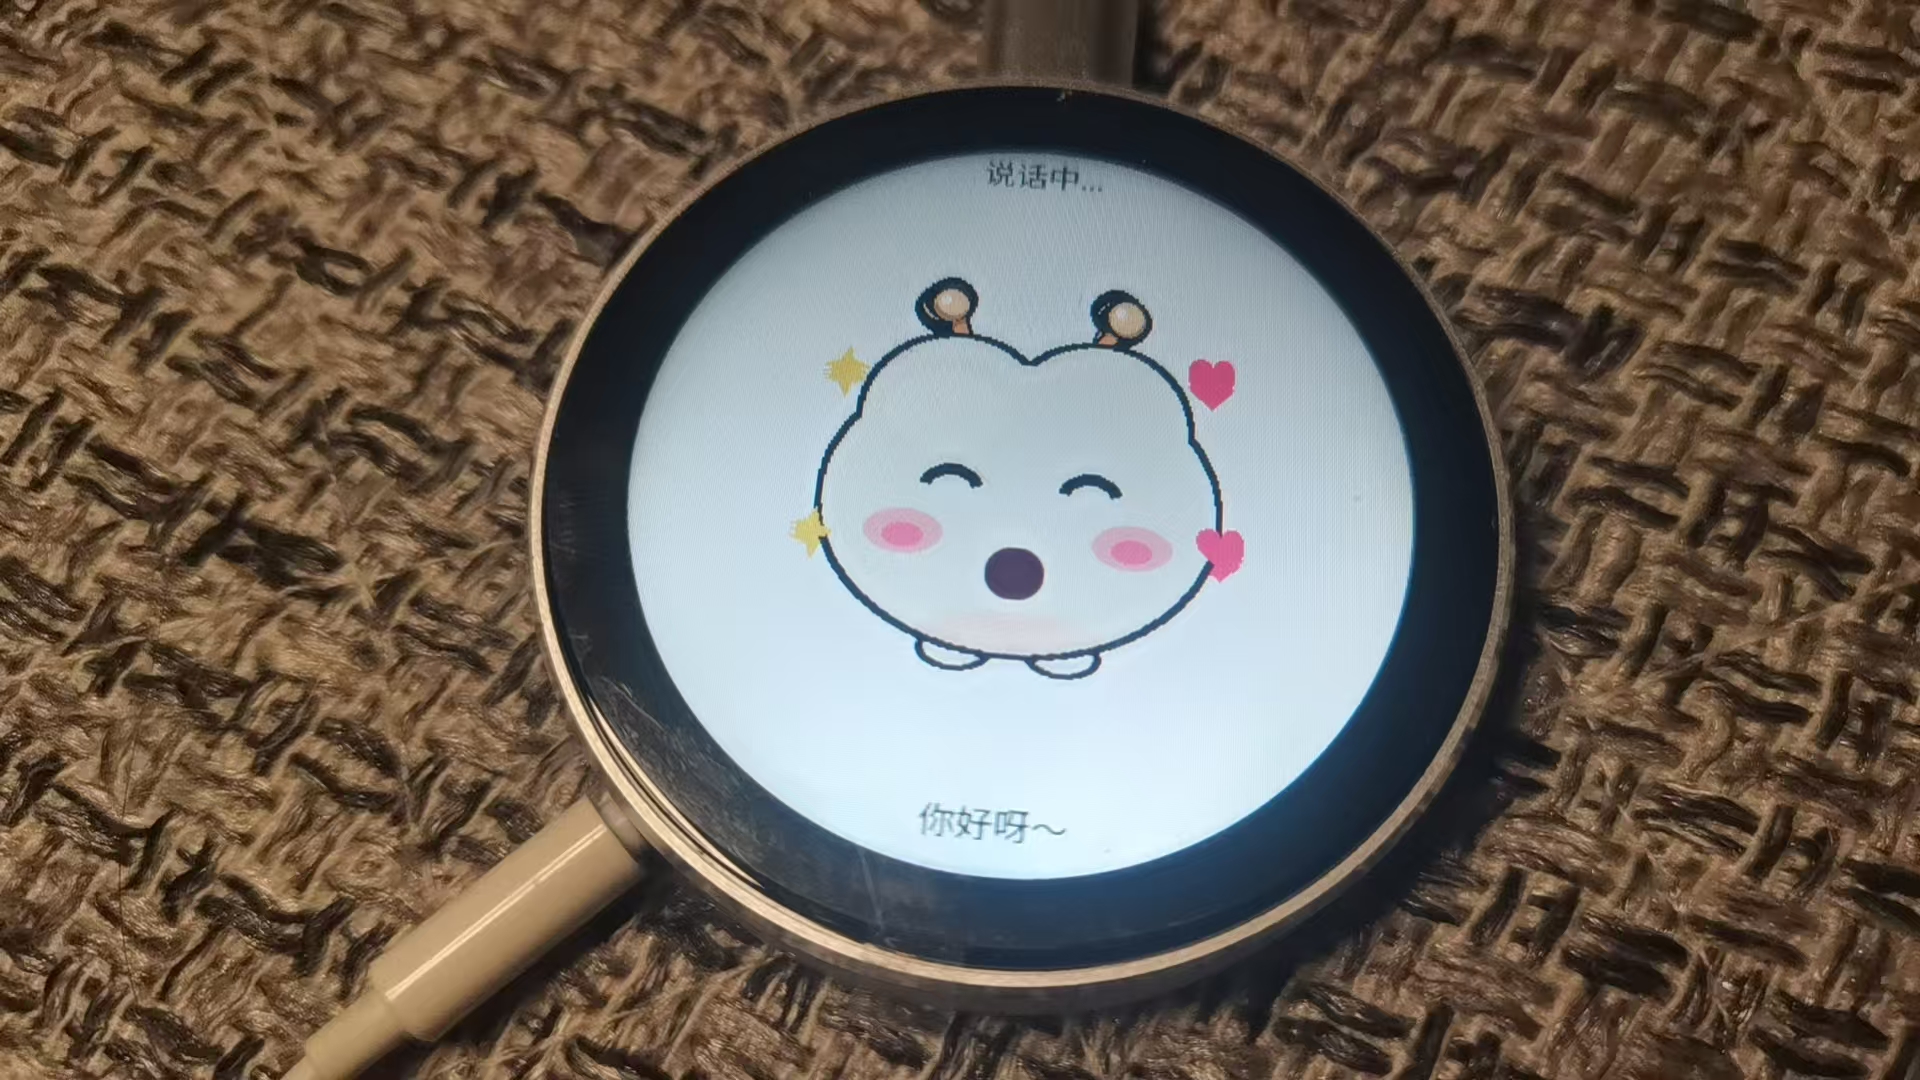
| 小糯 Nuonuo | 奶白云团小精灵,两根会摆的橙色触角、大眼睛、腮红、小短脚 | 深紫红圆形嘴 |
| 格罗克 Grok Bot | 深色圆角机器人,单根发光天线、青蓝屏幕眼(带扫描线)、LED 指示灯 | 青蓝色圆角 LED 条 |
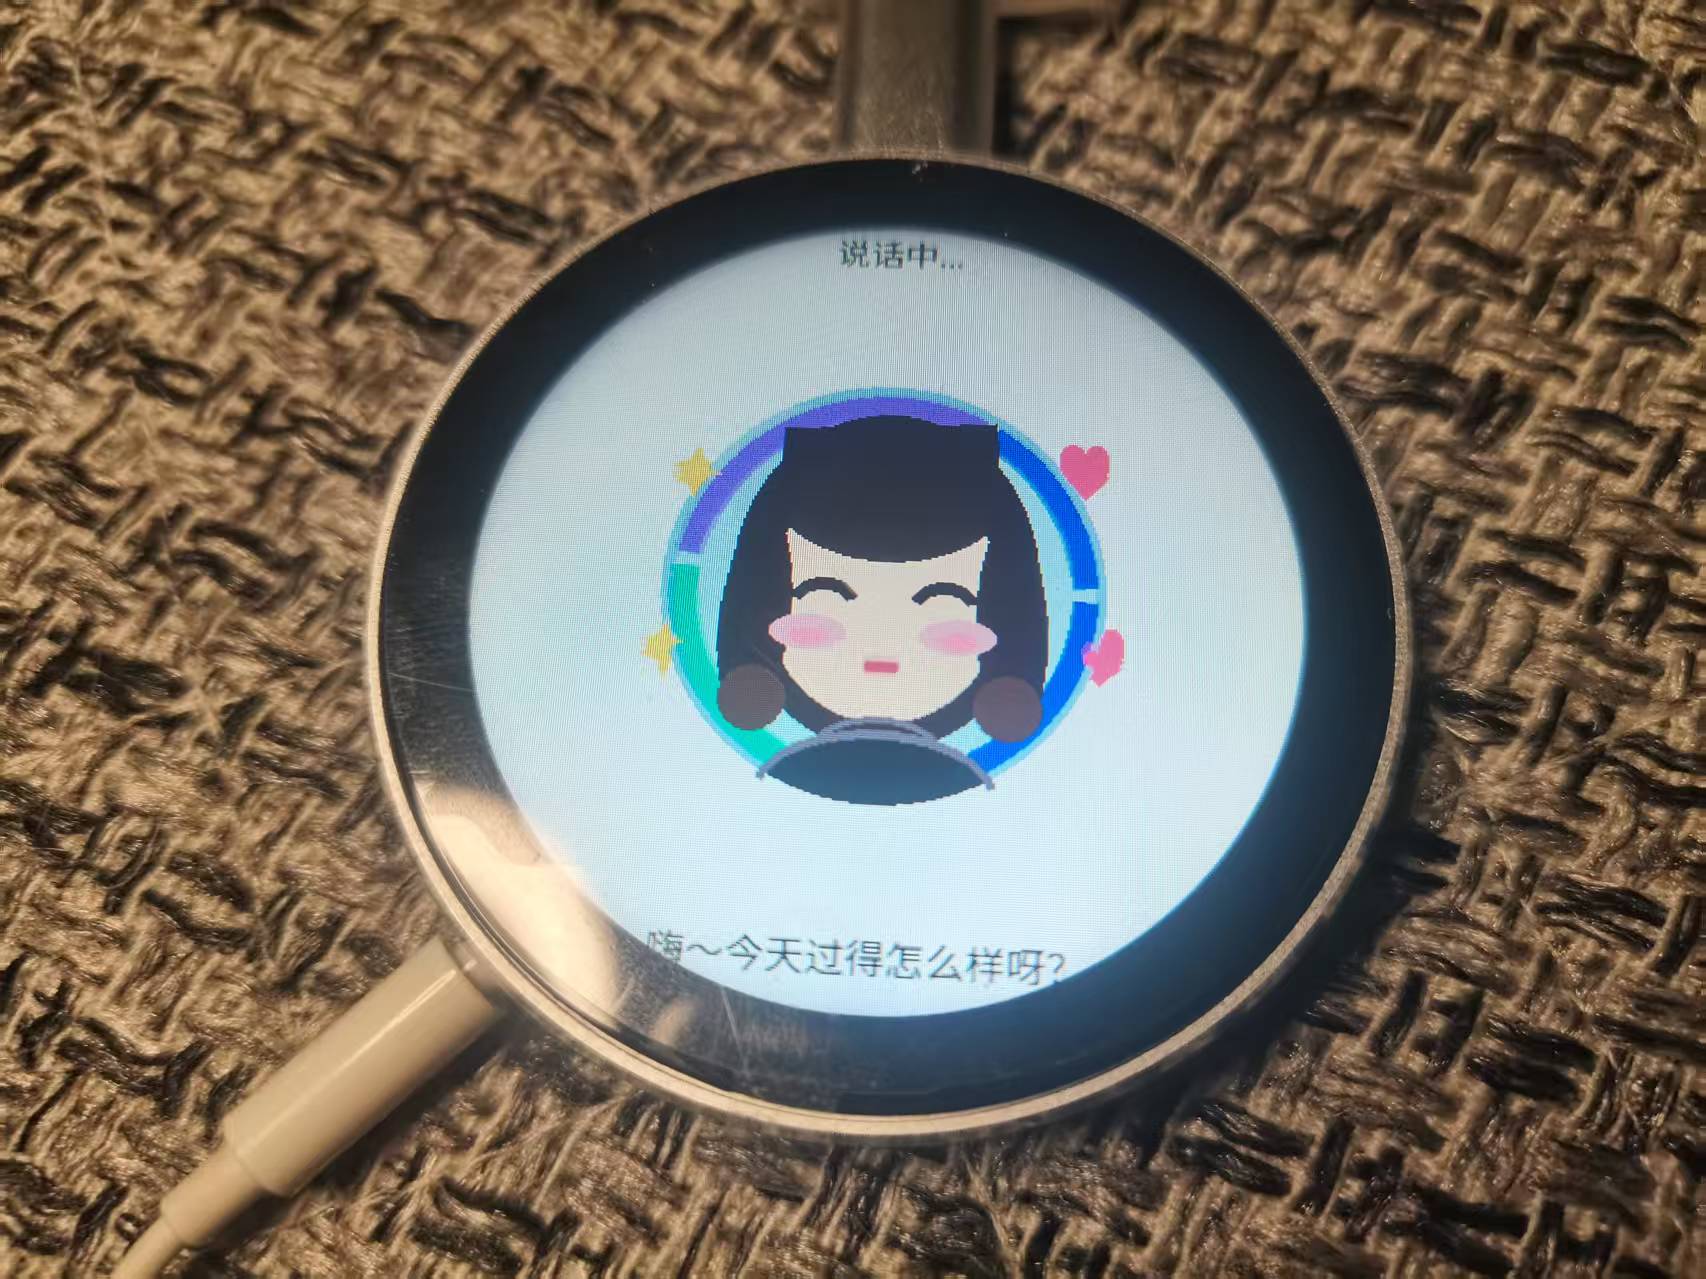
| 豆包 Doubao | 浅蓝圆形徽章 + 紫/蓝/青绿三色丝带环,齐下巴短发、大眼睛、粉腮红、深色圆领上衣 | 豆沙粉圆形嘴 |
每套都有 8 种状态循环动画:
| 状态 | 表现 |
|---|---|
idle 待机 |
呼吸起伏、眨眼、偶尔冒小星星 |
listening 聆听 |
两侧声波 + 发光环 / 天线信号环 |
speaking 说话 |
脸颊声波线、音符 |
thinking 思考 |
眼睛上瞟、头顶思考泡泡 |
happy |
弯月笑眼、放大腮红、星星与爱心 |
sleepy(配网中) |
半闭眼、飘 Zzz |
sad / surprised |
泪滴小雨云 / 四角星光 |
口型是真的跟着声音动的
这部分我最想分享。做法是:GIF 里故意不画嘴,播放时在角色嘴部叠一个 LVGL 对象;在 audio_service.cc 的输出链路里加了一个轻量探针,统计送往 DAC 的 PCM 平均绝对值,再用 lv_timer 每 60ms 读一次幅度,经过指数平滑后映射到嘴的高度:
- 静音 → U 形微笑弧;
- 说话 → 声音大嘴张得大,停顿就闭上;
- 切换皮肤 → 嘴的坐标、颜色、尺寸范围、圆角一起换。
所以它不是「播放固定动画」,而是真正跟 TTS 波形同步,观感差别很明显。探针是全局加在 OutputData() 前后的,对其它板型没有副作用。
待机画面:一只能自动校时的圆形时钟
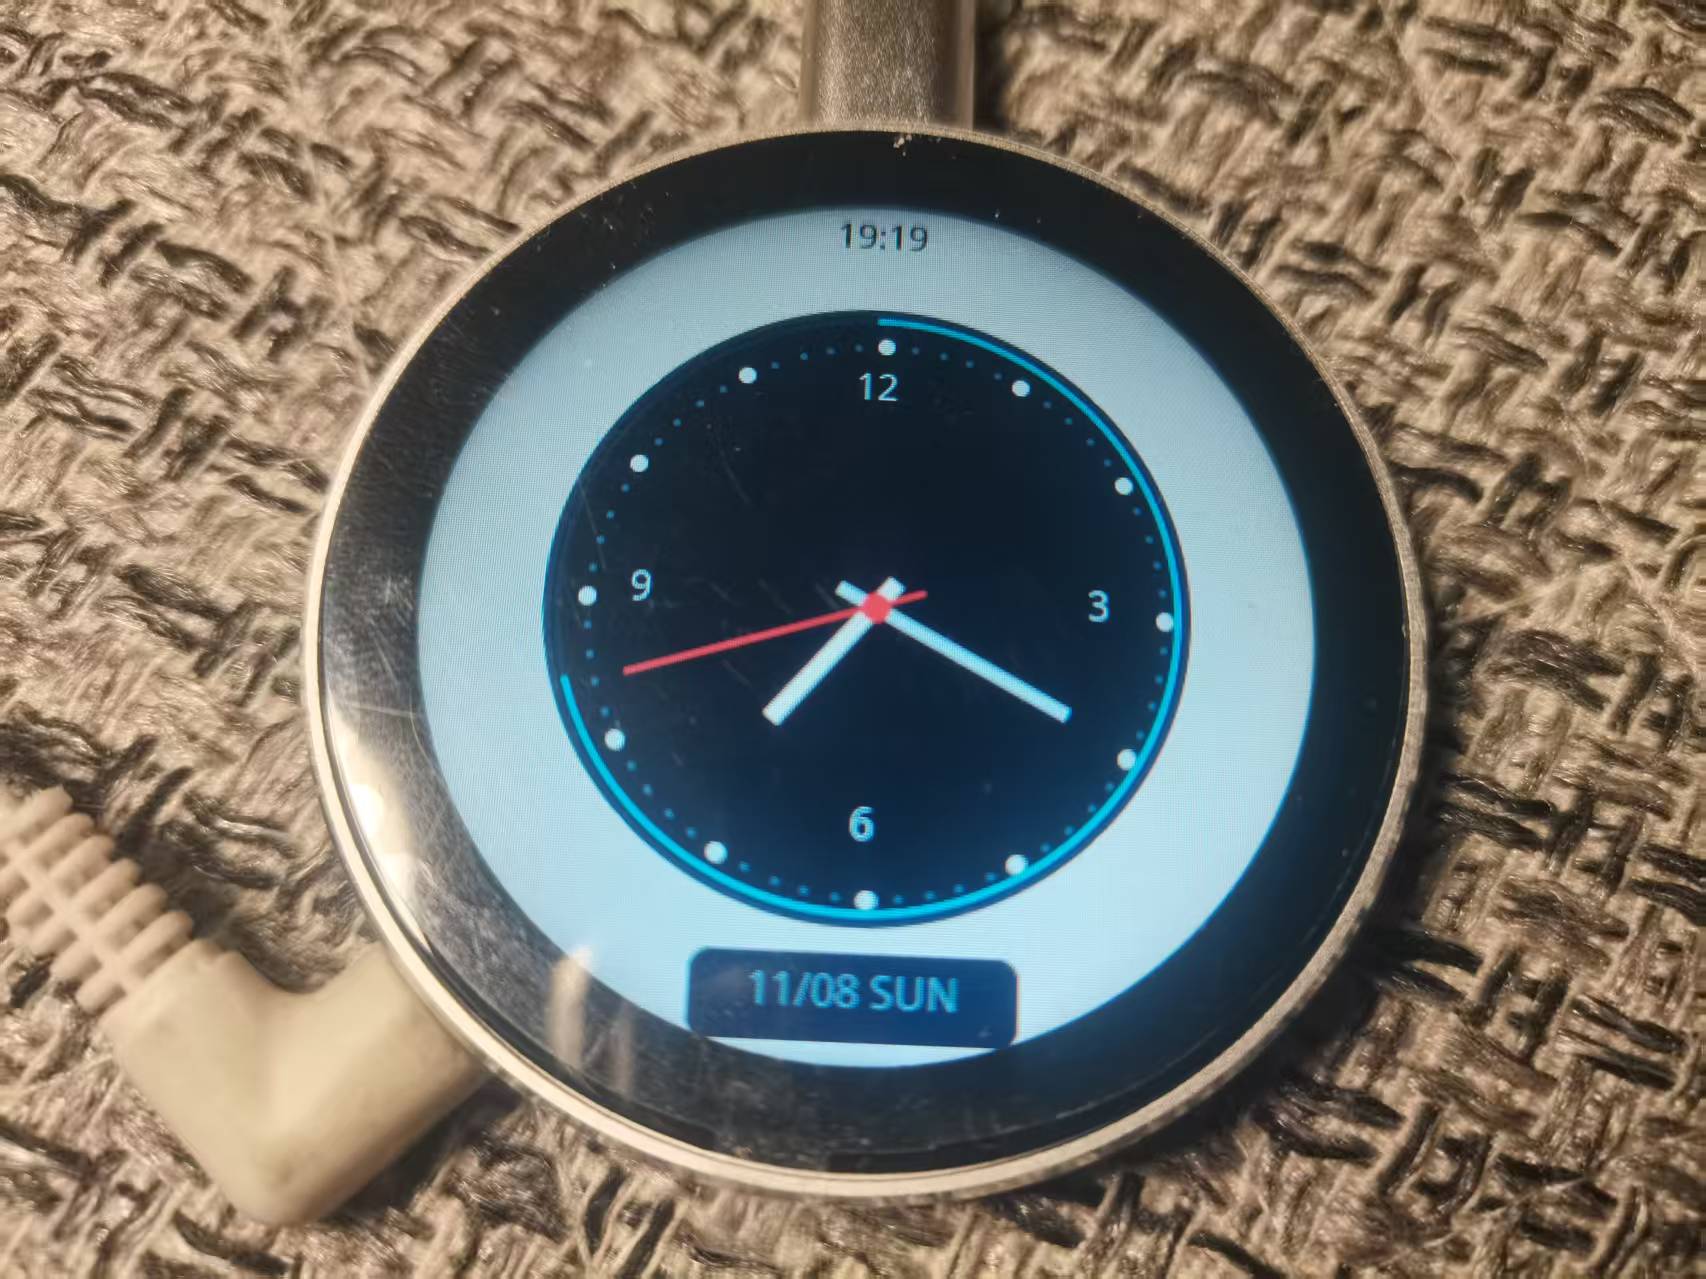
角色再可爱,一直挂在桌面上也容易看腻;而且待机时我更想一眼看到时间。所以后来把 idle 画面整个换成圆形模拟时钟:屏幕中央 260px 表盘,60 个刻度点(整点放大)、12/3/6/9 数字、时分秒三根指针、每秒推进的蓝色秒环。顶部状态栏本来就会显示 HH:MM,表盘里就不再重复;MM/DD WWW 日期星期单独放到表盘下方的屏幕底部,带深色圆角底衬。
| 设备状态 | 画面 |
|---|---|
待机 idle |
圆形时钟,同时暂停 GIF 解码器 |
| 聆听 / 说话 / 思考 / 配网 | 隐藏时钟,回到角色 GIF 与口型 |
| 服务端下发表情、提醒庆祝、切换皮肤 | 临时显示角色约 2.2 秒,结束后自动回到时钟 |
「能正常计时」这件事比画表盘麻烦。 上游 OTA 响应里的 server_time 会写系统时间,但它是把本地墙上时间当作伪 UTC 存进 settimeofday() 的;一旦服务器没下发这个字段,设备就完全没有时间基准。于是 clock_face.h 里又加了一个 ClockTimeSync:WiFi 连上后用 SNTP(ntp.aliyun.com)兜底,取到标准 UTC 后同样加时区偏移再写入,保证时钟、顶部状态栏和提醒显示的时间一致;同步完立刻停掉 SNTP,避免周期性同步把时间改回纯 UTC。没校时时表盘显示 SYNCING、指针停在 12 点,不会拿开机秒数冒充真实时间。默认 UTC+8,改一个宏就能换时区。
指针复用原本驱动口型的 60ms lv_timer,只在 time(nullptr) 的秒值变化时才重设三根线和秒环,平时只做一次整数比较,待机几乎不增加 CPU 负担。
角色资源怎么来的
24 个 GIF(240×240、8 帧、带透明通道、共 214.9 KB)全部由 tools/generate_pet_assets.py 用 Pillow 程序化绘制,不依赖任何外部素材:
pip install pillow
python main/boards/dfrobot/df-s3-1.85-round/tools/generate_pet_assets.py
脚本会重写 pet_gifs/、pet_assets.h 和三张预览图。pet_avatar.h 里的 kPetSkins[] 表同时定义每个皮肤的 GIF 集合和嘴型参数,Python 生成器与 C++ 渲染器共用同一份定义,改一处两边同步。
两个实现细节值得记一下:
- 角色自己管
LvglGif播放器,不挂主题的EmojiCollection—— 设备联网激活后Assets::Apply()会替换表情集合,挂在那里会被覆盖掉,开机就变回默认机器人。 - 生成器共用一张 64 色调色板(0
31 是初版配色、3263 留给豆包),透明索引 64,GIF 全局色表 128 项;确认过gifdec.h的调色板支持 256 项,不需要改解码器。设备端日志也确认 128 项色表解码正常,无failed to decode GIF。
左右滑动换角色
在 LV_EVENT_PRESSED / RELEASED / GESTURE / CLICKED 上做了双路径判定:LVGL 自带手势 + 按下/抬起坐标差(横向 ≥55px 且明显大于纵向),700ms 时间窗去重,避免一次滑动连切两个;滑动会抑制紧随其后的 CLICKED,所以换角色不会误唤醒对话。选择写入 NVS 的 pet/skin,重启后保持。
七、不想装 ESP-IDF?直接烧固件
我把编译产物打包成了 Espressif Flash Download Tool 能直接用的格式,两种方法等价,内容已做逐字节比对校验。
工具设置(关键):
| 项 | 值 |
|---|---|
| ChipType | ESP32-S3 |
| SPI SPEED | 80 MHz |
| SPI MODE | DIO |
| Flash Size | 16 MB |
| WorkMode / LoadMode | Develop / UART |
方式 A(推荐,只填一行):
merged/xiaozhi_dfr1221_16MB_merged.bin → 地址 0x0,文件 16,777,216 B(已按 16MB 全片补齐 0xFF)。如果界面上有 DoNotChgBin 就勾上——镜像头里已经写好了 DIO / 80MHz / 16MB,不需要工具改写。
方式 B(5 个分分区文件):
| 地址 | 文件 | 大小 (B) | 内容 |
|---|---|---|---|
0x0 |
0x00000_bootloader.bin |
16,544 | 二级 bootloader |
0x8000 |
0x08000_partition-table.bin |
3,072 | 分区表 |
0xd000 |
0x0d000_ota_data_initial.bin |
8,192 | OTA 初始数据 |
0x20000 |
0x20000_xiaozhi_app.bin |
2,802,192 | 主程序(含全部新功能与角色 GIF) |
0x800000 |
0x800000_generated_assets.bin |
1,262,753 | 字体 / 表情 / 提示音资源 |
分区布局(partitions/v2/16m.csv):nvs 0x9000、otadata 0xd000、phy_init 0xf000、ota_0 0x20000 (0x3f0000)、ota_1、assets 0x800000 (8M)。
等价的 esptool 命令:
esptool.py --chip esp32s3 --port COM10 --baud 921600 \
  write_flash --flash_mode dio --flash_freq 80m --flash_size 16MB \
  0x0 merged/xiaozhi_dfr1221_16MB_merged.bin
两个注意点:
- 整片 16MB 镜像会清空 NVS / WiFi 配网,烧完按小智标准流程重新配网即可;只想升级程序时,单独烧
0x20000那一行,配网信息就不会丢。- 角色 GIF 是编进 app 分区的,所以换形象不需要重烧
0x800000资源分区。
配图建议:放 Flash Download Tool 配置界面截图(能看到 5 行地址和 80MHz / DIO 设置)与
FINISH完成截图。
八、实测数据与当前状态
| 验证项 | 结果 |
|---|---|
| 启动日志 | ST77916 初始化成功、CST816S 识别(IC id 182)、背光、PDM + PCM5100A、AFE 唤醒词、WiFi / MQTT 激活均正常 |
| 工具注册 | 14 tools registered: 7 visible to the model,3 个提醒工具对云端 LLM 可见 |
| 角色解码 | PetAvatar: avatar ready: 3 skins x 8 state GIFs, active=豆包 Doubao,无解码失败 |
| 提醒链路 | 语音设置 → 到点触发 → 查询 → 取消,全部闭环 |
| 内存 | 空闲内存稳定在 141~145 KB |
| app 分区 | 2,802,192 B,剩余 32% |
| 稳定性 | 长时间监听无 panic、无重启循环;仅出现过一次 MQTT 瞬时超时,设备自动重连恢复 |
九、Windows 编译踩坑速查
如果你打算自己改代码重新编译,这几个坑我都踩过:
| 现象 | 原因与解法 |
|---|---|
| 工具链 exe 无法启动 / 被 SmartScreen 拦截 | 下载包带 MOTW 标记,用 Unblock-File 批量解除;工具链版本要对齐 esp-15.2.0_20251204 |
CreateProcess failed |
IDF 的 ccache、ninja 目录没进 PATH,export PATH=...:$PATH 补上 |
| 命令行超过 32767 字符导致链接失败 | 给 build.ninja 打补丁清空超长 INCLUDES,或 cmake -D CMAKE_NINJA_FORCE_RESPONSE_FILE=ON -S . -B build,也可直接缩短工程路径 |
偶发 as.exe 报 DLL 加载失败、ldgen 调 objdump.exe 报文件被占用 |
Windows 瞬时 DLL / 文件占用,重试即过,与代码无关 |
烧录到一半 PermissionError |
会留下半套固件导致反复复位,用重试循环 + --connect-attempts 20 完整重烧 |
还有一条设计上的取舍:reminder.h / pet_avatar.h 的实现刻意放在头文件里。因为板目录的 *.cc 由 CMake glob 收集,新增 .cc 会强制 CMake 重新配置,把上面那个 build.ninja 补丁覆盖掉。等用 CMAKE_NINJA_FORCE_RESPONSE_FILE=ON 重新配置过工程,就可以把它们拆成规范的 .cc。
十、源码与资源
- 完整工程(含板型源码、角色生成脚本、构建配置):Gitee 仓库 yuntian365/xiaozhi-dfr1221
- 可直接烧录的固件:仓库
firmware/flash_download_tool/目录,或打包好的xiaozhi_dfr1221_flash_download_tool.zip(约 5.1 MB) - 目录速查:
main/boards/dfrobot/df-s3-1.85-round/— 板型全部源码、引脚表、角色资源与生成脚本main/audio/audio_service.h/.cc— 音频播放幅度探针main/Kconfig.projbuild/main/CMakeLists.txt— 板型注册firmware/flash_download_tool/— 合并镜像、分分区 bin、flash_args.txt、sha256.txt、烧录说明
- 仓库里保留了
sdkconfig与dependencies.lock,克隆后无需重新 menuconfig 就能复现本次固件;build/和managed_components/不入库。 - 仓库内不含任何 WiFi 账号、API Key 或账号口令。
十一、总结与下一步
从「Wiki 里没有能直接用的源码」到「一块能语音聊天、会提醒我喝水、还会跟着声音张嘴的圆屏小伙伴」,这个项目把 DFR1221 在小智 AI 生态里的最后一块拼图补上了。整个适配没有改动任何已有板型的引脚配置,避免 OTA 串版,其它板子照常编译。
回头看,最花时间的不是写驱动,而是三件小事:把引脚从原理图里抠全、想明白「触摸输入设备 ≠ 点击唤醒事件」、以及让 24 个 GIF 在 8MB PSRAM 的约束下既好看又不炸色表。
接下来还想在几处继续打磨:
- 实拍确认滑动手感、屏幕方向与外接音箱听感,把参数调到更顺手;
- 板上的 TF 卡和 Qi 无线充电目前没启用,可以做本地提示音/表情扩展和真正的桌面无线供电;
- 若能接一个轻量本地 TTS,提醒就能完全离线语音播报;
- 角色生成器可以做成配置文件驱动,方便大家画自己的形象。
如果你也有一块 DFR1221,欢迎直接烧来试,也欢迎在评论区交流你画的角色。代码和固件都开源,改坏了重烧 0x20000 就能回来。
许可与致谢:本项目基于开源项目 xiaozhi-esp32,许可证沿用上游
LICENSE。
硬件资料参考 DFRobot 官方 Wiki、原理图与ST77916_LVGL_DEMO示例;屏幕初始化命令与官方scr_st77916.h一致。
三个角色形象均为程序化绘制的原创 Q 版设计,仅作个人学习与交流使用,未使用任何第三方品牌素材,相关商标归各自权利人所有。