这一瓶,我能喝吗 ——面向慢性病人群的饮品识别与饮用提示装置
这一瓶,我能喝吗
——面向慢性病人群的饮品识别与饮用提示装置
做中学·探未来|科学教育实践案例 方向六:人工智能
作品信息
项目 | 内容 |
作品名称 | 这一瓶,我能喝吗——面向慢性病人群的饮品识别与饮用提示装置 |
主题方向 | 方向六:人工智能(图像识别、数据库比对、网络通信) |
适用学段 | 小学高年级(5—6 年级) |
使用对象 | 患有糖尿病、高血压、痛风等慢性病、需要控制饮品选择的老年人 |
硬件 | 掌控板(ESP32,板载 128×64 屏)、手机或摄像头、一台电脑 |
软件 | Python 3(VS Code 编写)、Mind+(掌控板图形化编程) |
识别服务 | 百度 AI 图像识别开放接口(返回名称、置信度、热量) |
自建数据 | 三层数据表:饮品库 foodDB/病人库 personDB/禁忌库 ban |
一、项目介绍
1.1 一个每天发生几百次的判断
项目最初的那张照片,是在便利店的冰柜前拍的:一位老人伸手去够最里面的一瓶饮料,身体侧着,手臂伸到最长。他要做的判断其实只有一句话——“这一瓶,我能不能喝”。
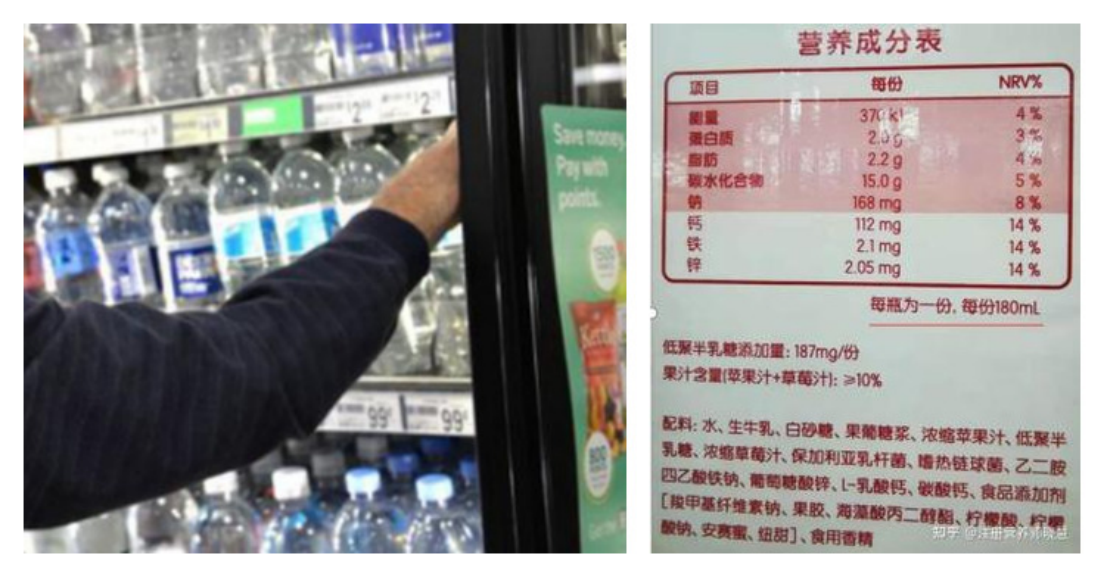
图 1 左:便利店里,选购一瓶饮料要先把它从货架深处够出来;右:瓶身背面的配料表,字号比正文小一半,还要在冷柜灯光下辨认
可是要回答这句话,他得先做完三件事:把瓶子从货架深处够出来、把背面那一片小字看清、再把“碳水化合物”“钠”“配料表”这些词翻译成“我这种病能不能碰”。三件事里任何一件失败,这个判断就做不成。
第二件事比想象中更难。图 1 右侧那张配料表照片,是按真实瓶身拍的:项目符号、括号、“低聚半乳糖”“羧甲基纤维素钠”这类名词挤在一起,成年人也要凑近才看得清。调研时我们发现,便利店的主要客流偏年轻,商家没有动力为老年人放大字号——这是成本问题,很难靠“请商家改包装”解决。
第三件事则完全依赖知识。项目在调研阶段整理了六类常见慢性病与饮品的关系:骨质疏松的人不宜多喝咖啡和碳酸饮料,糖尿病和肾病患者要避开果汁,痛风患者要避开啤酒和酸奶,经常反酸腹胀的人不宜喝可乐和牛奶,牙齿不好的人要避开苹果醋和柠檬汽水。这些知识在科普文章里都能查到,但没有人会在冰柜前把它背出来。
于是问题变成:能不能让机器替老人把这三件事一次做完——拍一下,就告诉他这一瓶能不能喝?
1.2 我把问题拆成了四个可以测量的疑问
“做个能判断饮料的装置”这句话太大,没法验证。我把它拆成四个能用“对/不对”回答的问题,后面所有测试都围绕这四个问题展开:
编号 | 探究问题 | 怎么判断答对了 |
Q1 | 拍一张照片,机器能不能说出这是哪种饮品? | 对图片库和实物各拍若干次,看返回的第一个名称是否正确 |
Q2 | 认出来的名字,能不能对上“这种病不能喝”的名单? | 把结论与禁忌表逐条比对,看是否一致 |
Q3 | 名单里没有的饮品,会不会被误判成“不能喝”? | 用未列入禁忌的组合测试,看是否输出“可以适量饮用” |
Q4 | 结论能不能送到老人手里那块小屏上? | 看掌控板三行显示是否与电脑端结论一致 |
1.3 它怎么用:三个动作
整套装置由三部分组成:一块掌控板(负责显示)、一部手机或一个摄像头(负责拍照)、一台电脑(负责识别和查库)。老人只需要记住三个动作。
· 拍一下 把手机镜头对准瓶身,拍一张照。照片存进电脑上一个固定的文件夹,程序从这个文件夹里取图。
· 认出来 电脑把照片传给百度 AI,取回排名第一的饮品名称和它的置信度;再问一句“您是哪位”,从病人库里调出这个人的病症列表。
· 看屏幕 程序在禁忌库里查“这种病忌哪些饮品”,把饮品名、命中的病症和结论三行字,通过 Wi-Fi 送到掌控板的小屏上。
之所以做成“屏幕显示”而不是“语音播报”,是因为这个装置的使用场景在超市和便利店里——环境嘈杂,语音容易被盖住;而屏幕可以凑近看,也不打扰旁人。这一点和市面上常见的语音导购设备正好相反,是调研之后改的。
1.4 背后的五条原理
这台装置看起来只是“拍照—查表—显示”,但每一段背后都有一件可以用课上学过的知识解释清楚的事。
(1)机器看到的不是“可乐”三个字
照片在计算机里是一个数字表格:每个像素存着红绿蓝三个亮度值。机器一开始并不知道“瓶子”“标签”“液体”是什么,它只是在一层层地找规律——最底层找边缘和色块,往上一层把边缘组合成纹理和圆弧,再往上一层组合成“瓶盖”“标签”“罐身”这样的部件,最后才给出“这是一听可乐”的判断。这就是深度卷积网络做的事。
这类任务还分几种:只回答“是什么”叫分类;既回答“是什么”又框出“在哪里”叫检测;把每个像素都标出属于哪个物体叫分割。我们这个装置只需要分类——因为规则是“只拍单个饮品”,画面里只有一样东西,不需要定位。把任务限定得窄一点,识别就稳一点,这是设计时特意做的取舍。
(2)0.899 是“最高分”,不是“及格线”
接口返回的不只是名字,还有一个 0 到 1 之间的数,叫置信度。实测时,一听可乐返回的结果是“可乐 0.899”。这个数字不是“89.9% 的概率一定是可乐”,而是模型在它见过的所有类别里,认为“可乐”这一项的相对得分最高。
程序里写的是 res[0],也就是永远取第一名。这意味着:只要第一名错了,程序自己并不知道,还会拿着错名字去查库、给出一个看起来很确定的结论。所以正确的做法是加一条门槛——置信度低于某个值就提示“没看清,请重拍”,而不是硬给一个答案。这一条已列入第六章的改进项。
(3)三张表为什么要拆开
如果只用一张表,把“谁、什么病、什么饮料、能不能喝”全写在一行里,会有两个麻烦:同一个人要重复写很多行,同一种饮料的说明也要重复写很多遍,改一处就得改一片。
所以我拆成三张表,用“名字”把它们串起来:饮品库存“饮品名→主要特点”,病人库存“姓名→病症列表”,禁忌库存“病症→不宜饮品的名单”。查一次的顺序是:先由饮品名查到特点,再由姓名查到病症,最后由病症查到禁忌名单,看这个饮品在不在名单里。改饮品的特点,不影响病人;加一个病人,也不用动饮品表。这就是数据库里“拆表”和“用键关联”的基本思路。
在 Python 里,这三张表用字典(dict)实现。字典的好处是查一次就能直接定位,不用从头到尾翻一遍——病种从 7 类扩到 70 类,查询时间几乎不变。
(4)最脆弱的一环:字符串要一模一样
判定那一行代码写的是“如果这个名字在禁忌名单里”。计算机比的是字符串是否完全相同:“可乐”和“可口可乐”在它眼里是两个不同的东西。
这是整个项目最脆弱的地方。识别率再高,只要接口返回的名字和数据库里写的差一个字,判定就会落空,而且落空的方式很隐蔽——它不会报错,只会输出“您可以适量饮用”,看起来一切正常。所以后面要做的不是继续提高识别率,而是补一张“别名表”,把“可口可乐/零度可乐/可乐”都指向同一个条目。
(5)三行字怎么从电脑走到小屏
电脑和掌控板之间用 Socket 通信,走的是 TCP 协议。电脑当服务端:先建一个套接字,绑定本机 IP 和端口 5001,然后开始监听;掌控板当客户端,连上这个地址后,双方就能互相收发数据。
程序的写法是“发一条、等一句回执”:电脑发一次结论,掌控板收到后回一句“received”,电脑收到回执再发下一条。这样做的好处是三条信息不会粘在一起——如果连续快速发送,TCP 可能把它们合并成一包,屏幕上就会显示成一堆乱字。
1.5 配料表上真正该看的三行
装置判断的是“这种饮品适不适合这种病”,但背后的依据其实来自瓶身背面的配料表。调研时我把配料表上和慢性病关系最大的三处整理了出来:
看哪里 | 为什么看这里 | 与哪种病相关 |
营养成分表里的 | 这一栏基本就是含糖量,直接决定喝下去以后血糖升多快 | 糖尿病、高血糖、高血脂 |
营养成分表里的 | 钠高就是盐多,盐摄入过多会推高血压 | 高血压、肾病 |
配料表的排序 | 配料按含量从高到低排列,排在前三位的才是主要成分;“果汁饮料”和“果汁”的区别就藏在这里 | 糖尿病、痛风(判断是否含果糖、酒精) |
还有几个词值得单独记住:咖啡因(咖啡、浓茶、部分功能饮料)、磷酸(可乐类碳酸饮料)、乳酸(酸奶)、嘌呤(啤酒)。这些词不会直接写“对某某病不好”,但它们正是禁忌表里那些条目的来源。
1.6 对应哪些课程内容
学科 | 对应内容 |
科学 | 人体的消化与吸收;慢性病与生活方式的关系;溶液的浓度与“每 100 mL”的含义 |
信息科技 | 图像识别的基本过程;用表格与字典组织数据;顺序、分支与循环;网络通信与协议 |
劳动 / 综合实践 | 器材连接与调试;用工具解决生活中的实际问题;产品测试与迭代 |
道德与法治 / 健康 | 关注身边的老年人;对自己的健康负责;理解“提示”与“医嘱”的边界 |
二、运行演示
2.1 成品:一块板、一部手机、一台电脑
整套装置没有外壳,也不需要外壳——它由三件现成的东西组成:掌控板负责显示,手机负责拍照,电脑负责识别和查库。图 2 是一次测试前的桌面:左边一排是准备测试的饮品,屏幕上显示着装置的开机界面。
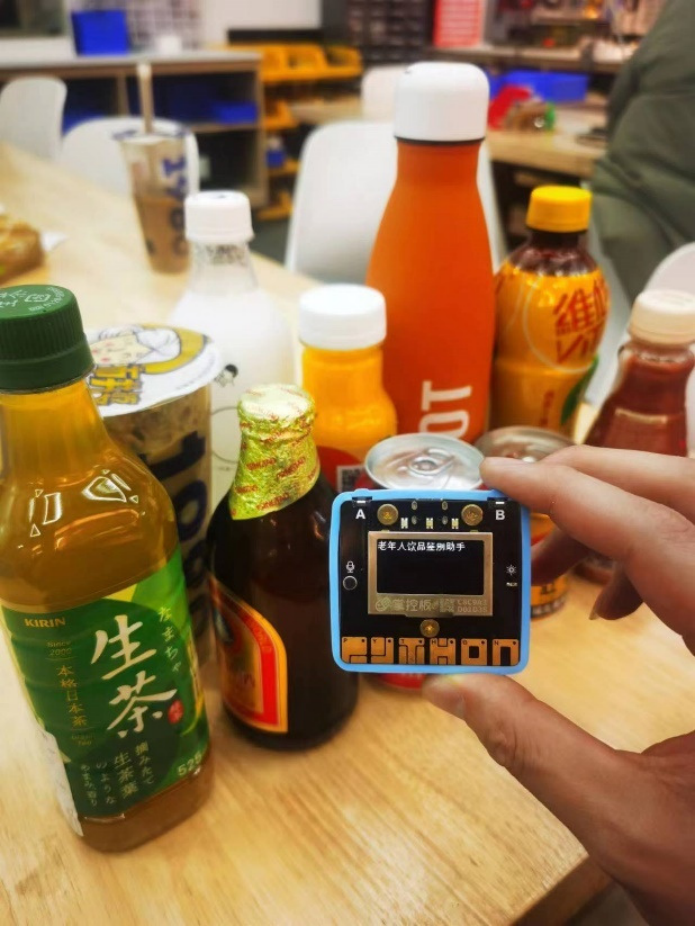
图 2 测试桌面:一排待测饮品与掌控板(屏幕为装置开机界面)
2.2 拍:把瓶子对准镜头
拍摄不需要专门的相机,用手机拍完传进电脑的指定文件夹即可;也可以把 USB 摄像头固定在支架上,对着桌面拍。图 3 左侧是一次实拍:手机屏幕上已经框住了罐身,右侧是云端返回的结果面板——名称“可乐”,置信度 0.899。
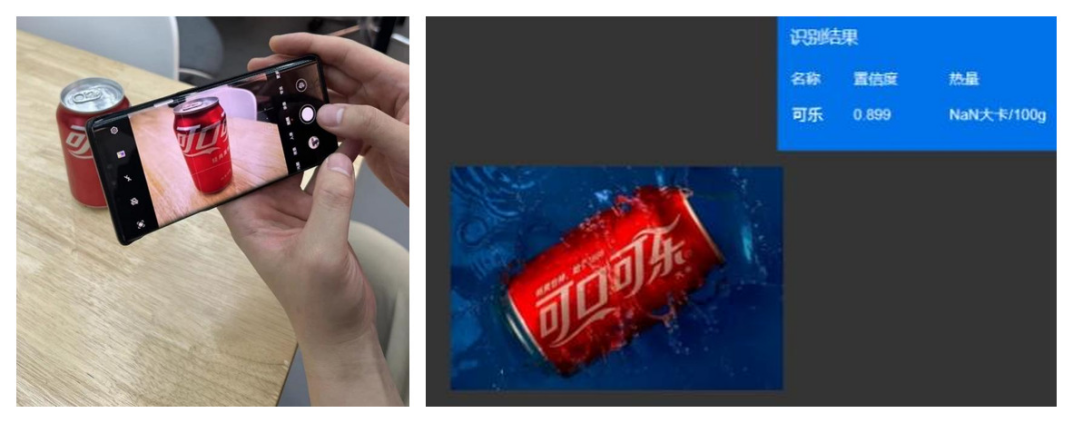
图 3 左:用手机拍下罐身;右:云端返回的结果面板,第一候选为“可乐”,置信度 0.899
2.3 认:云端给出的不只是名字
接口一次返回五个候选,每个候选带名称、置信度和热量。程序只取第一个名称,把它写进变量 res[0],后面的判定全部围绕这个名字进行。
这里有一个当时没想到的情况:可乐这类饮品,接口能给出名称和置信度,但“热量”一栏返回的是“NaN”,也就是没有数值。原因大概是这类包装饮料不在它的营养成分库里。这件事直接改变了项目的走向——原本打算“让接口顺便算出含糖量”,最后改成“自己建禁忌表,把判断权留在自己手里”。详见第六章。
2.4 看:屏幕上的三行字
判定结果通过 Wi-Fi 送到掌控板,屏幕分三行显示:第一行是饮品名,第二行是命中的病症,第三行是结论。下面两组照片是同一套流程在不同饮品上的实拍。
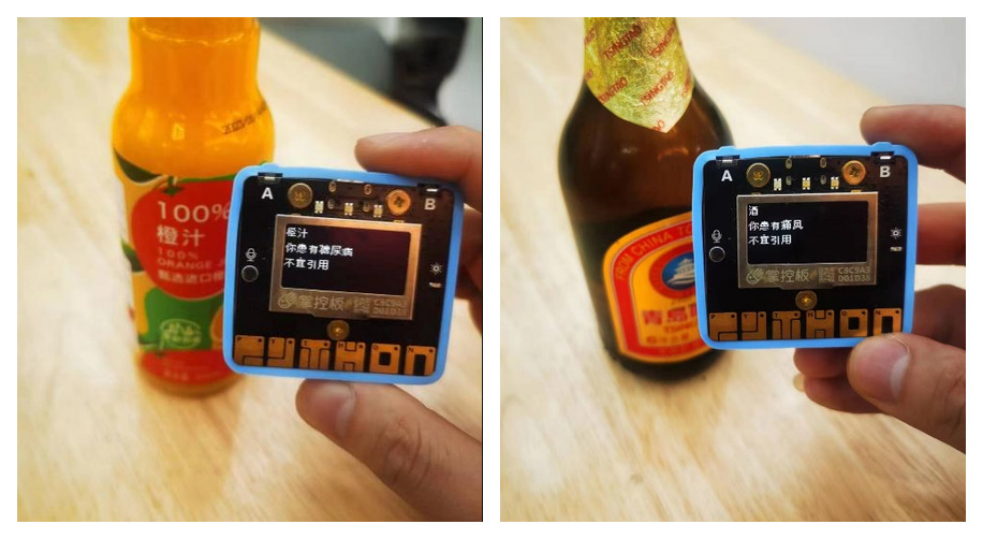
图 4 左:橙汁——屏幕显示“橙汁/您患有糖尿病/不宜饮用”;右:啤酒——屏幕显示“酒/您患有痛风/不宜饮用”
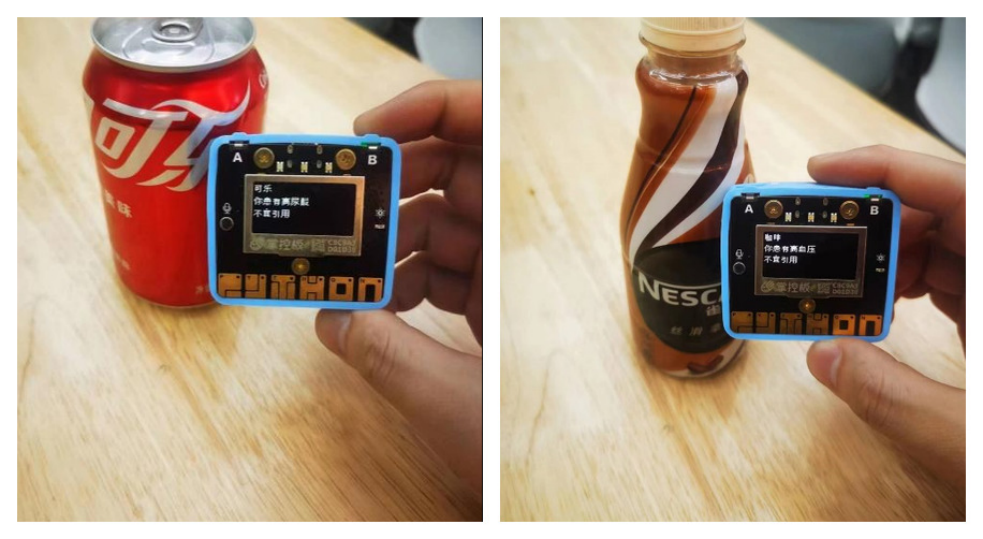
图 5 左:可乐;右:雀巢咖啡——屏幕显示“咖啡/您患有高血压/不宜饮用”。四组照片覆盖了塑料瓶、铝罐、玻璃瓶三类包装
2.5 四组实测的结果
序号 | 饮品 | 包装 | 使用者病症 | 屏幕第二行 | 与禁忌表是否一致 |
1 | 橙汁 | 塑料瓶 | 糖尿病 | 您患有糖尿病 | 一致(糖尿病忌果汁) |
2 | 可乐 | 铝罐 | 高尿酸 | 您患有高尿酸 | 一致(高尿酸忌可乐) |
3 | 咖啡 | 塑料瓶 | 高血压 | 您患有高血压 | 一致(高血压忌咖啡) |
4 | 啤酒 | 玻璃瓶 | 痛风 | 您患有痛风 | 一致(痛风忌酒类) |
三、探究过程与结果
3.1 先查资料:哪些病要忌哪些饮品
动手之前我先做了一轮资料整理。资料来源是公开的医学科普文章和饮食指导,筛选标准是“说清了原因、能对应到具体饮品”。最后留下五条,作为禁忌表的第一批内容:
相关病症 | 不宜的饮品 | 原因(整理自公开资料) |
骨质疏松 | 咖啡、碳酸饮料(芬达、美年达等) | 咖啡因会增加钙的流失;碳酸饮料中的磷酸会影响钙的吸收 |
糖尿病 / 肾脏疾病 | 果汁 | 果汁含大量糖分,升血糖快;榨汁后膳食纤维损失,饱腹感也差 |
痛风 | 啤酒、酸奶 | 啤酒使尿酸升高、诱发痛风;酸奶含乳酸较多,会阻碍尿酸排出 |
反酸、腹胀 | 可乐、牛奶 | 可乐会加重胃扩张;空腹喝牛奶易诱发消化道不适 |
牙齿不好 | 苹果醋、柠檬汽水 | 酸性饮品会加剧牙釉质酸蚀 |
把零散的条目整理成表之后,我又做了一步:把它们排成一张“病症×饮品”的矩阵。
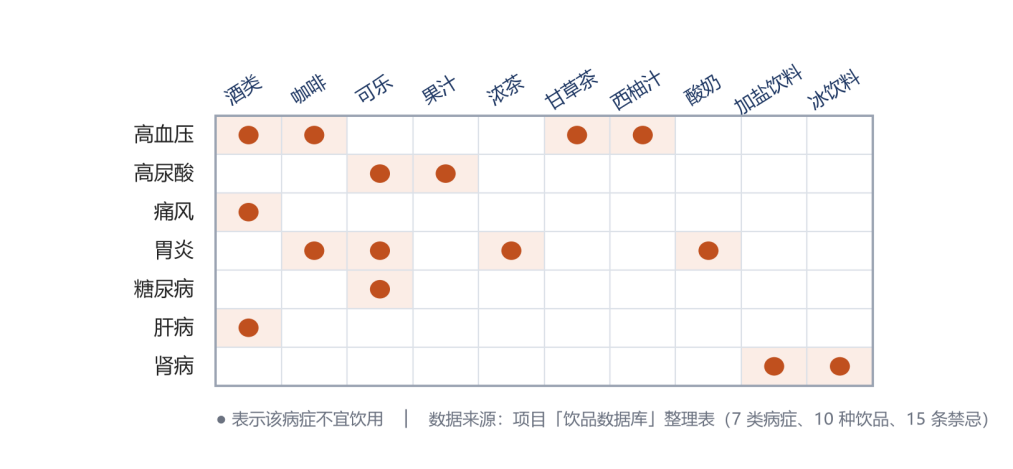
图 6 病症与饮品禁忌矩阵:列为饮品、行为病症,圆点表示该病症不宜饮用该饮品(7 类病症、10 种饮品、15 条禁忌)
排成矩阵的好处是一眼就能看出哪些饮品被多种病同时列为禁忌——可乐出现了三次,酒类出现了三次。这两个是“高风险项”,值得在提示时优先说。
3.2 画方案:从博物馆的导览机想到的
方案卡住过一阵。难点在于:老人不可能记住几十种饮品和十几种病的组合,而装置又不能替他去问医生。直到一次去博物馆,看到自助导览机,才想通。
导览机的逻辑很朴素:走近展品 → 输入编号 → 听到解说。它没有“智能”,但它把“需要知识才能回答的问题”变成了一次查询。而且它把答案放在使用者手里,不需要麻烦别人,也不需要工作人员一直在场。
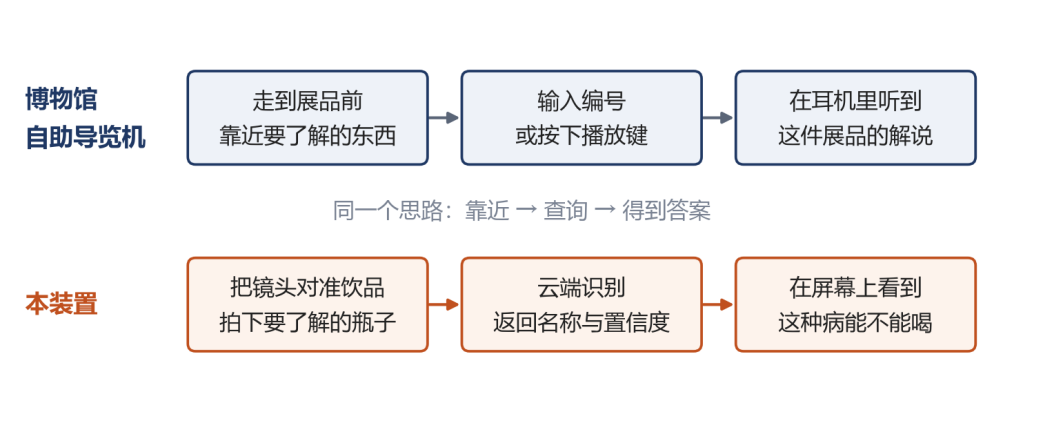
图 7 从导览机到本装置:同样是“靠近—查询—得到答案”,只是把“编号”换成了“一张照片”
顺着这个思路,装置被拆成三段:拍得到(拍照与传输)、判得准(识别与查库)、看得见(屏幕显示)。三段各自可以单独测试,出了问题也知道去哪一段找。
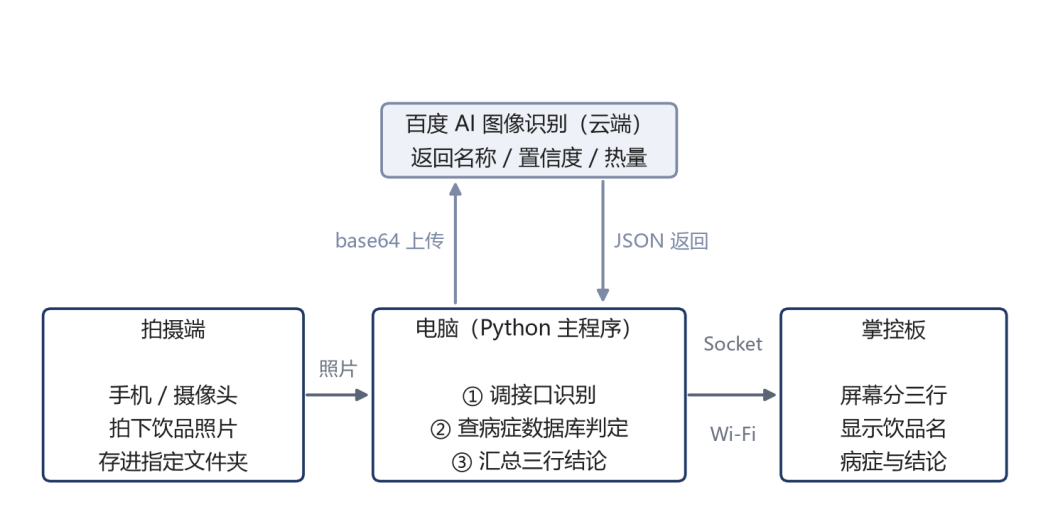
图 8 系统结构:拍摄端只负责出图,电脑负责识别与判定,云端只提供名称,掌控板只负责显示
3.3 建数据库:三张表怎么落地
按 1.4 的思路,三张表分别命名为 foodDB、personDB、ban,写在 dataBase.py 里,用字典存放。截图左侧的文件列表就是测试用的图片库,右边是三张表的全部内容。
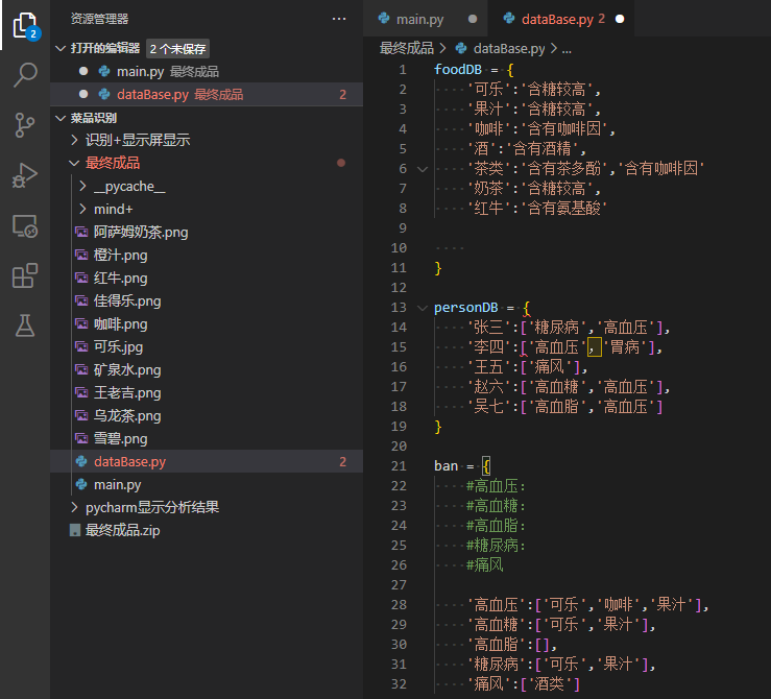
图 9 dataBase.py 中的三张表:foodDB 记录特点,personDB 记录每个人的病症,ban 记录每种病忌哪些饮品
库名 | 变量名 | 存什么 | 首版条目 | 例子 |
饮品库 | foodDB | 饮品名 → 主要特点 | 7 条 | “可乐”: “含糖较高” |
病人库 | personDB | 姓名 → 病症列表 | 7 人(化名) | “张三”: [“糖尿病”, “高血压”] |
禁忌库 | ban | 病症 → 不宜饮品名单 | 5 类 | “糖尿病”: [“可乐”, “果汁”] |
整理时发现的第一处不一致:图 9 的禁忌库里只有 5 类病症(高血压、高血糖、高血脂、糖尿病、痛风),而 3.1 的矩阵整理出 7 类(另有高尿酸、胃炎、肝病、肾病)。两套分类的口径不同——前者按体检指标分,后者按病种分。这在程序里不会报错,但会让同一个使用者被归到不同的库里。这一项必须在扩充数据前先统一,否则数据越加越乱。
3.4 写程序:先识别,再判定,最后发出去
主程序只有一个文件 main.py,三个函数按顺序调用:recognize() 负责识别,analyse() 负责判定,connect() 负责把结果发给掌控板。这样拆的好处是调试时可以一次只跑一段——先把识别调通、打印出 res[0],再单独测判定,最后才接上通信。
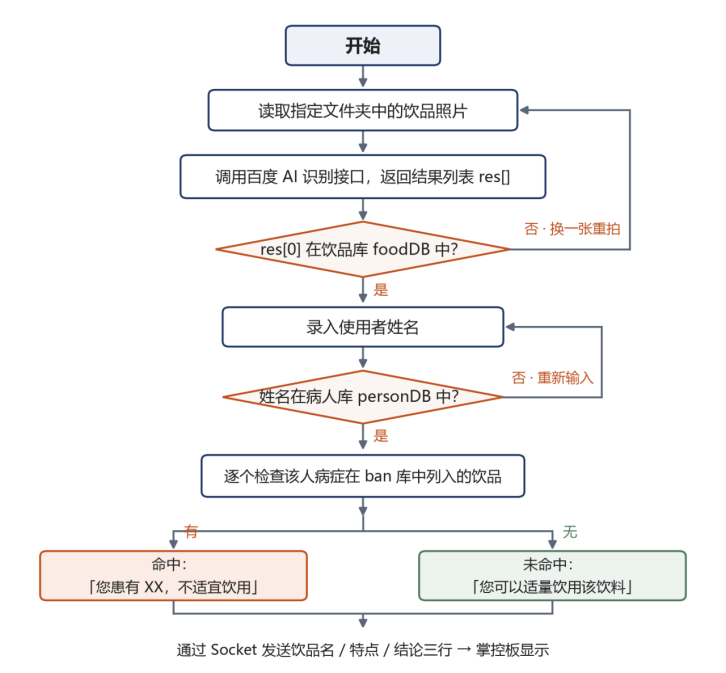
图 10 判定流程:识别→查饮品库→录入姓名→查病人库→查禁忌库→给出结论,两个“否”分支分别回到重拍和重新输入
掌控板那一端用 Mind+ 的图形化积木写:连上 Wi-Fi 热点,建立 Socket 连接,然后在循环里连续三次“接收—显示—回执”,把三条信息分别写进屏幕的第 1、2、3 行。
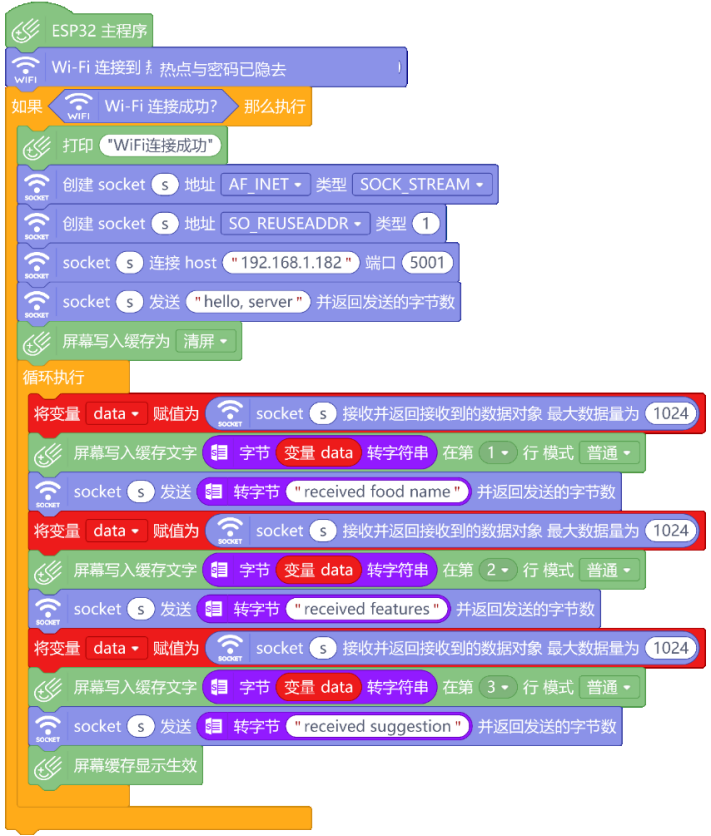
图 11 掌控板端程序:连接热点后建立 Socket,循环接收三次数据并分别写入屏幕三行(热点名称与密码已隐去)
3.5 怎么测:三类测试
测试按“能不能用—准不准—好不好用”三层设计,每一层都规定记录什么。
测试类别 | 要回答的问题 | 怎么做 | 记录什么 |
可行性 | 程序能不能跑起来 | 依次启动识别、判定、通信三段 | 是否报错、卡在哪一段 |
科学性 | 认得对不对、判得对不对 | 图片库抽 7 张;4 类实物各拍 1 次,配对应的病症 | 返回的第一个名称、结论、是否与禁忌表一致 |
实用性 | 真实瓶罐能不能拍 | 用塑料瓶、铝罐、玻璃瓶各测一次 | 是否需要重拍、屏幕能否看清 |
3.6 测试记录
下面这张表把能够追溯的测试逐条列出。原始记录没有保存每次的单条数据,所以这里只给类别与结论,不硬凑百分比。
类别 | 测试对象 | 次数 | 正确 | 说明 |
可行性 | 三段程序依次启动 | 3 | 3 | 识别、判定、通信均正常运行 |
科学性·识别 | 图片库中抽取的 7 张图片 | 7 | ≥6 | 报告记为“准确度 90% 以上”,未逐张留痕 |
科学性·判定 | 4 类实物 × 对应病症 | 4 | 4 | 结论与禁忌表逐条一致 |
实用性 | 实物拍摄(3 类包装) | 4 | 4 | 铝罐与玻璃瓶需避开强反光再拍 |
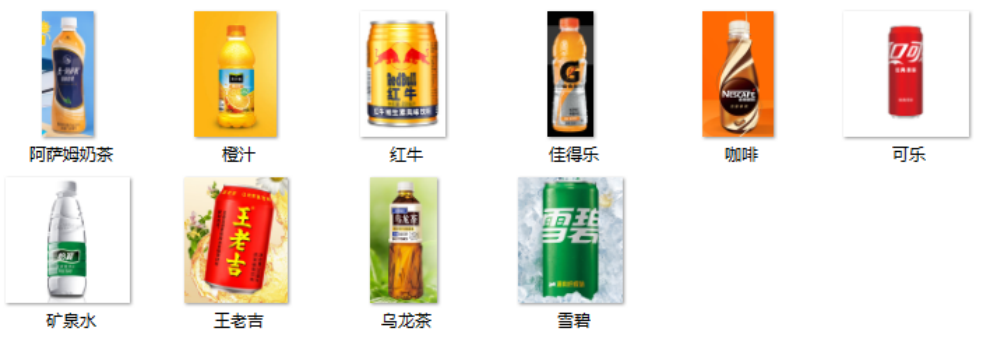
图 12 测试用的饮品图片库:每张图只含单个饮品,文件名即饮品名(图中为网上搜集的示例图)
原报告摘要写“识别准确度高达 95%”,正文写“90% 以上”,两者口径不一致。本材料统一采用正文口径,并把“准确率”改为“7 张中至少 6 张正确”。投稿前若能补做 30 次以上并逐条留痕,再给百分比才站得住。
3.7 从数据里读出的三件事
第一,“认得出”和“判得对”是两条独立的链条。四组实物测试,识别全对、判定也全对,看起来已经很可靠。但只要识别返回的名字和库里写的差一个字(“可口可乐”和“可乐”),第二条链条就断了,而且断得无声无息。所以真正决定成败的不是识别率,而是“名字能不能对上”。
第二,0.899 这个数让我改变了对“准确”的理解。以前我以为识别就是一个概率,越高越准。实际写程序才发现,程序取的是第一名,它没有“我不确定”这个选项。要让机器学会说“我看不清”,得由人给它加一条阈值。
第三,屏幕只有三行,反而帮了忙。“您患有糖尿病,不适宜饮用该饮料”这句话放不进一行,只能拆成第二行“您患有糖尿病”、第三行“不宜饮用”。拆开之后反而更好读——一次只说一件事,是给老人做提示的第一条规矩。
3.8 这次探究的局限
写清楚局限,比只报好数据更重要。这次至少有六点不足:
· 库太小 7 类病症、10 种饮品、15 条禁忌,而市面上的饮品数以万计,覆盖面远远不够。
· 缺阴性样本 四次实物测试都是“不能喝”的情形,没有留下一次“可以喝”的截图,等于只验证了一半。
· 输入方式不实用 靠输入姓名来识别使用者,真正的老人用不了这一步;扫脸或一键选择都还没做。
· 不是独立装置 必须带着一台电脑跑主程序,不是能揣进口袋的独立设备。
· 缺真实场景 11 次测试全部由作者本人操作,没有老人独立使用,也没在真实便利店里测过(冰柜玻璃反光、瓶身变形、标签被手指挡住都会影响识别)。
· 未经专业审核 禁忌表来自公开科普资料,没有经过医生或营养师审核。装置给出的是“提示”,不能替代医嘱。
四、软硬件清单与制作步骤
4.1 硬件清单
整套装置的硬件成本不高,核心只有一块名片大小的掌控板。
类别 | 名称 | 型号 / 规格 | 数量 | 用途 |
主控 | 掌控板 | ESP32 主控,板载 128×64 OLED、Wi-Fi、A/B 按键 | 1 | 接收结论、分三行显示 |
拍摄 | 手机 或 USB 摄像头 | 任意智能手机;或 720p 以上 USB 摄像头 | 1 | 拍下瓶身 |
计算 | 笔记本电脑 | 可运行 Python 3 与 VS Code 即可 | 1 | 调用接口、查库、当 Socket 服务端 |
网络 | Wi-Fi 热点 | 手机热点或家用路由器 | 1 | 电脑与掌控板通信 |
连接 | USB 数据线 | Type-C 或 Micro-USB(按板型) | 1 | 给掌控板供电与烧录程序 |
辅材 | 瓶罐若干 | 塑料瓶、铝罐、玻璃瓶各若干 | 若干 | 测试用 |
4.2 软件与接口
环节 | 工具 / 接口 | 关键设置 |
识别 | 百度 AI 图像识别开放接口 | 接口地址 …/rest/2.0/image-classify/v2/dish;参数 top_num=5 |
鉴权 | OAuth 2.0 取 access_token | 用 AK/SK 换取 token,token 有效期约 30 天,需缓存复用 |
判定 | Python 3 + 自建字典 | dataBase.py 中 foodDB / personDB / ban 三张表 |
通信 | Python socket(TCP) | 服务端绑定本机 IP 与端口 5001,先 listen 再 accept |
显示 | Mind+ 图形化 | 连接热点 → 建 Socket → 循环接收三次并写入屏幕三行 |
4.3 三张表的结构
表 | 键 | 值 | 扩充时注意 |
foodDB | 饮品名(与接口返回名一致) | 主要特点(字符串,如“含糖较高”) | 名字必须以接口返回为准,或另建别名表 |
personDB | 使用者姓名 | 病症列表(可多个) | 正式使用时应改为编号,姓名不宜作为键 |
ban | 病症名 | 不宜饮品名列表 | 病症名需与 personDB 中的写法完全一致 |
4.4 制作步骤(8 步)
第 1 步 备料:准备掌控板、手机或摄像头、电脑;在电脑上装好 Python 3、VS Code,并安装 requests、Pillow 两个库。
第 2 步 申请接口:到百度智能云控制台创建应用,拿到 AK/SK;先用官方示例跑通一次识别,确认能返回名称。
第 3 步 建表:新建 dataBase.py,按 4.3 的结构录入 foodDB、personDB、ban;先各录 7 条、7 人、5 类,便于调试。
第 4 步 调识别:写 recognize(),把图片路径、接口地址、top_num 设为变量;先把 res[0] 打印出来,确认名字对得上库。
第 5 步 调判定:写 analyse(),先手动给 res 赋值,绕过识别,专门测“名字在不在名单里”这一段逻辑。
第 6 步 调通信:写 connect(),在电脑上先跑通服务端;用网络调试工具充当客户端连一次,确认能收到三条数据。
第 7 步 烧掌控板:用 Mind+ 连热点、建 Socket、写循环接收;先只显示一条,通了再加到三条。
第 8 步 联调与测试:三段接起来跑;按 3.5 的三类测试逐项记录,失败的也要写下原因。
4.5 复刻建议
· 先做最小原型 没有掌控板时,可以先用电脑终端打印三行结论替代,先把识别与判定跑通,显示端最后再接。
· 省额度 接口有免费调用额度,测试时把 top_num 设为 1 可以省调用次数;调试识别阶段建议先把图片路径写成变量。
· 最容易踩的坑 禁忌库的病症名、病人库的病症名必须一字不差,否则判定会静默失效;建议写一个小脚本先做一致性检查。
· 优先改这里 想让老人真正用起来,第一步不是加功能,而是把“输入姓名”换掉——扫脸或按一下按键选自己。
五、开源代码
主程序只有一个文件 main.py,下面按三段完整列出。
5.1 识别:recognize()
先用 AK/SK 换一个 access_token,再把图片编码成 base64 字符串,和 top_num 一起 POST 给识别接口。返回的结果是一个列表,程序只把每一项里的 name 取出来,放进 res,最后打印 res[0]。
import base64, os, socket import requests import dataBase as db from PIL import Image
res, features, suggestion = "", "", ""
def recognize(): """把照片传给百度 AI,取回置信度最高的饮品名""" ak = os.environ.get("BAIDU_AK") sk = os.environ.get("BAIDU_SK") host = ("https://aip.baidubce.com/oauth/2.0/token" "?grant_type=client_credentials" "&client_id=" + ak + "&client_secret=" + sk) access_token = "" r = requests.get(host) if r: access_token = r.json()["access_token"]
url = ("https://aip.baidubce.com/rest/2.0/image-classify/v2/dish" "?access_token=" + access_token) img_path = "可乐.jpg" Image.open(img_path).show() with open(img_path, "rb") as f: # 二进制方式打开图片 img = base64.b64encode(f.read()) params = {"image": img, "top_num": 5} headers = {"content-type": "application/x-www-form-urlencoded"} r = requests.post(url, data=params, headers=headers) if r: items = r.json()["result"] global res res = [it["name"] for it in items if "name" in it] print(res[0]) |
5.2 判定:analyse()
先从饮品名查到特点,再问姓名、从病人库取出病症列表,然后逐个病症去禁忌库里比对。只要有一个病症把这种饮品列进去,就置 flag 并跳出循环;全部比完仍没命中,才输出“可以适量饮用”。
def analyse(): """查三张表,得出能不能喝的结论""" global features, suggestion foodDB, personDB, banDB = db.foodDB, db.personDB, db.ban features = foodDB[res[0]] print(features)
name = input("请输入您的姓名:\n") while name not in personDB: print("查无此人!重新输入") name = input("请输入您的姓名:\n")
illness = personDB[name] flag = False if illness: for i in illness: # 逐个病症检查禁忌名单 if res[0] in banDB[i]: suggestion = "您患有" + i + ",不适宜饮用" flag = True break if not flag: suggestion = "您可以适量饮用该饮料" else: suggestion = "您可以饮用该饮料" print(suggestion) |
5.3 通信:connect()
这一段的写法是“发一条、收一句回执”。三行数据之间夹着三次 recv,是为了让三条信息不会粘成一包——如果连续快速 send,TCP 可能合并发送,屏幕上就会显示成一堆乱字。
def connect(): """当 Socket 服务端,把三行结论发给掌控板""" port = 5001 listenSocket = None try: ip = socket.gethostbyname(socket.gethostname()) listenSocket = socket.socket(socket.AF_INET, socket.SOCK_STREAM) listenSocket.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1) listenSocket.bind((ip, port)) listenSocket.listen(3) print("tcp waiting...") print("%s:%s" % (ip, port)) while True: conn, addr = listenSocket.accept() print(addr, "connected") while True: data = conn.recv(1024) print(data.decode("utf-8")) conn.sendall(res[0].encode()) # 第一行:饮品名 print("client " + conn.recv(1024).decode()) conn.sendall(features.encode()) # 第二行:特点 print("client " + conn.recv(1024).decode()) conn.sendall(suggestion.encode()) # 第三行:结论 print("client " + conn.recv(1024).decode()) except Exception: if listenSocket: listenSocket.close() |
5.4 掌控板端
掌控板端用 Mind+ 图形化编写,不涉及文本代码。逻辑是:连上 Wi-Fi 热点 → 建立 Socket 并连接电脑的 IP 与 5001 端口 → 进入循环,依次执行三次“接收数据 → 写入屏幕第 N 行 → 回一句回执”,最后刷新屏幕缓存。
另外一件事是我做完才想明白的:
这个装置最难的其实不是识别,而是“敢不敢下结论”。识别错了,屏幕会给出一个看起来很确定的答案;名字对不上,程序会安静地输出“您可以适量饮用”。两种错误都不会报错,都比“程序崩了”危险得多。所以后面要加的每一条改进,本质上都是在让机器学会说“我不确定”。