保姆级教程|ESP-Mosaico 中文逐字打字机:字库取模、逐字刷新、排版对齐逐层拆解
标签:*ESP-Mosaico、VibeMode、ChatCoding、DeepSeek、HIL 硬件在环、LVGL、创客实战*
## 导读
前面我们完成了 ESP-Mosaico 外接 DeepSeek Flash、微信 / 飞书 IM 远程通道的改造,摆脱官方额度限制。这篇我们用一个**中文逐字打字机**案例,完整走一遍远程硬件在环(HIL)闭环:从基础效果跑通、像素预估风险预警、对齐方式调整,再到踩坑 LVGL 换行 BUG、修复中英文混排分词截断,最后附上真实 API 调用成本账单。
它不是一次性写好代码直接烧录,而是典型的 ChatCoding 增量式开发:一句自然语言、一轮真机反馈、一次脚本热部署,在反复试错里打磨出满意的显示效果。
## 一、项目基础背景
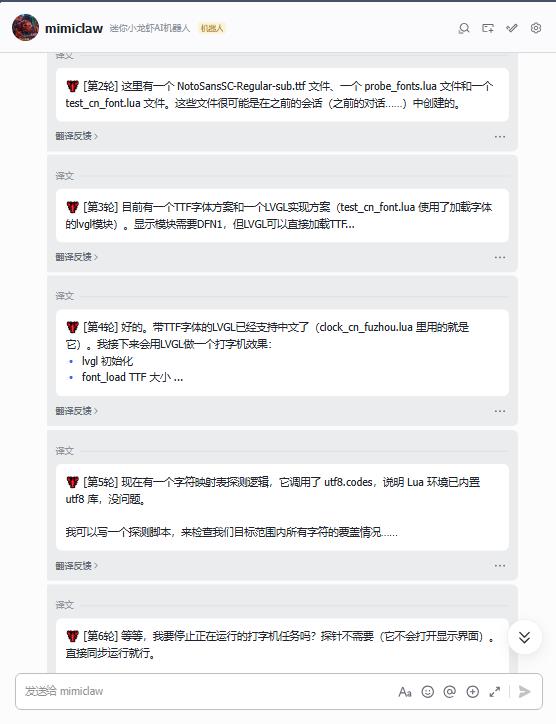
ESP-Mosaico 原生板端字体不含中文,想要实现中文动画,必须提前上传中文字体子集 `NotoSansSC-Regular-sub.ttf`,并且提前校验目标文本内所有汉字、标点的字形,避免出现缺字方块。
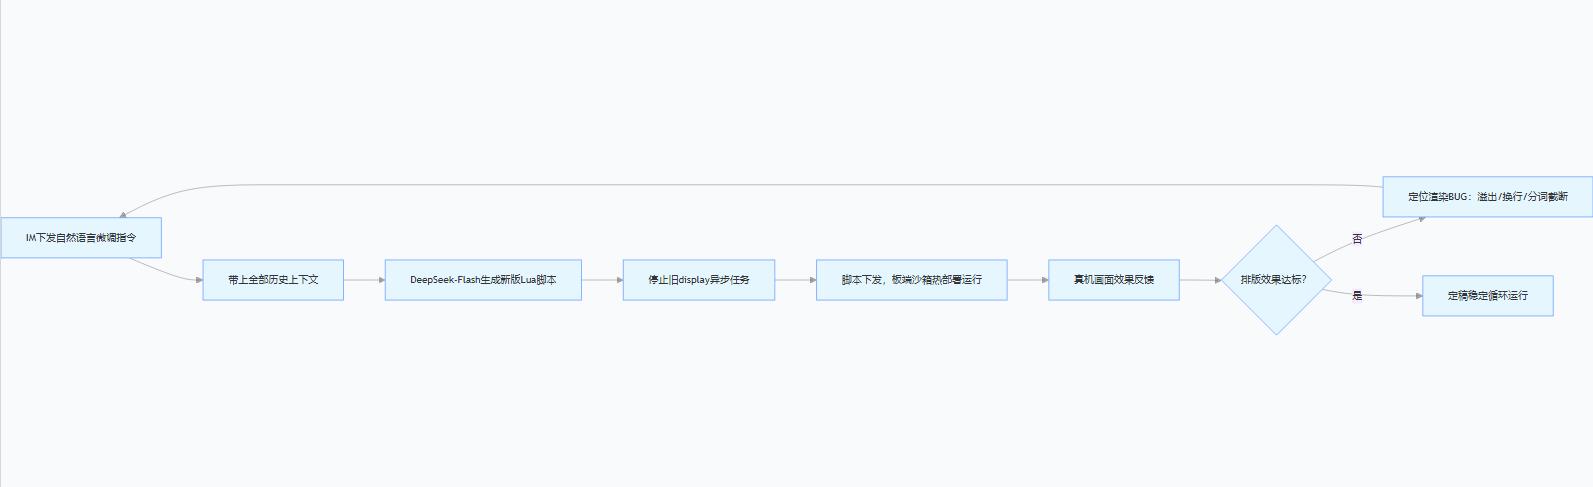
我们这套链路:**微信 / 飞书 IM 下发文字指令 → 网关转发给 DeepSeek Flash → Agent 生成 Lua 脚本 → 下发 Vibe Mode 沙箱热部署运行 → 真机画面反馈 → 继续微调**,全程不需要电脑编译、烧录。
> 核心约束:脚本使用 `exclusive:display` 独占屏幕资源,同一时间只能运行一套显示任务,每次修改前必须停止上一轮异步任务。
## 二、第一轮:基础打字机,像素预计算与溢出风险预判
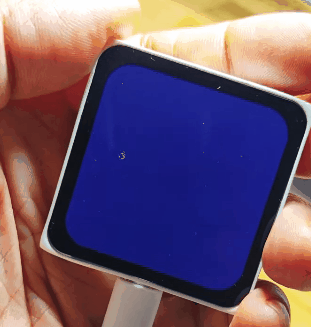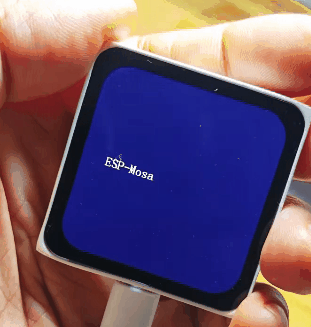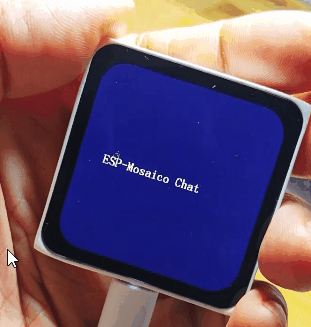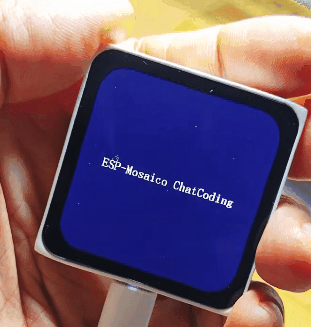
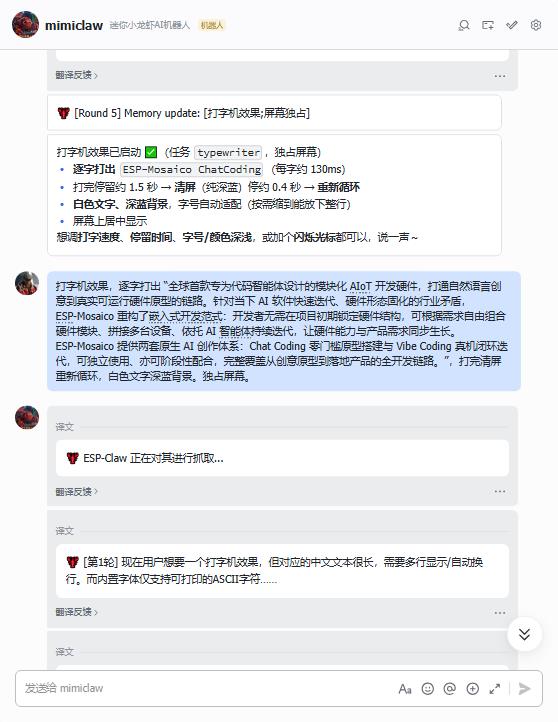
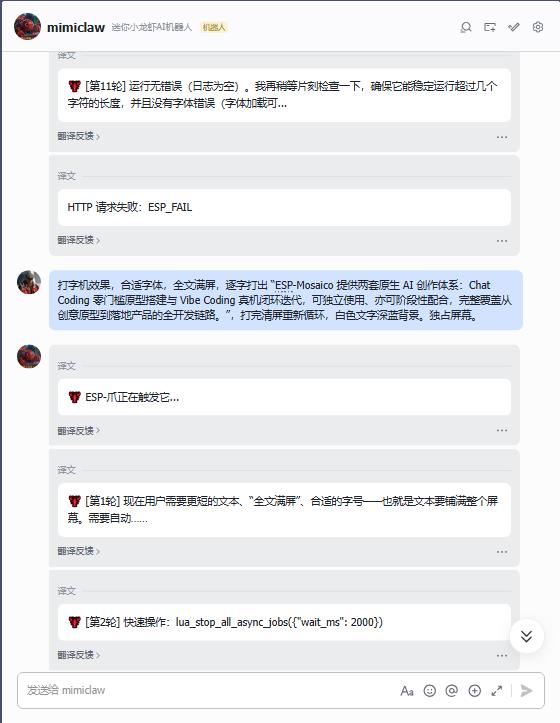
第一条需求:做逐字打字动画,全文铺满屏幕,白色文字、深蓝背景,打完停留后清屏循环。
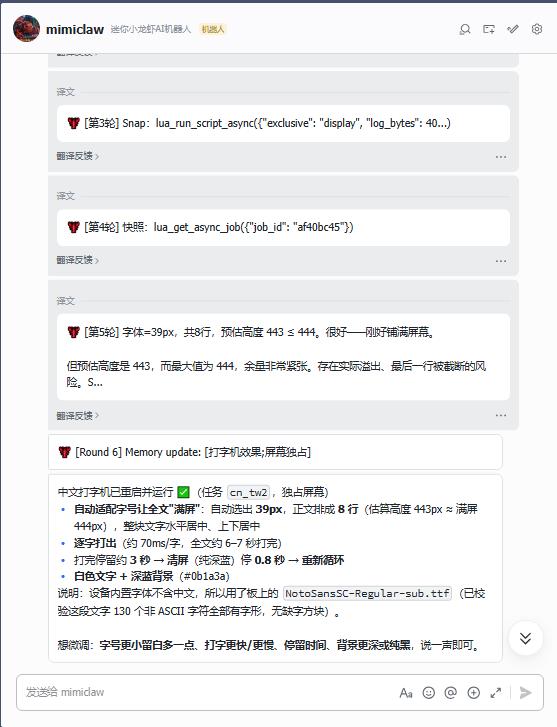
Agent 自动完成了字号计算:选定 39px 字号,排版为 8 行,预估总高度 443px,屏幕可用上限 444px。
这里有一个很有意思的工程细节:Agent 会主动做像素预估,并且识别风险 —— 余量极小,**存在最后一行文字被屏幕截断溢出的隐患**,提前告知我这个风险。
初始参数:
- 排版:上下居中
- 打字速度:70ms / 字,完整文本 6~7 秒打完
- 停留 3 秒,清屏间隔 0.8 秒,循环播放
- 字体:提前校验好的 NotoSansSC 子集,本段 130 个非 ASCII 字符全部有字形
这一轮跑通了基础打字动画,但我希望调整布局:文字从屏幕顶端开始排布,不再上下居中。
## 三、第二轮:布局迭代,踩坑 LVGL 换行机制
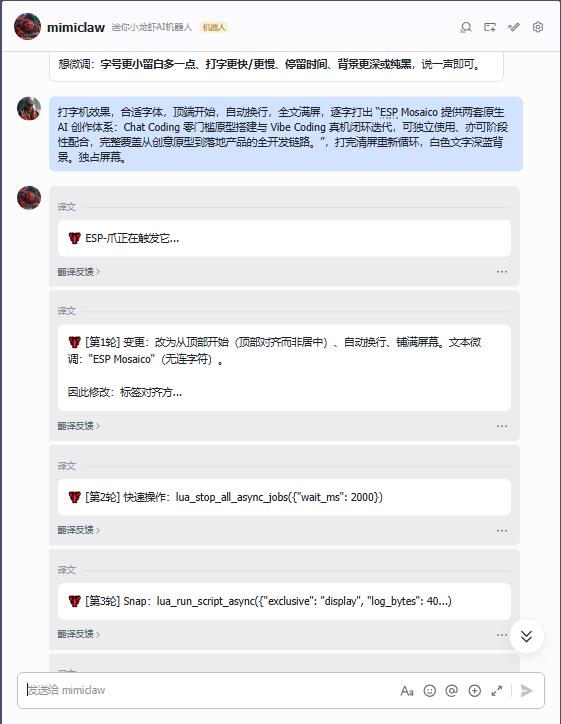
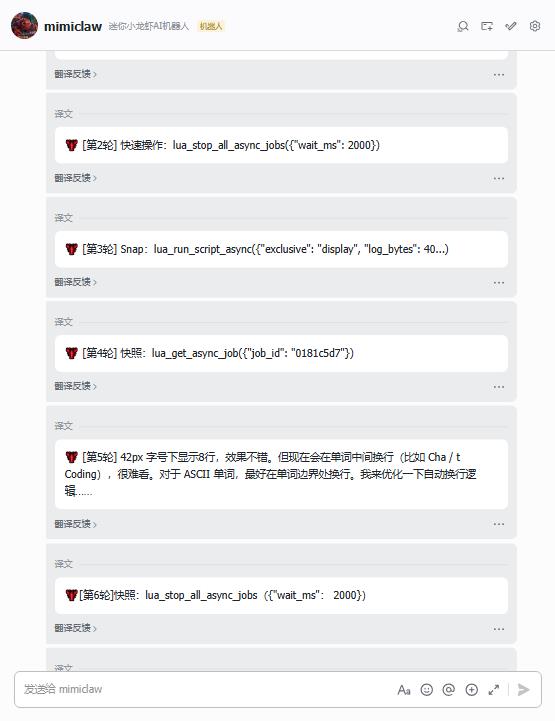
我在 IM 里直接下发新需求:文字顶部开始,自动换行,满屏 8 行。
Agent 标准化执行流程:
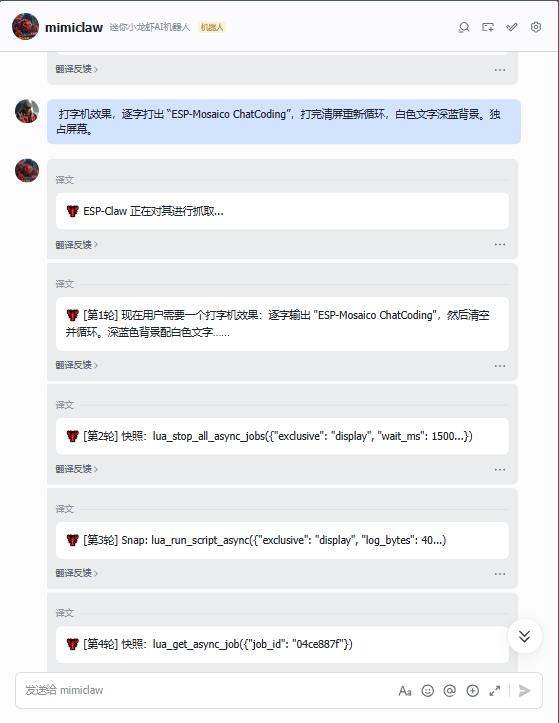
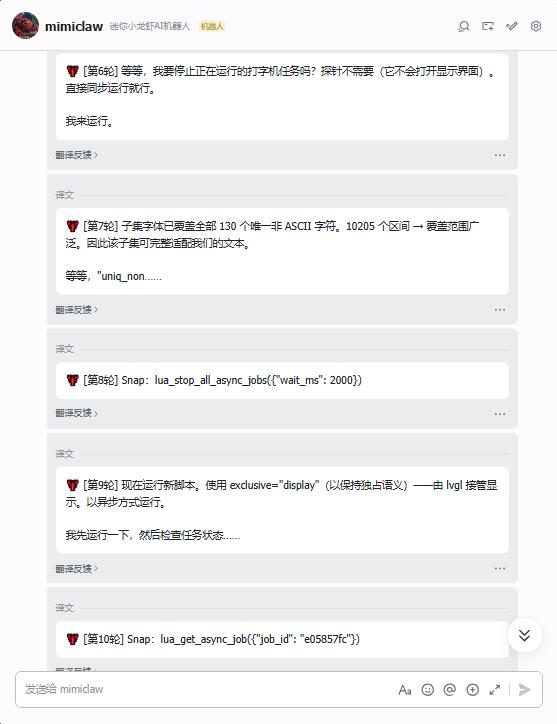
1. `lua_stop_all_async_jobs` 停止正在运行的旧显示任务
2. 生成新版 Lua 脚本,调用 `lua_run_script_async` 下发,独占 display
3. 通过 `lua_get_async_job` 轮询任务运行状态,等待真机反馈
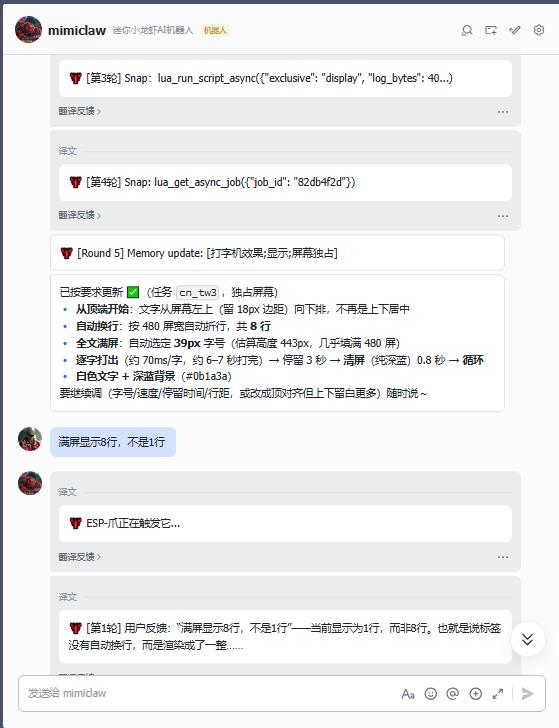
真机返回结果直接暴露 BUG:LVGL 控件自带自动换行失效,整段文字挤成单行,没有拆成预期的 8 行。
我反馈:**满屏显示 8 行,不是 1 行**。
Agent 定位根因:依赖 LVGL 控件内部折行不稳定,在长文本、中英文混排场景容易失效。
修复换行之后,又遇到第二个体验缺陷:英文单词被从中间切开,`ChatCoding` 被拆成 `Cha/t Coding`,阅读观感很差。
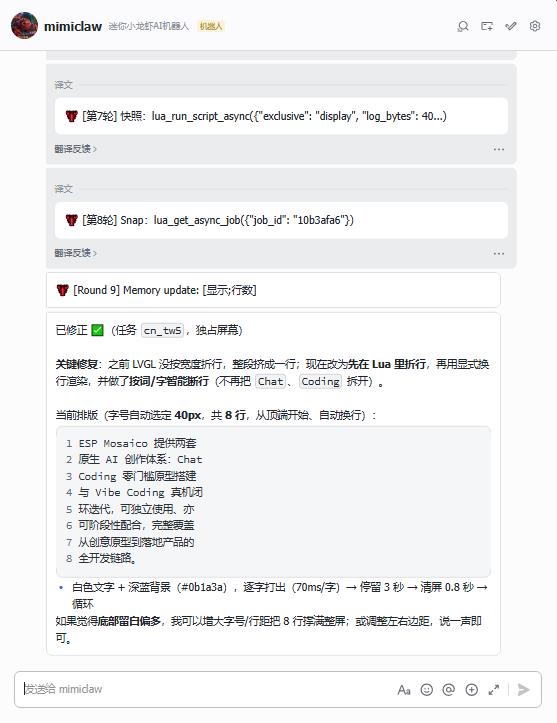
Agent 给出方案:**放弃 LVGL 自带换行,把分词、折行逻辑前移到 Lua 脚本层预处理**,区分两套规则:中文按字换行,英文以完整单词为边界,不在单词中间截断。
最终定稿版本参数:
- 起始位置:屏幕左上角,预留 18px 边距,顶部对齐
- 字号:40px,固定 8 行
- 换行逻辑:Lua 预分词折行,中英文智能换行
- 动画:逐字 70ms,打完停留 3 秒 → 清屏 0.8 秒 → 循环
- 配色:白色文字,深蓝背景 #0b1a3a
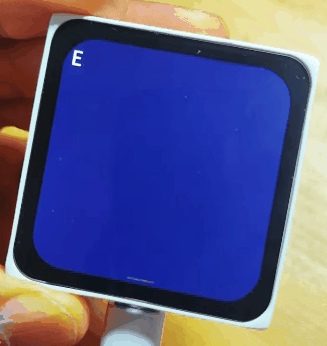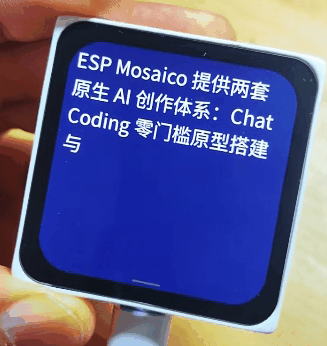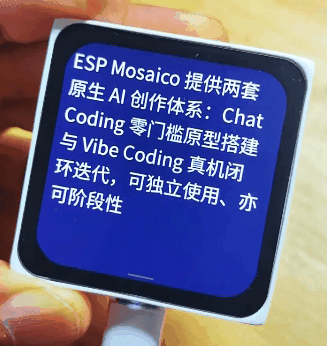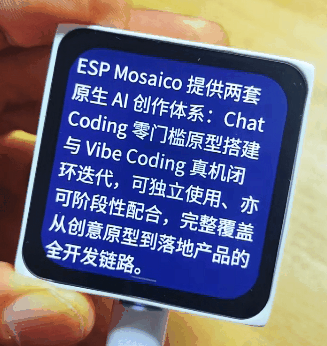
> 这就是 ChatCoding 增量调试的精髓:Agent 不是只写一次性代码,它接收真机反馈、识别渲染缺陷、更换底层实现方案,持续迭代。
## 四、飞书 IM 通道,同一个`bounce`任务的增量迭代实录(电脑版实时截图)
## 五、配套成本复盘:DeepSeek 后台用量账单
整个从初版到最终定稿的多轮调试,全部调用记录在 DeepSeek 后台可以直观看到:
- 账户余额 ¥10.01,累计消费 ¥9.98
- 本次单日调试:消费 ¥0.43,一共 81 次 API 请求,总 Token 消耗 2688892 tokens
- 调用高峰和我们的调试时间完全对应:第一轮调试基础打字效果、第二轮修复换行与分词 BUG,形成两个清晰的峰值
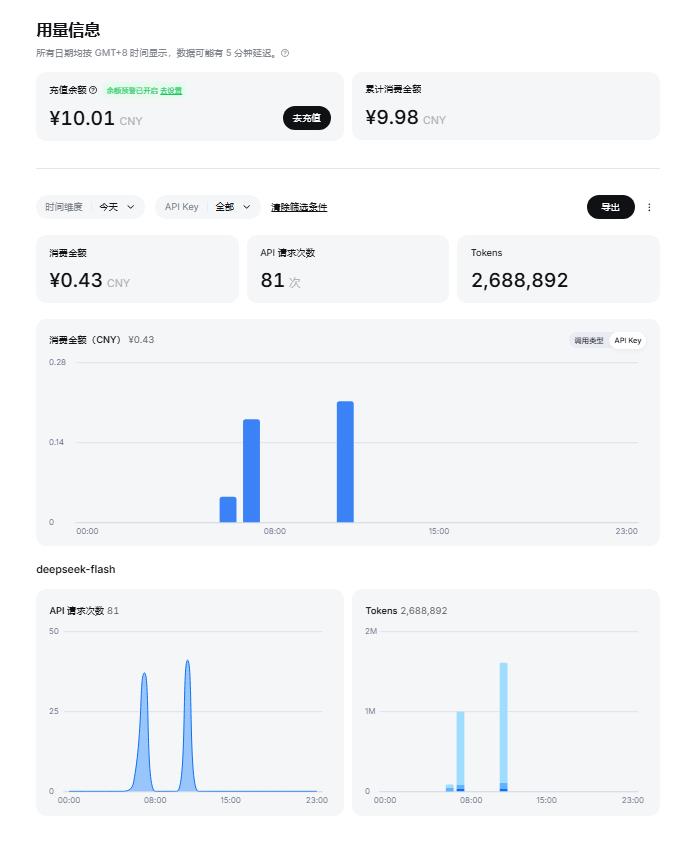
很多人会疑惑:只是一个简单的屏幕动画,为什么 Token 消耗两百多万?
核心原因:**HIL 闭环是带完整历史上下文的对话**。每一轮微调,都需要把历史对话、上一版 Lua 代码、真机反馈、硬件上下文全部塞进 Prompt,让 Agent 理解本次修改的边界。上下文持续累积,Token 开销随之上涨。
创客实战建议:
连续多轮迭代之后,上下文会越来越臃肿,不仅 Token 成本变高,大模型还容易混淆新旧需求。遇到这种情况,直接新开一条 IM 会话,清空历史,降低开销同时减少幻觉。
对比官方自带额度,外接 DeepSeek Flash 成本透明、可控,适合这种高频试错、反复打磨细节的原型调试。
## 六、完整 HIL 闭环流程图
## 七、专项踩坑清单|LVGL 文字渲染 + 中文字体 + 远程 HIL 上下文
> 专门针对 ESP-Mosaico ChatCoding 屏幕文字项目,把本次踩过的坑整理成可复用避坑手册
### LVGL 文字渲染相关坑
1. **不要轻信 LVGL 控件自带自动换行**
LVGL 文本控件的自动折行对中英文混排、长文本稳定性差。优先方案:在 Lua 脚本里预先做文本分词、手动切分多行,再逐行交给 LVGL 渲染。
2. **像素边界余量一定要留足**
Agent 的像素预估是理论计算,屏幕渲染、字体字距、行高会有偏差。不要把文字高度算到贴满屏幕上限,建议预留 8~16px 安全余量,避免最后一行被截断消失。
3. **display 独占资源,忘记停任务会出现画面错乱**
使用 `exclusive:display` 独占模式时,新脚本运行前必须调用 `lua_stop_all_async_jobs`。旧动画任务不终止,多个渲染任务抢占屏幕,会出现画面闪烁、图层叠加、动画卡死。
4. **动画时序叠加 BUG**
打字、清屏、循环多个延时任务同时跑,容易出现时序错乱。尽量把整套动画做成单条串行任务,不要并行多个 `wait_ms` 异步定时器。
5. **英文单词切割问题**
LVGL 原生换行是按字符切割,遇到英文会把单词从中间劈开。必须自研分词逻辑:英文以空格为分隔符,优先保证单词完整,中文按单字拆分。
### 中文子集字体(NotoSansSC)相关坑
1. **子集字体漏字是高频坑**
子集字体只包含你预先导出的文字。如果文本里出现子集没有收录的汉字、特殊标点,屏幕直接显示方块。**正式演示前,先把全部文本丢给 Agent 校验字形**。
2. **字体文件名、路径不能写错**
大小写、后缀、存储路径错误,会直接 fallback 到默认无中文字体,调试时第一时间排查字体加载日志。
3. **字号不要盲目拉太大**
子集字体本身有适配字号区间,超大字号会出现笔画发虚、锯齿明显;过小字号容易出现渲染糊字,优先在 32~48px 区间测试。
4. **特殊符号兼容**
全角标点、emoji、特殊符号很多不在中文字体子集里,长文本演示尽量提前剔除。
### IM 远程 HIL、上下文与大模型成本坑
1. **上下文无限膨胀,越往后越贵、越容易幻觉**
每一轮迭代都会携带历史代码、调试日志、反馈截图描述,Token 持续暴涨。建议规则:**连续 5 轮以上微调,直接新开 IM 会话**。
2. **模型容易 “遗忘旧约束”**
会话太长之后,大模型会忘记「独占屏幕、使用指定字体、不能修改动画时序」这类前置约束,突然改掉已经调好的参数。新开会话时,把核心约束写在第一条 prompt。
3. **调试反馈描述尽量精准**
只说 “不好看”,Agent 很难定位;优先描述现象:文字挤成一行、单词中间断开、最后一行被切掉,模型定位 BUG 效率高很多。
4. **异步任务 Job ID 丢失**
多轮调试里 job_id 会变化,不要硬编码旧任务 ID 去轮询,让 Agent 自动获取最新 job_id 做状态快照。
5. **高频调试注意限流**
短时间几十次连续 API 调用,Flash 接口会触发限流报错,表现为脚本生成失败、空响应。连续调试适当放缓下发指令节奏。
## 八、总结与思考
这个中文打字机案例,看着只是屏幕动画,背后是一套完整的**Agent 驱动硬件在环开发范式**:
1. 具备硬件感知能力:自动计算像素、预判溢出风险,不是单纯的文本生成;
2. 支持增量迭代:依托真机反馈持续修复渲染层 BUG,能识别 LVGL 控件的局限性;
3. 多语言适配:主动区分中文、英文的换行逻辑,兼顾混排场景;
4. 成本可量化:我们拿到了真实的调用账单,证明 Flash 这类轻量模型,非常适合创客高频原型调试。
和传统 ESP-IDF、Arduino 开发对比:我们不需要在电脑上反复改代码、编译、烧录,拿着微信就能远程调板子,每一次修改都是热更新。当然它也有边界:上下文膨胀带来的开销、控件渲染的底层限制,都需要我们在调试中主动规避。
附录:试验记录
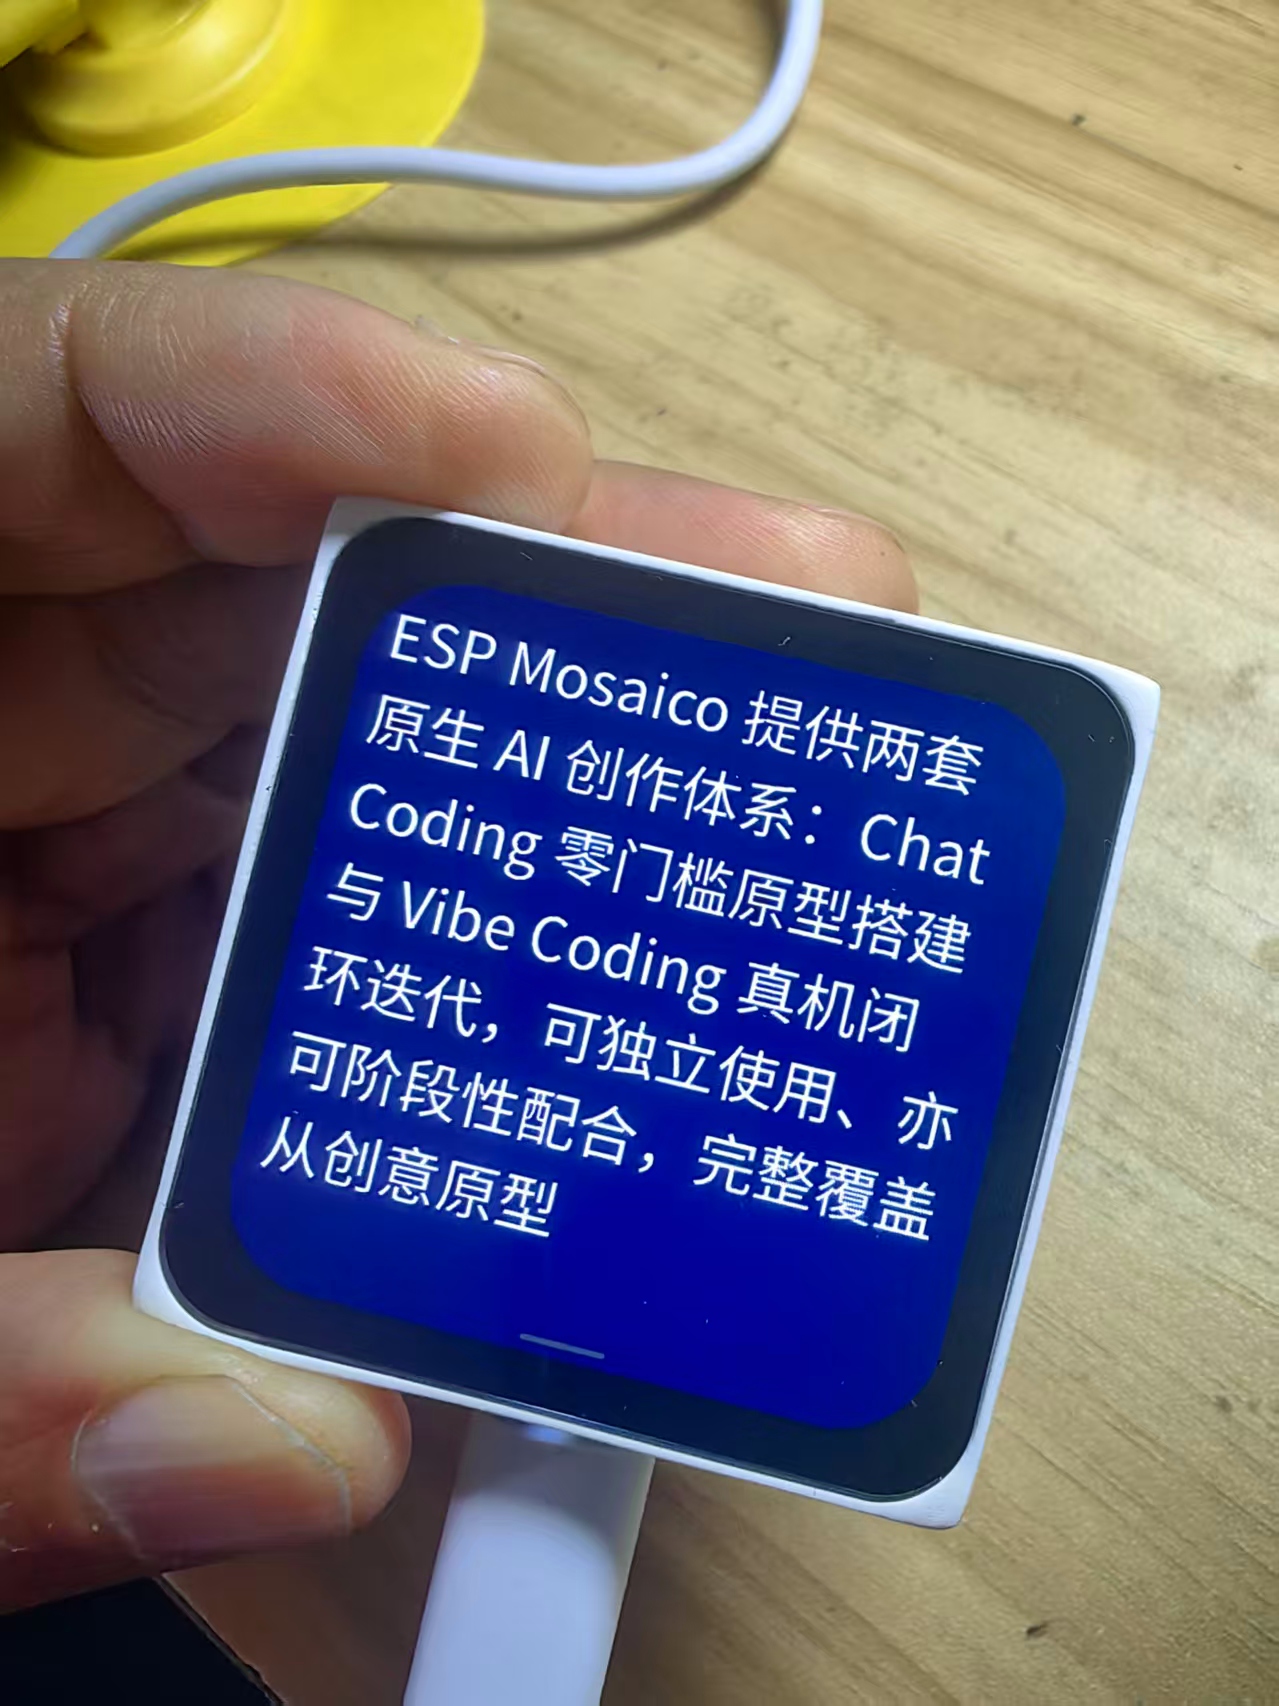
【【花雕动手做】经过多轮迭代终于完成ESP‑Mosaico的逐字打印机屏显效果 #ESP-Mosaico #花雕动手做 #人工智能 #逐字打印效果 #科技改变生活】