让行空板 M10「听声辨键」:用麦克风识别你按了哪个键
一次键盘声学侧信道(Acoustic Side-Channel)的完整复刻:从 PC 上的算法原型,到行空板 M10 的板载麦克风 + 触摸屏落地。全程本地运行,音频不出板子。
一、缘起:一个视频引发的折腾
前几天刷到 B 站一个视频:一块 Nordic 的开发板,接上键盘,靠一个麦克风「听」键盘的敲击声,就能实时判断你按下了哪个键——Keysnoop 声学侧信道演示。
原理其实不玄学:
- 每个键帽的位置、结构、受力都略有不同,敲击时发出的声音在频谱上有独特「指纹」;
- 机械键盘尤其明显——按下声、回弹声、触底余振携带着可区分的高频成分;
- 采集标注音频 → 提取频谱特征 → 训练分类器 → 实时推理,就是一套完整的声音分类问题。
既然 Nordic 能在 NPU 上做,那能不能用行空板 M10复刻一个?它有板载麦克风、2.8 寸触摸屏、A/B 实体按键,还跑 Debian + Python,天生适合。这篇文章记录全过程,包括我踩过的几个挺有代表性的坑。
二、我要做什么
| 目标 | 说明 |
|---|---|
| 传感器 | 行空板 M10 板载麦克风(也可插 USB 麦克风) |
| 被测对象 | 普通键盘(机械键盘效果最好) |
| 交互 | 2.8 寸触摸屏显示提示/结果/虚拟键盘,A/B 键控制流程 |
| 算法 | 击键检测 → 特征提取 → 分类器,全部本地 Python + numpy |
| 隐私 | 音频不出板子,模型存本地 |
整体数据流:
麦克风 ──> 击键检测(切分) ──> 特征提取 ──> 分类器 ──> 屏幕大字 + 虚拟键盘高亮
              │
        (训练时) 采集标注样本 ──> 交叉验证选最优分类器 ──> 存 keysnoop_model.pkl
三、硬件与材料
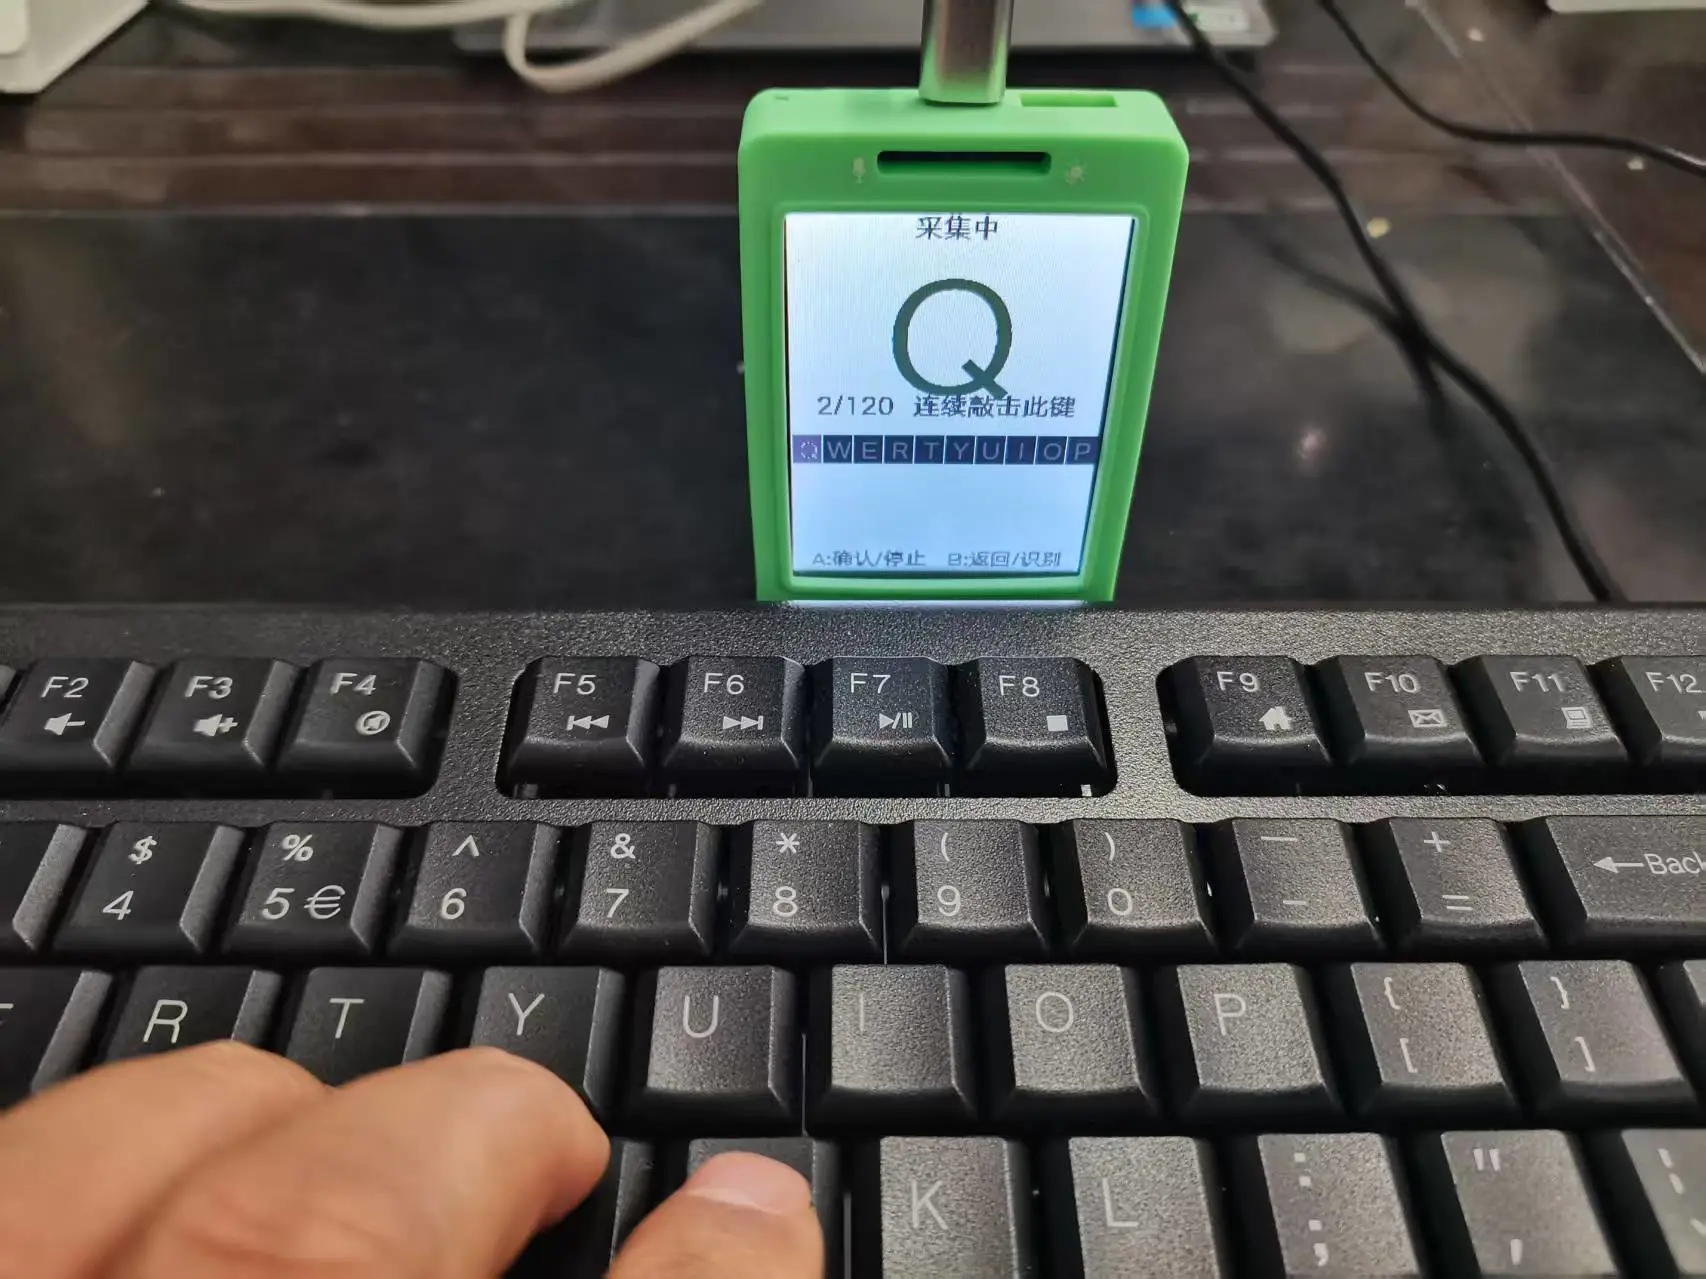
- 行空板 M10(DFRobot Unihiker M10)×1,USB 线连电脑
- 键盘一个(我用的是机械键盘;薄膜键盘也能用但区分度低)
- 可选:USB 麦克风(板载麦克风灵敏度有限,贴近键盘效果更好)
行空板 M10 关键规格:RK3308 四核 A35 @1.2GHz、512MB RAM、16GB eMMC、Debian 10、2.8 寸 240×320 触摸屏、板载电容硅麦克风、A/B 实体按键。
四、先在 PC 上把算法跑通
我没有一上来就往板子上怼,而是先在 PC 上用普通麦克风把整条链路做通。核心分成 5 个模块:
keysnoop/
  audio.py     录音流(sounddevice)
  detect.py    击键检测(从连续音频切出一次按键)
  features.py  特征提取(对数频带谱 + MFCC + 时域统计)
  model.py     分类器(最近类中心 / 加权kNN / RBF-SVM 自动选)
  engine.py    调度:采集向导、训练、实时识别
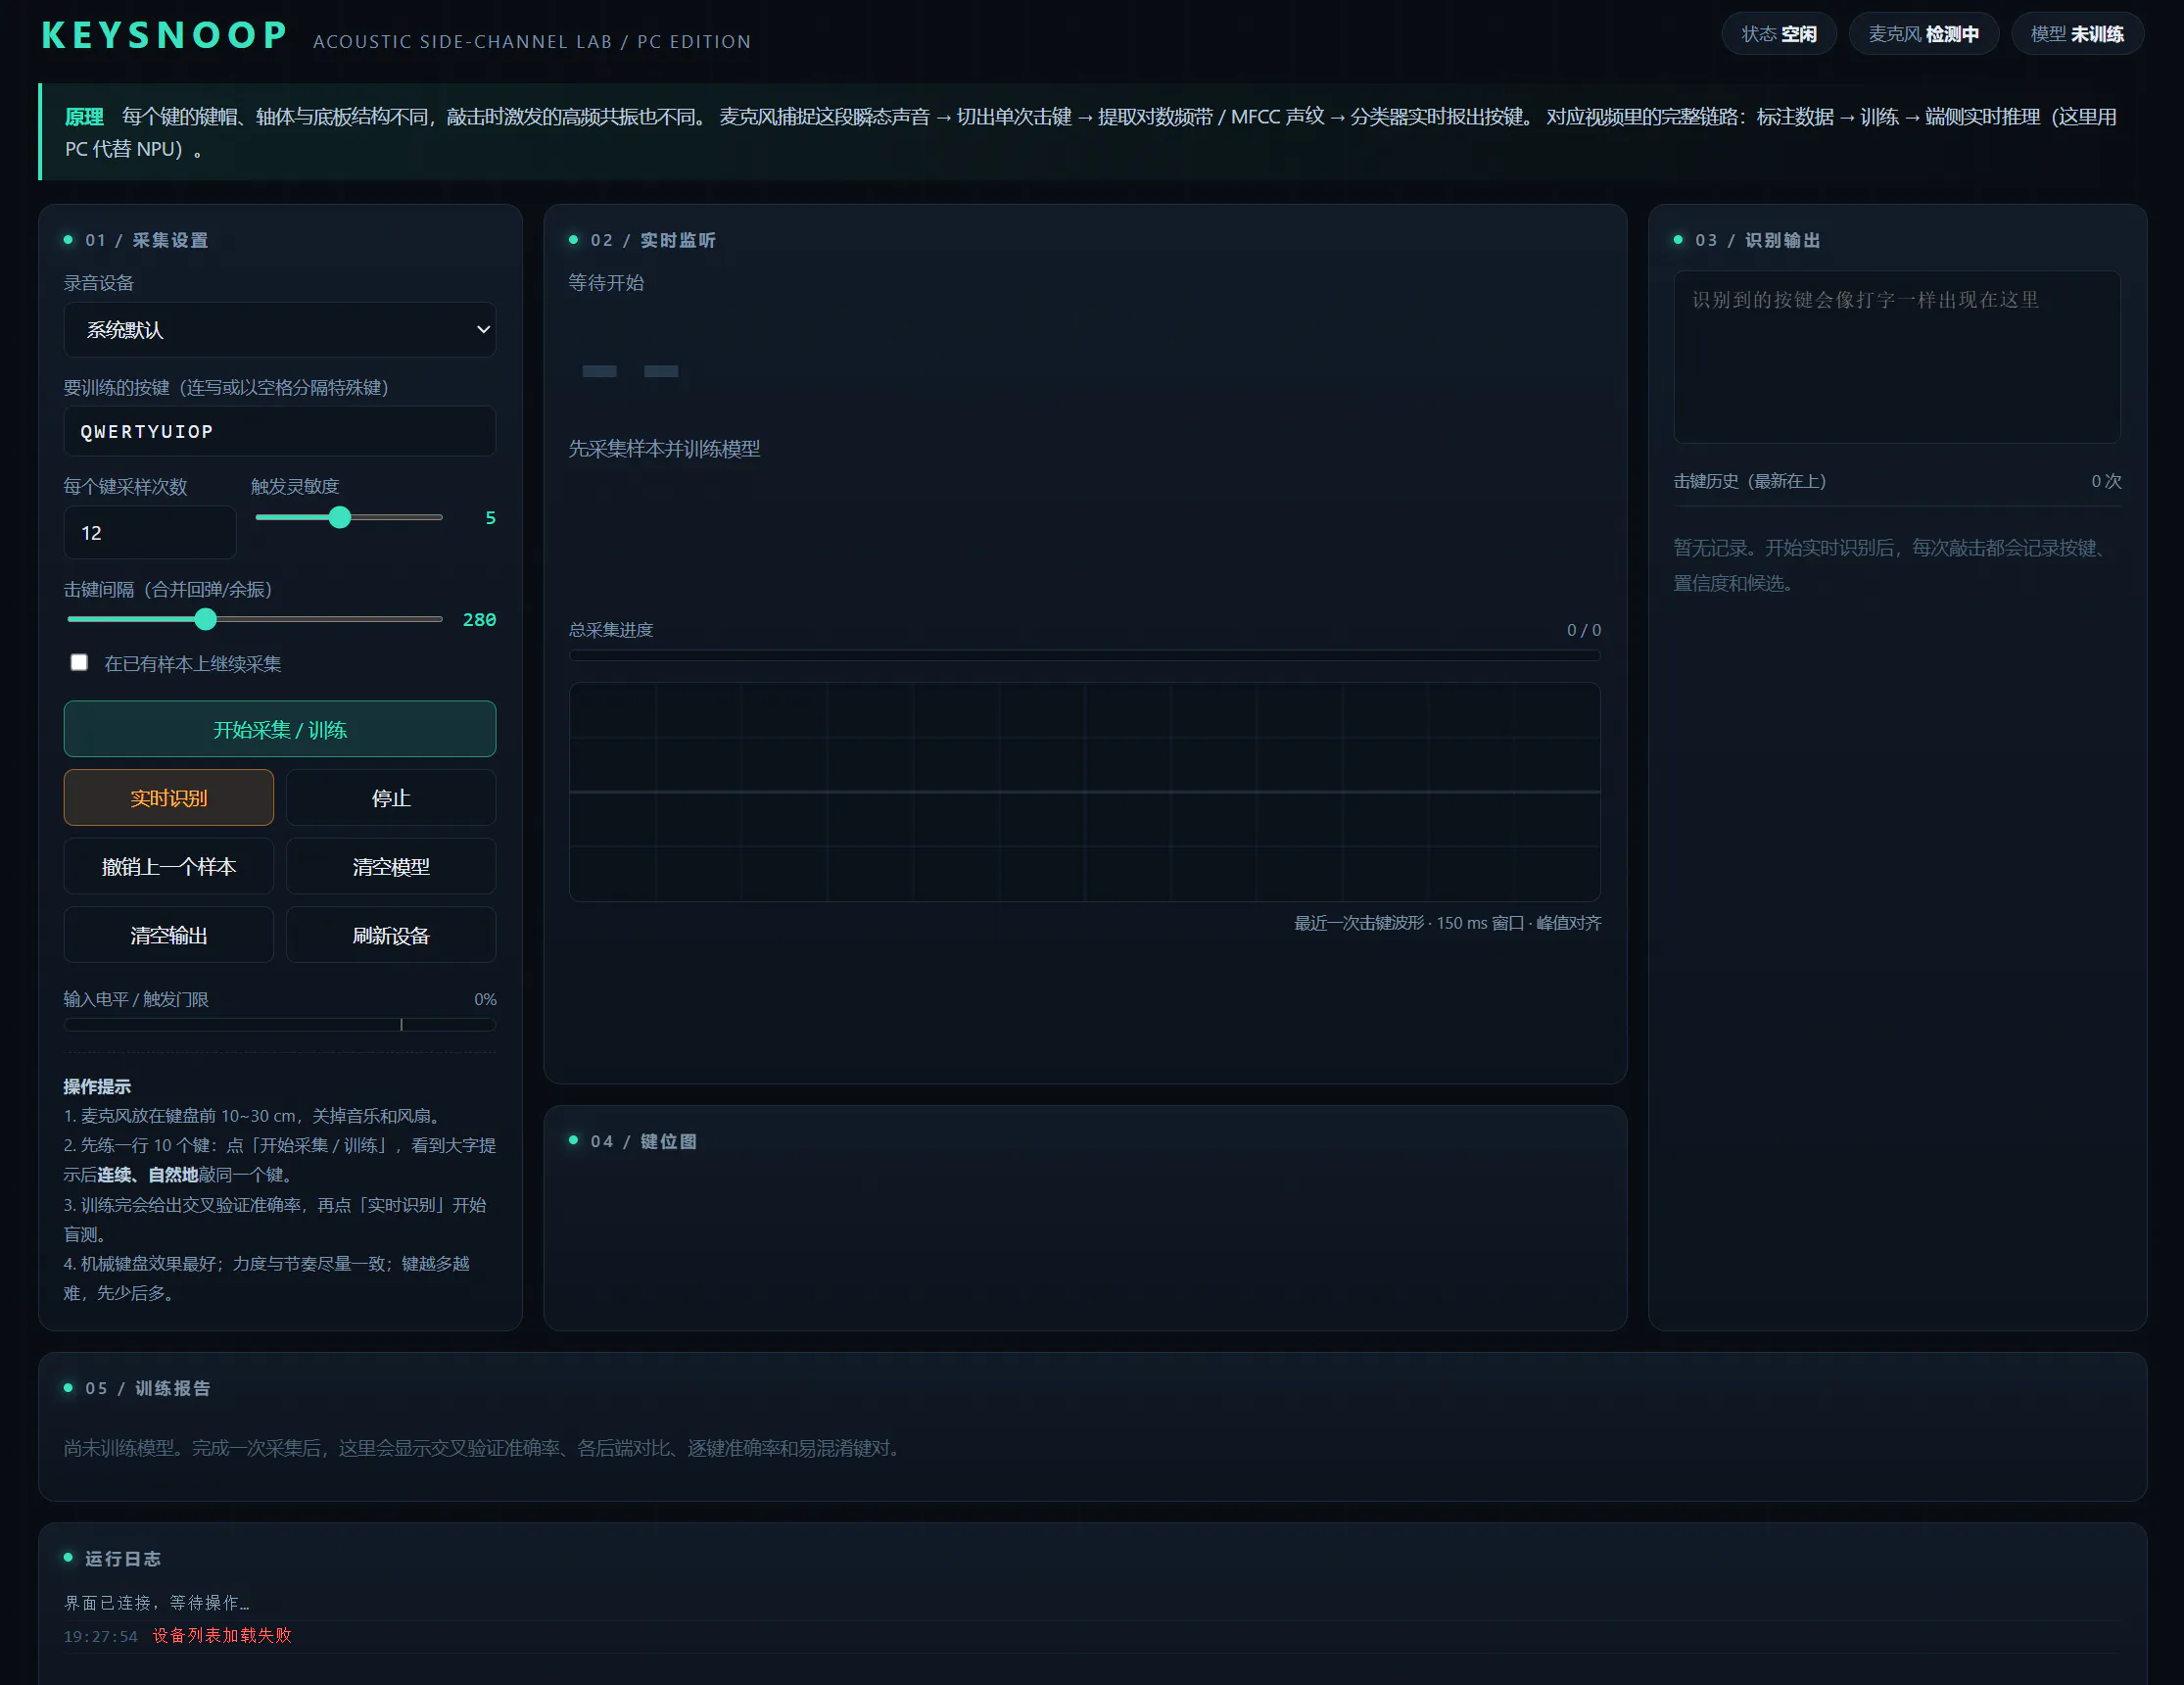
PC 端还做了个本地网页控制台(标准库 http.server,零额外依赖),可以训练、看 Top-3 置信度、虚拟键盘高亮、实时波形。这一步先验证了「声音确实能区分按键」这件事。
4.1 第一个关键问题:一次按键被切成 2~3 个样本
跑起来就发现问题:按一下键,经常采到 2~3 条数据。原因很清楚——一次真实敲击是按下声 + 回弹声 + 桌面余振一串声音,最初的固定「不应期」太短,余振一超过就被当成新的一次击键。
我把检测器重写成声音活动分组状态机:
IDLE ──能量超过高门限──> ACTIVE ──连续静音达 tail_ms──> COOLDOWN ──间隔结束──> IDLE
- 一次按键 = 一段连续声音活动,只有能量持续低于低门限才算这次结束,自然把按下/回弹/余振合并成一次;
- 冷却期
gap_ms从按键触发点算起(不是段落结尾),既吸收余振又不会吞掉下一按键; - 波形按本段能量峰值对齐,强化「主声」信息;
merged字段记录合并了多少个声音脉冲,界面上能看到。
这里踩了个隐蔽的 bug:tail_len 我原本按采样点数算,却拿去和帧计数比较,结果要连续 21 秒静音段落才结束——相邻按键全被并成一个,自检直接掉到 40/80。改成帧数后恢复 80/80。这种单位错误在音频处理里非常容易中招。
4.2 特征与分类器
- 特征:48 维对数间隔频带谱 + MFCC + 时域统计量,共约 200 维;谱形状做中心化,消除敲击力度差异。
- 分类器:用 5 折交叉验证自动比较最近类中心 / 加权 kNN / RBF-SVM,选准确率最高的存盘。
合成数据的自检结果:事件切分 80/80、Top-1 97.5% / Top-3 100%;用「按下声 + 回弹 + 余振」的机械键盘仿真,80 次按键 → 80 个事件,1:1 切分。
五、搬到行空板 M10
PC 版验证完,我开始做行空板版。核心算法一行没改——model.py 本来就支持无 sklearn 时自动降级到纯 numpy(centroid / 加权 kNN),ARM 上零重依赖。要重写的是前端:
unihiker_app.py:板载麦克风录音 +unihiker.GUI触摸屏 + A/B 键控制;- 逻辑与显示解耦:
Controller复用核心算法,UnihikerUI走屏幕,HeadlessUI供 PC 无屏自检。
界面状态机:
菜单 ──A──> 静置2秒 ──> 静音校准 ──> 采集(大字提示当前键) ──> 自动训练 ──> 报告
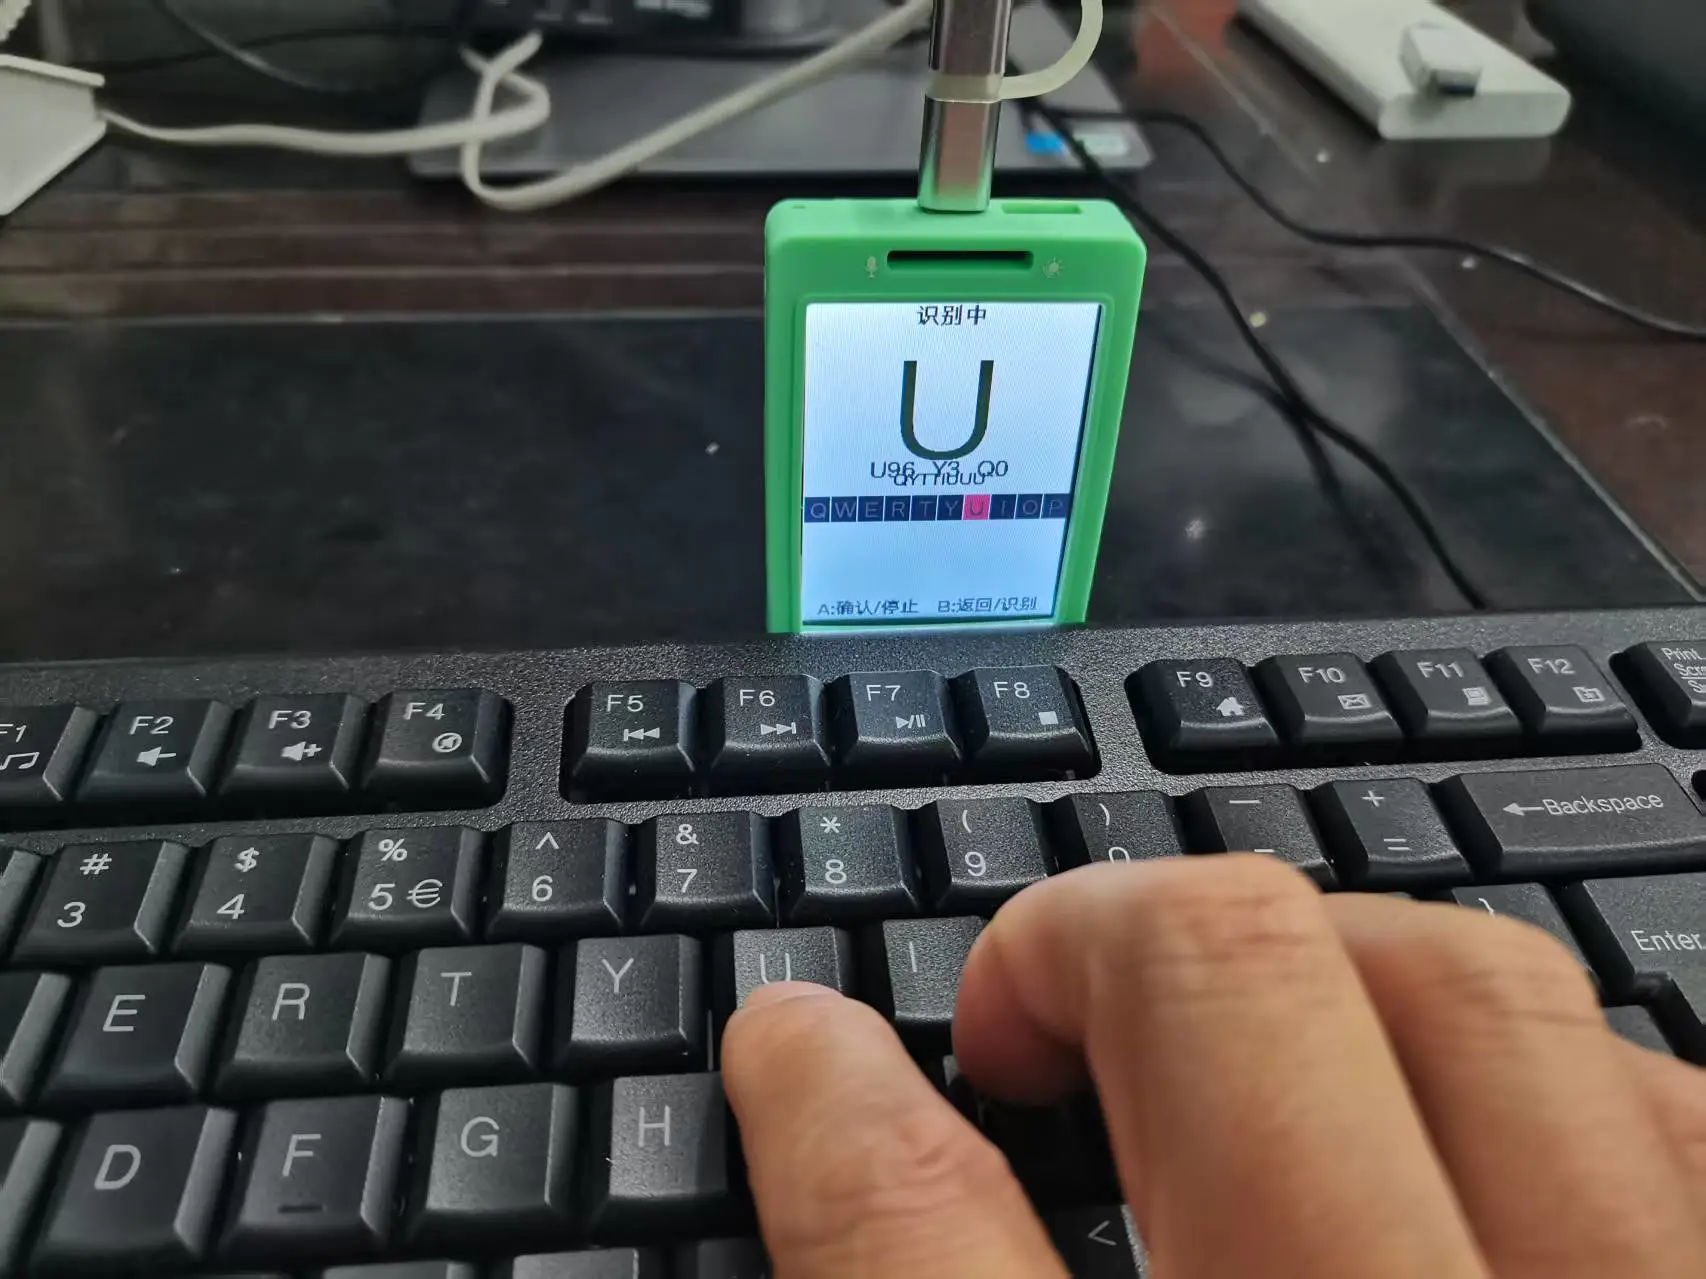
菜单 ──B──> 静置2秒 ──> 静音校准 ──> 实时识别(大字+虚拟键盘高亮+Top3)
六、连接与部署(几个真实的坑)
用 USB 线连接后,板子会通过 USB 虚拟网卡出现,IP 是 10.1.2.3(我另有一个局域网 IP 当时 ping 不通,建议直接用 USB 这个)。
坑 1:SSH 默认密码不是 root
常见默认凭据我试了一圈全被拒,root/root、root/123456 都不对。查官方文档才确认,行空板 M10 的 SSH 是 root / dfrobot。连上后环境是:Debian 10 buster / Python 3.7.3 / aarch64 / numpy 1.21.6,unihiker 和 sklearn 1.0.2 都自带。
我用 Python 的 paramiko 做免交互 SSH/SCP 部署,比配 sshpass 省事。
坑 2:Python 3.7 兼容性
| 我的代码用了 `int | None这类 3.10+ 的注解写法。好在文件头有from future import annotations` 兜底,板子上自检全过,不用降语法。 |
坑 3(最关键):默认录音设备是静音的 Loopback
arecord -l 只列出 Loopback 回环设备,直接录音会录到静音。真正的主板麦克风是 rockchip,rk3308-acodec (hw:1,0)(sounddevice 里的 device 2,44100 Hz,有真实底噪)。
我在 unihiker_app.py 里加了设备自动挑选,跳过虚拟设备:
def pick_mic_device():
    devices = list_input_devices()
    bad = ("loopback", "default", "sysdefault", "pulse", "null", "dmix", ...)
    real = [d for d in devices if not any(b in d["name"].lower() for b in bad)]
    for d in real:
        if any(k in d["name"].lower() for k in ("acodec", "mic", "usb", "rockchip")):
            return int(d["index"])
    return int(real[0]["index"]) if real else None
板上实测正确选中 device 2,真实麦克风流式采集 44100 Hz、0.6 秒完成校准。
坑 4:apt 源失效
Debian 10 的 httpredir.debian.org 已经没有 Release,portaudio19-dev 装不上。但系统里已有 libportaudio.so.2,直接 pip3 install sounddevice 就能用。
坑 5:旧模型把采样次数悄悄改回去
我把默认采样次数从 12 改成 100、又改成 120,界面却还是显示 12。排查发现:加载旧模型时会用旧数据集的 reps 覆盖命令行参数,而启动时只在「键集不同」时才覆盖——这次键集相同,就被旧模型的 12 顶回去了。
修法:命令行的 --reps 无条件优先,且旧数据集的 reps 与本次不一致时直接丢弃旧数据集和模型。顺手把板上的旧模型删了重新开始。
教训:改采样次数/键集这类参数,一定要删旧模型 + 用新参数重启,否则旧模型会静默覆盖你的配置。
坑 6:按 A 后立刻校准,把松键声采了进去
按 A 键后会松开键、手离开板子、甚至挪动板子,这些声音如果落在校准期或采集期,会污染噪声底或被当成击键样本。
我加了一个静置等待期:按 A/B 后先倒数 2 秒,这段时间只读音频保持流活跃、但不喂给检测器,让松键/收手/放稳板子的声音全部丢弃;之后再做 1.5 秒静音校准(原来只有 0.6 秒)。命令行加 --settle 和 --calib_ms 可调。
专项测试:静置期故意混入 3 次强敲击 → 采到 0 个样本(全丢弃),校准后正常采集、训练完成。
七、在板子上怎么跑
把项目目录拷到行空板,进入目录:
python3 unihiker_app.py --keys QWERTYUIOP --reps 120 --settle 2 --calib_ms 1500
运行后停在菜单界面:
| 状态 | A 键 | B 键 |
|---|---|---|
| 菜单 | 开始采集训练 | 开始实时识别(需先有模型) |
| 采集中 / 识别中 | 停止并返回菜单 | 停止并返回菜单 |
| 训练完成(报告) | 返回菜单 | 返回菜单 |
若 A/B 物理键回调不可用,可触摸屏幕左半屏 = A、右半屏 = B 兜底。
训练流程:
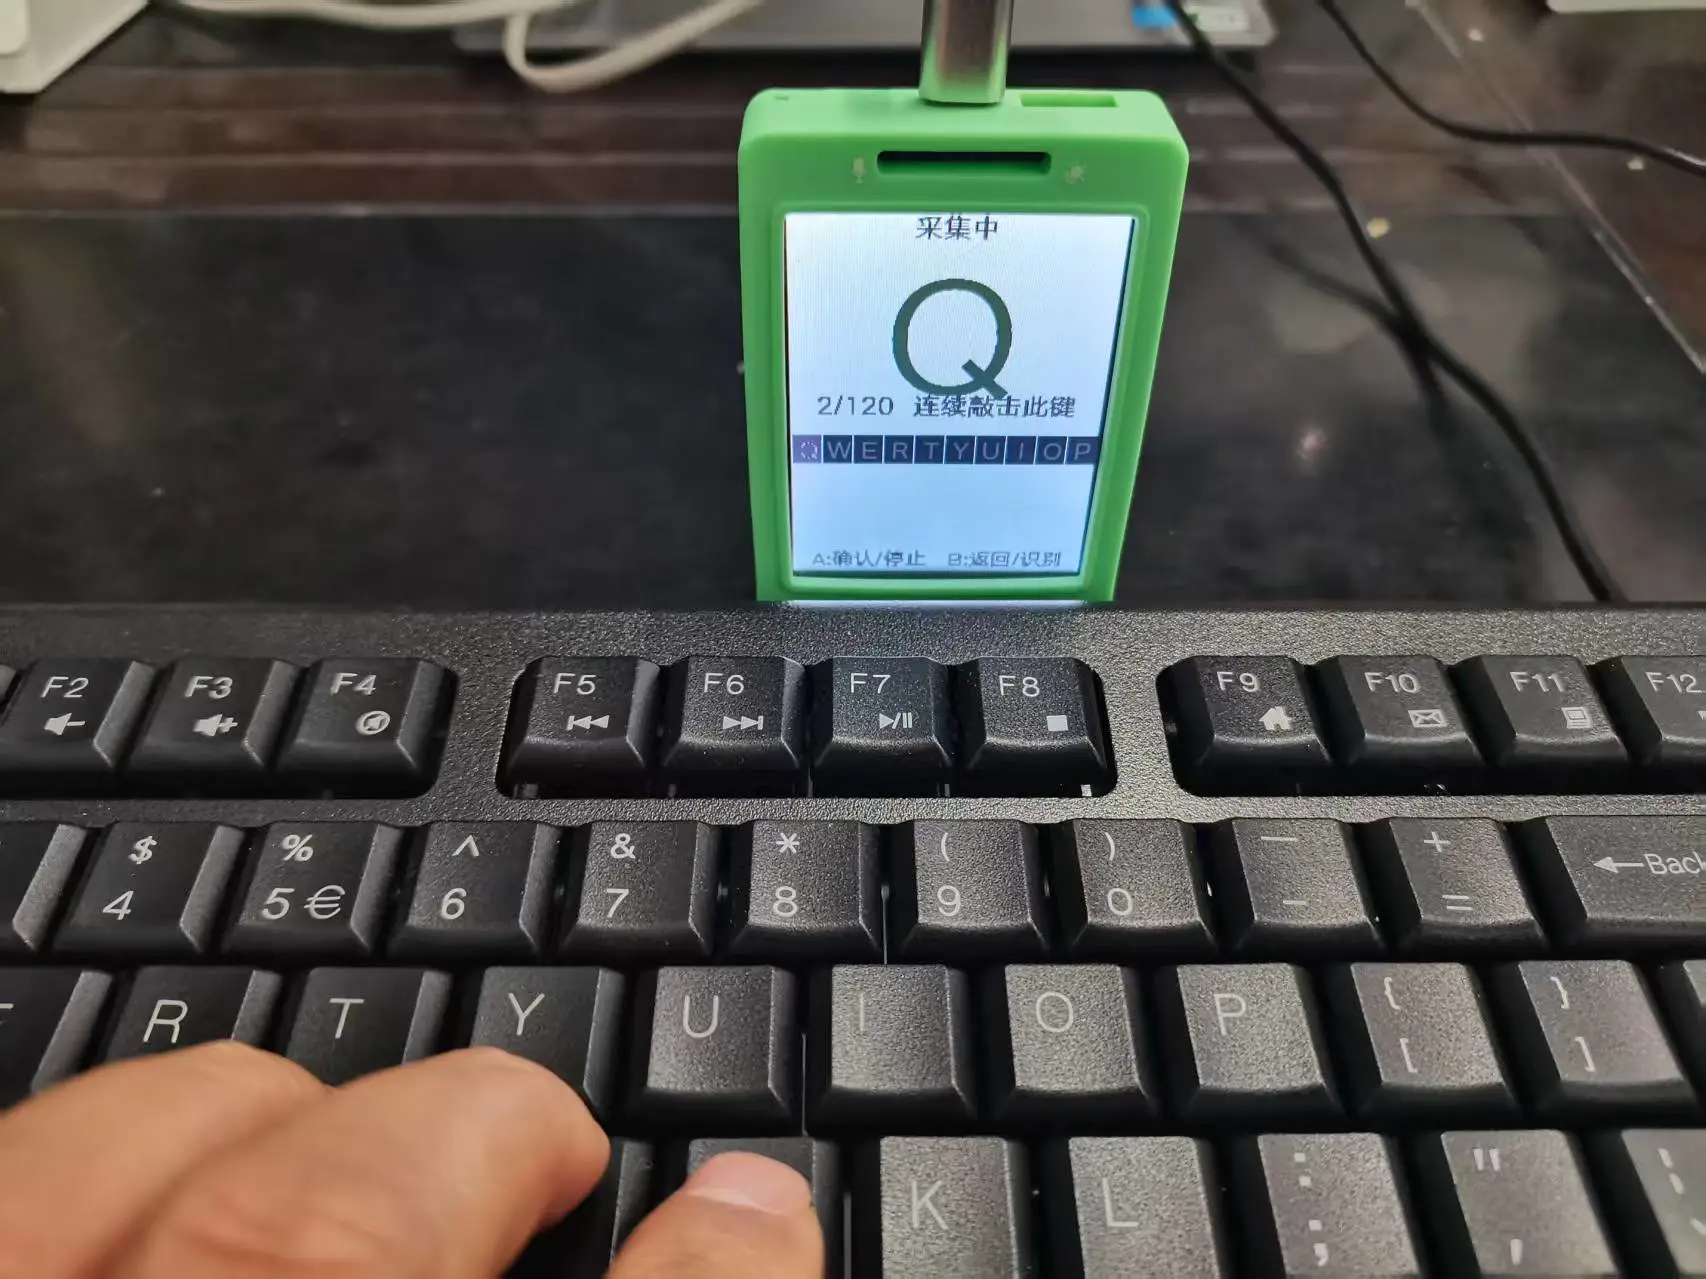
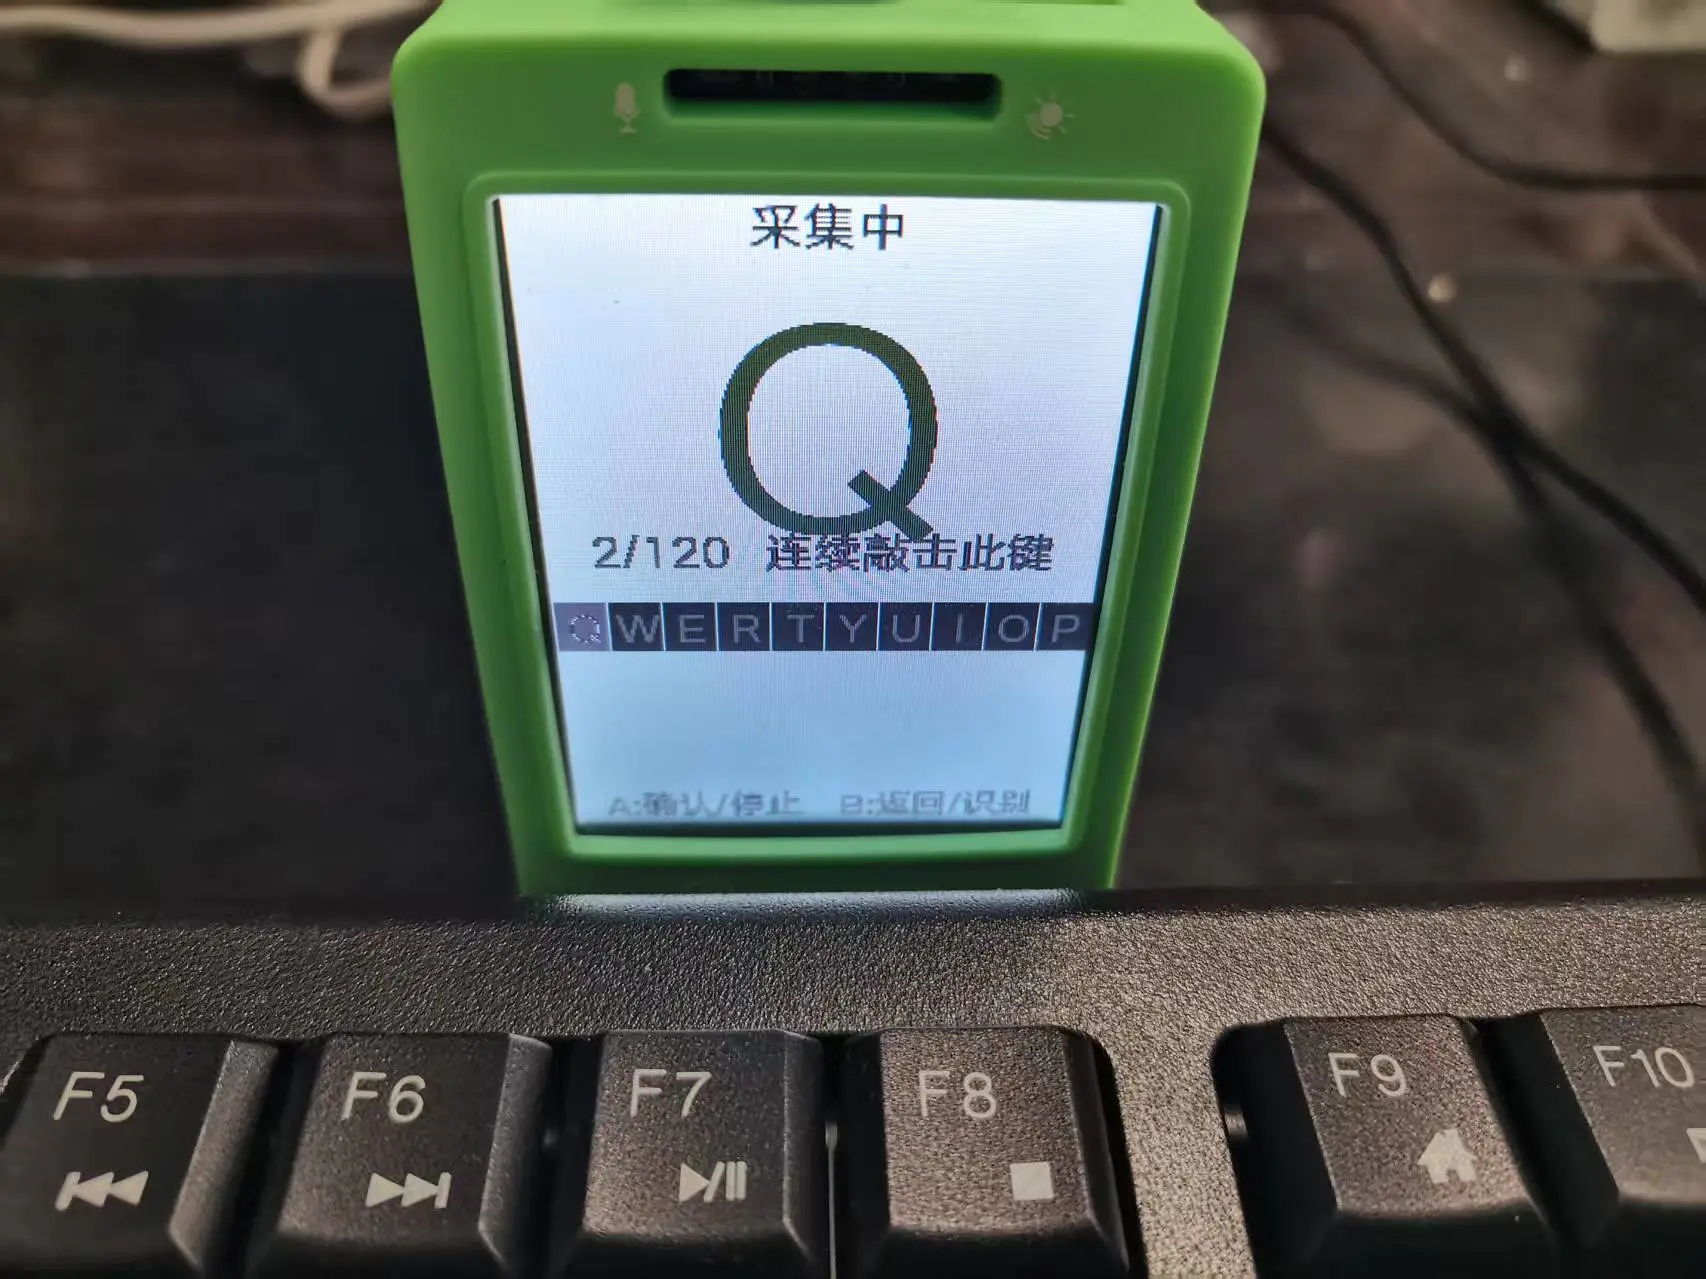
- 板子放键盘旁 5~15 cm,麦克风朝键帽,环境保持安静;
- 菜单按 A,先倒数 2 秒(松手、放稳板子),再静音校准约 1.5 秒;
- 屏幕出现大字母(如
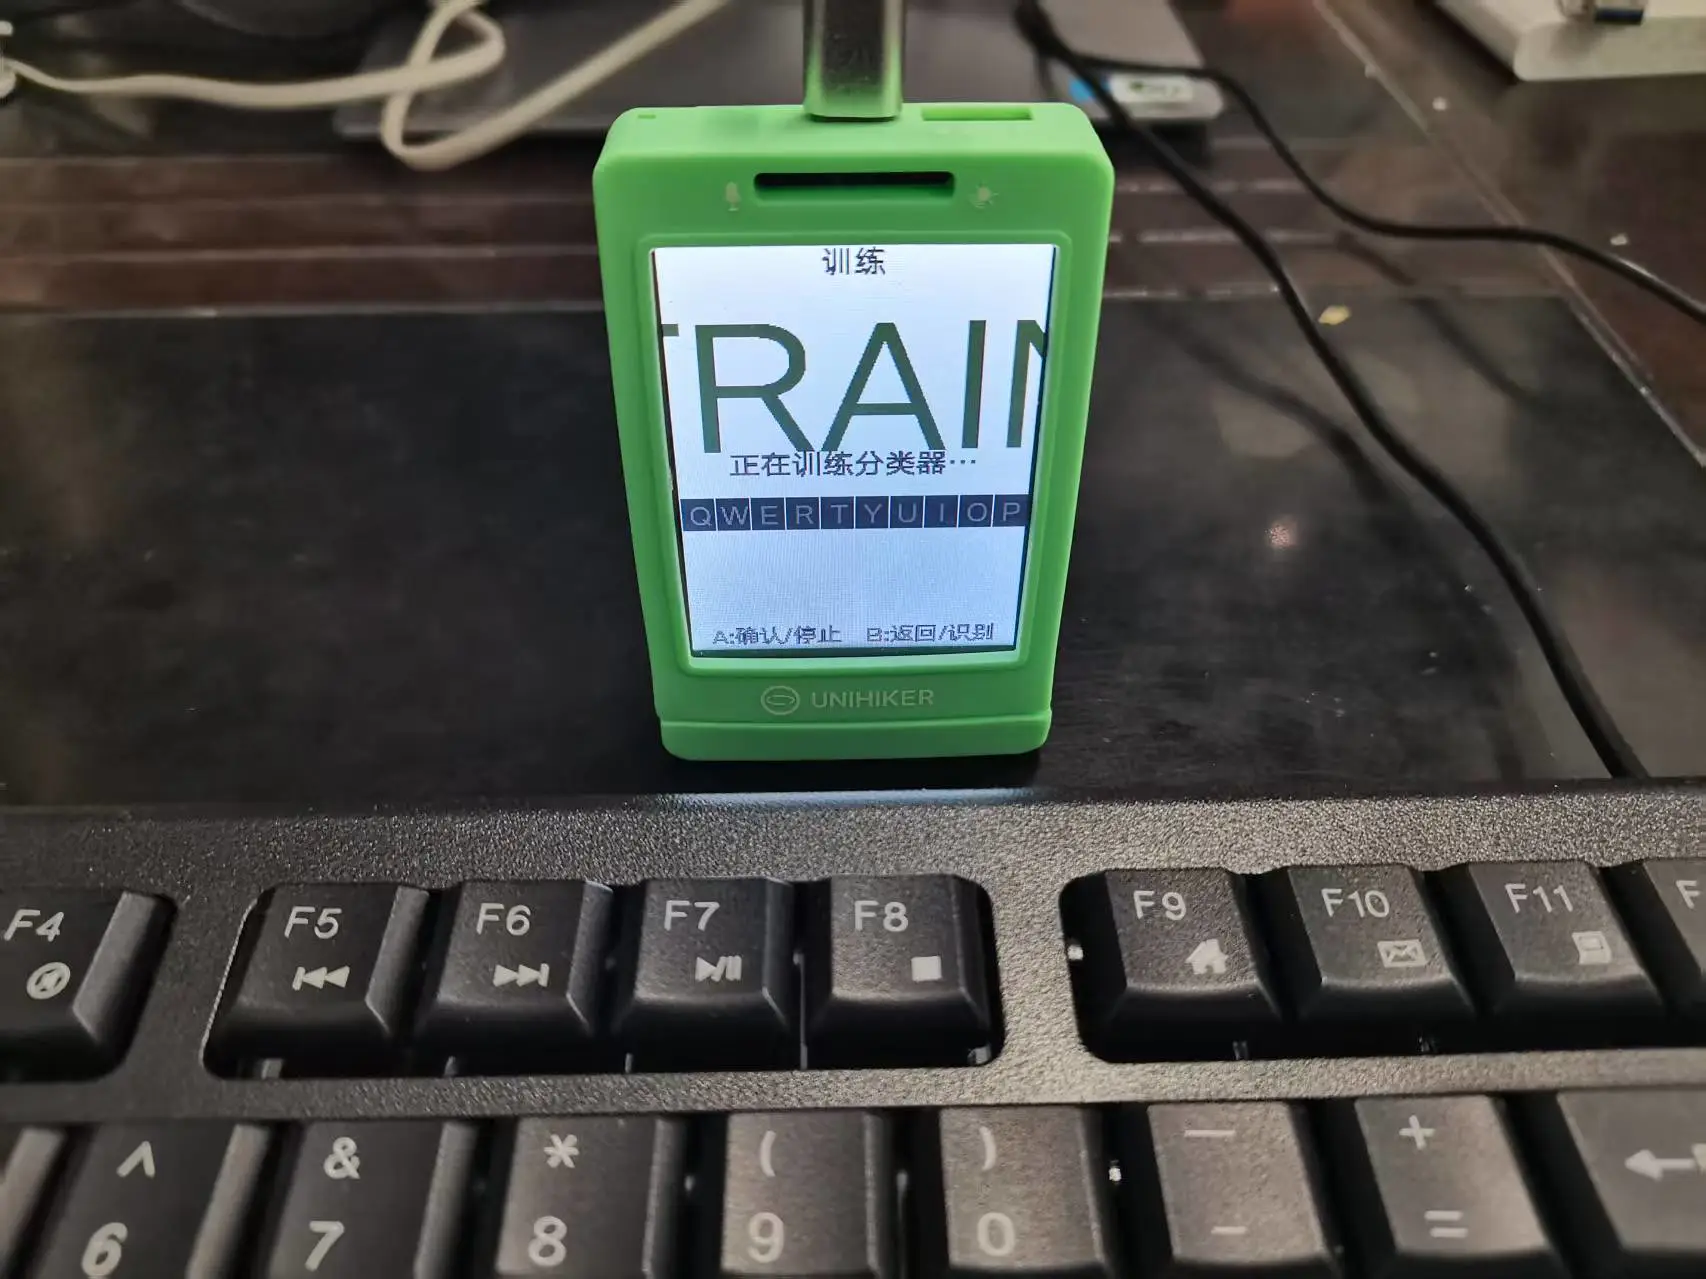
Q),连续自然敲这个键 120 次,下方显示当前数/总数; - 采满自动切下一个键,全部采完自动训练,显示交叉验证准确率;
- 菜单按 B 进入实时识别,敲键即显示结果 + 虚拟键盘高亮 + 置信度 Top3。
命令行参数:
| 参数 | 说明 | 默认 |
|---|---|---|
--keys |
训练的键,如 QWERTYUIOP 或 "A S D F" |
QWERTYUIOP |
--reps |
每个键采样次数 | 120 |
--sensitivity |
触发灵敏度 1–10 | 5 |
--gap_ms |
击键间隔:合并回弹/余振的窗口 | 280 |
--settle |
按 A/B 后静置等待秒数 | 2.0 |
--calib_ms |
静音校准时长毫秒 | 1500 |
--device |
录音设备索引 | 自动选板载麦克风 |

八、调参经验
- 一次按键被算成多次 → 调大
--gap_ms(把余振合并更彻底),或调小--sensitivity; - 漏检(敲了没反应) → 调小
--gap_ms、调大--sensitivity,或把板子挪近键盘; - 松键/放板声被采进去 → 调大
--settle(比如 3 秒); - 换麦克风或采样率 → 必须重训,声纹不通用。
九、关于重复训练的几个问题
很多人会问:训练过一次再训练会影响原来的模型吗?
- 每次按 A 都会新建空数据集,旧样本不继承,从头采;
- 只有全部采满、训练真正跑完才会用新数据覆盖
keysnoop_model.pkl(无备份); - 中途停止不写盘、不做训练,旧模型分毫未动,回菜单按 B 仍能用旧模型识别,本次采的一半样本作废;
- 唯一注意:一旦进入
TRAIN阶段(自动训练),fit + save会一口气跑完,此时按停止也拦不住这次覆盖。想保住旧模型就在全部采满前停。
十、效果、局限与结语
验证结果:
-
PC 自检:切分 80/80、Top-1 100%,存盘加载一致;
-
板载麦克风:44100 Hz 稳定流式采集,校准正常,GUI 显示正常,主程序长时间运行无报错。
局限也很明显:
- 这是声学侧信道实验,请在自己的键盘上、用于合法合规的学习和创作;
- 每个键盘 + 麦克风组合的声纹都不同,必须用自己的设备训练;
- 键位越多越难,建议先用一行 10 个键跑通再扩展;机械键盘明显优于薄膜键盘;
- 板载麦克风灵敏度有限,追求效果建议插 USB 麦克风并靠近键盘。
这个项目最有意思的地方在于:它把一个听起来很「黑客」的侧信道攻击概念,拆成了录音 → 检测 → 特征 → 分类这几个标准的信号处理步骤,然后在行空板这块小板上完整落地。你既能学到声学特征工程的实际套路,又能体验嵌入式部署的各种真实坑——尤其是那个静音 Loopback,估计每个在行空板上做音频的人都会踩一次。
完整代码已放在项目目录:unihiker_app.py(行空板版)、keysnoop/(核心算法)、app.py + web/(PC 网页版,保留)。欢迎在 DF 创客社区交流,你的键盘识别准确率能到多少?