花雕动手做|480×480 上的四版动态视觉:ChatCoding 渲染开销实录与调优复盘
——从 10fps 到 15fps,每一帧的 90 毫秒究竟花在哪里——以及四条与直觉相反的成本规律
## 缘起:四个视觉方案,同一个性能账本
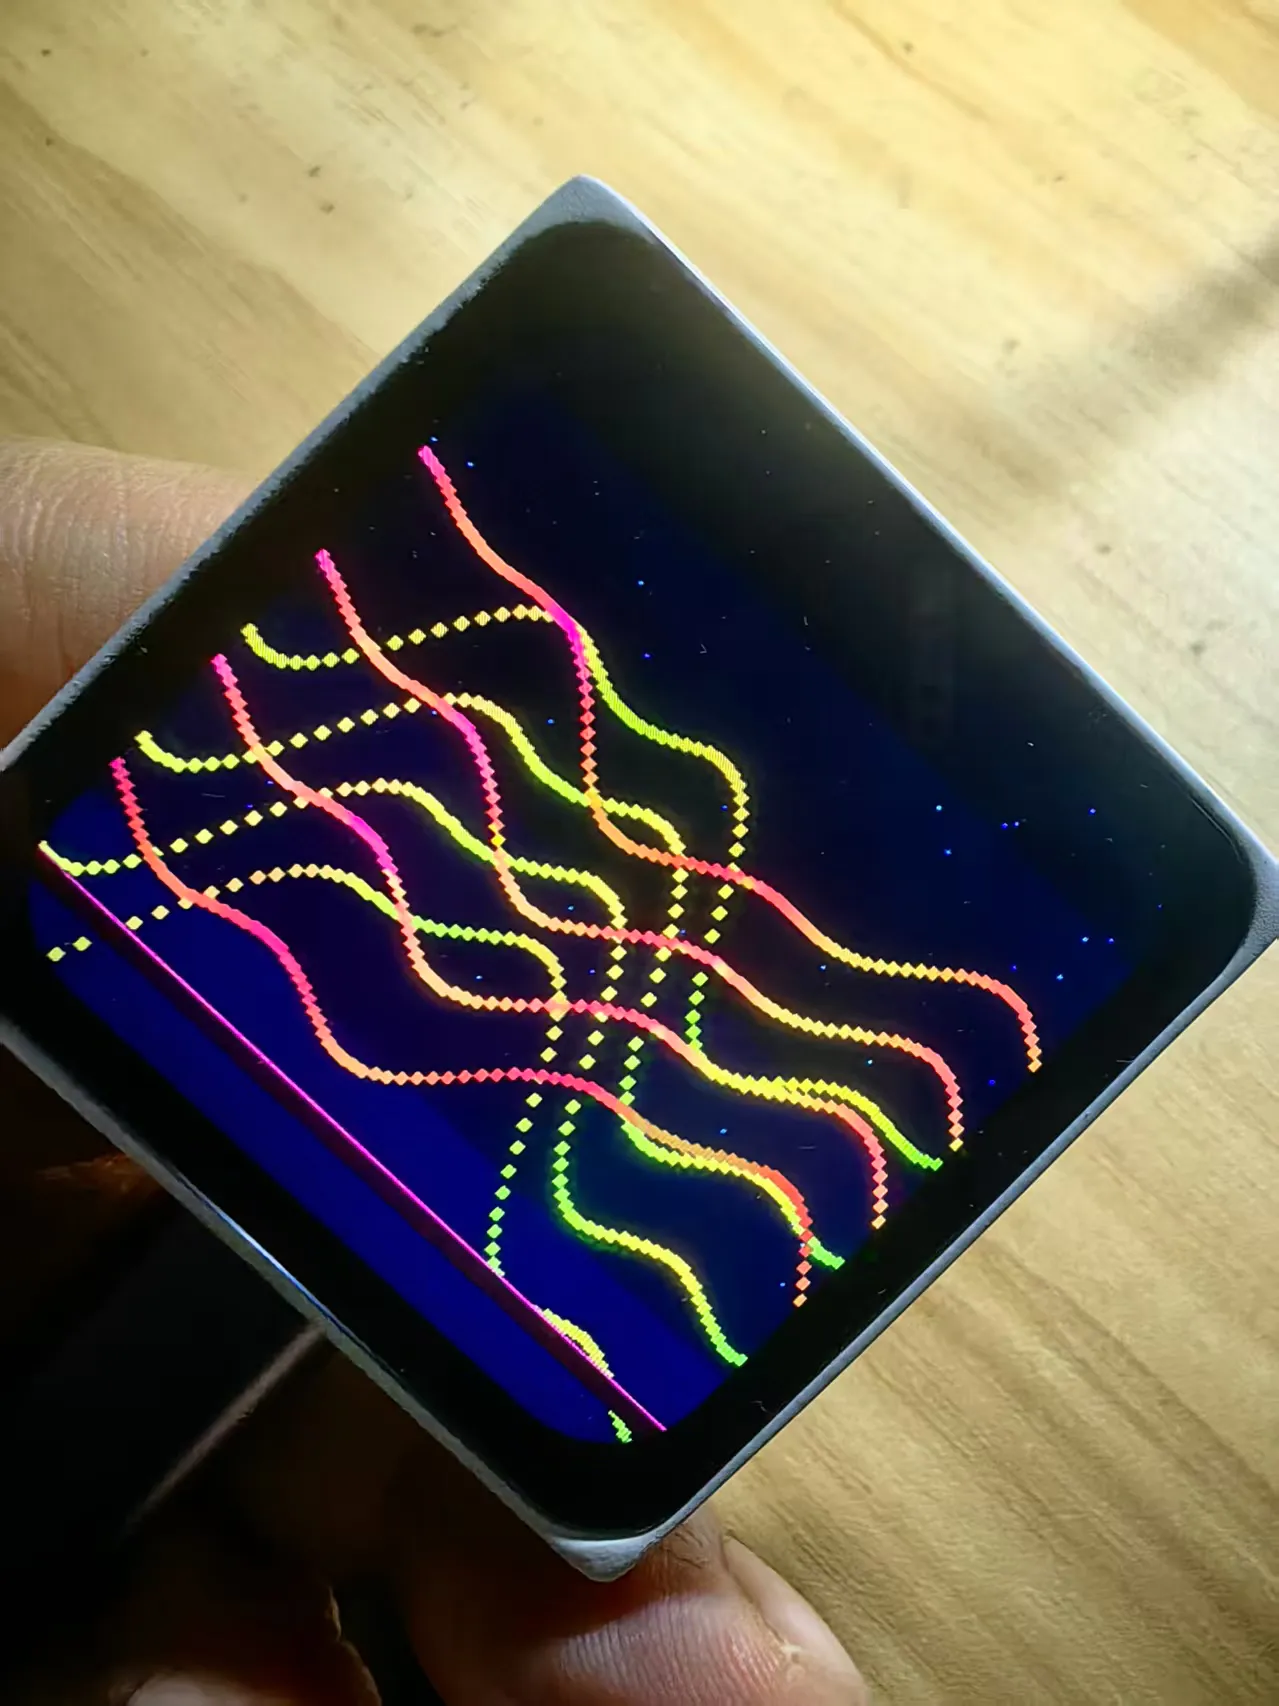
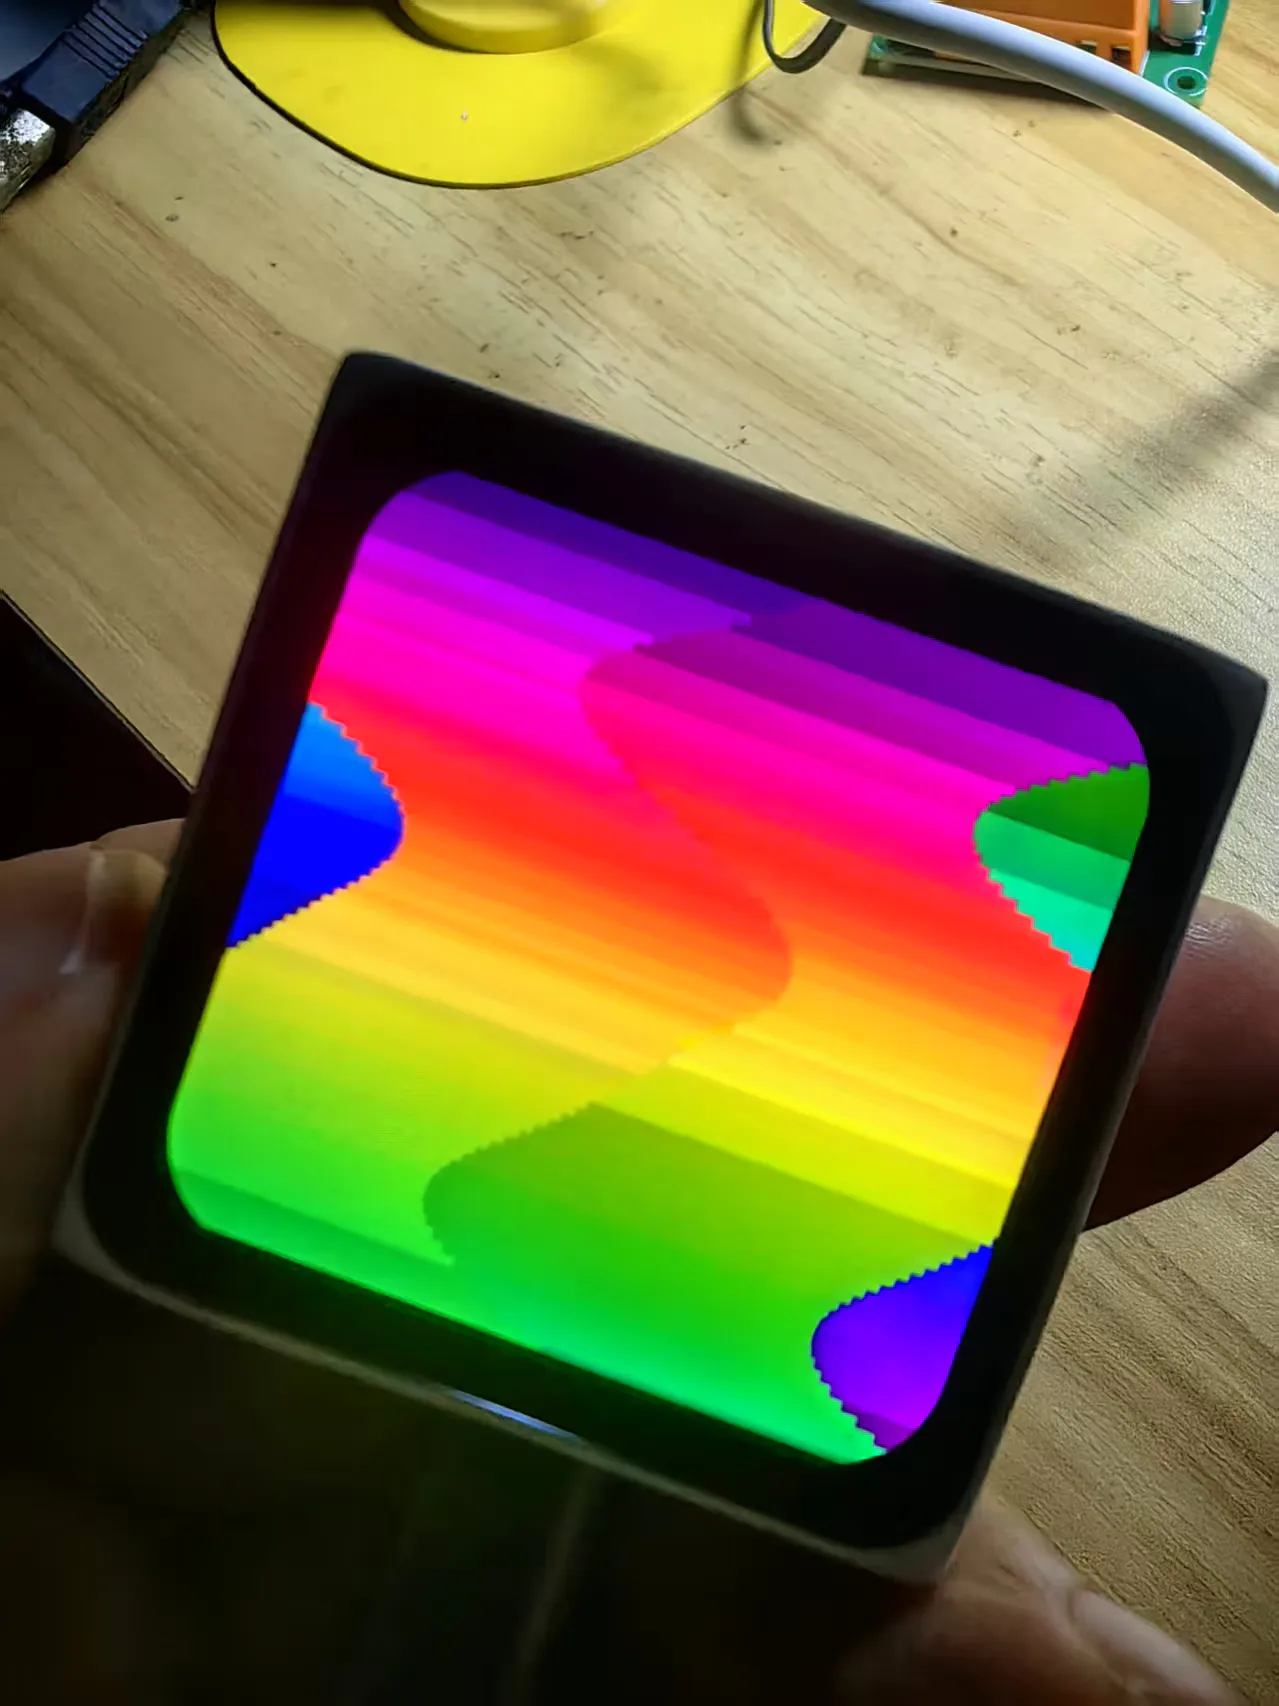
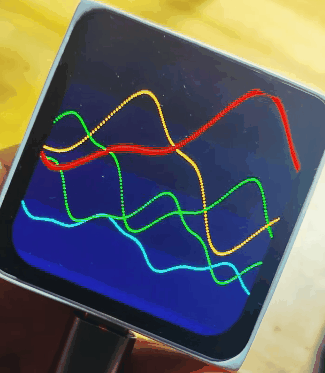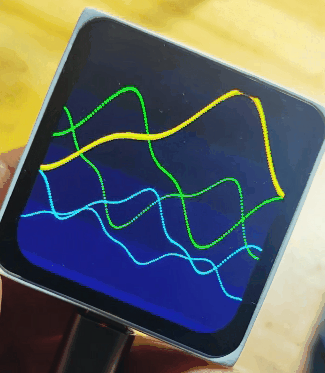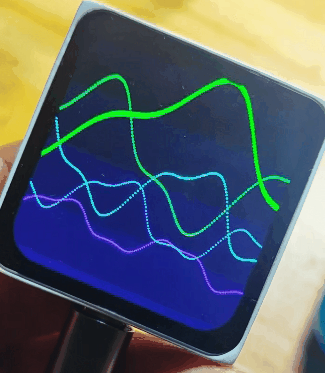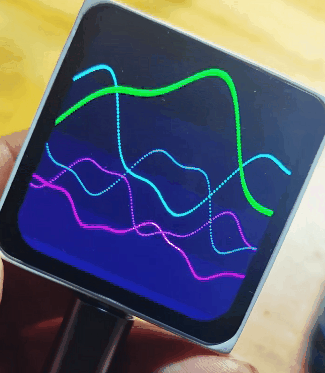
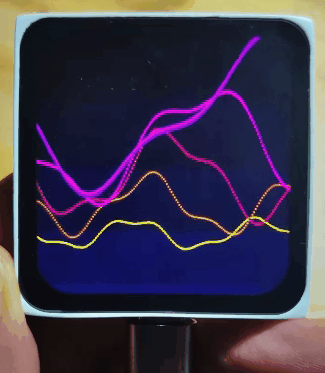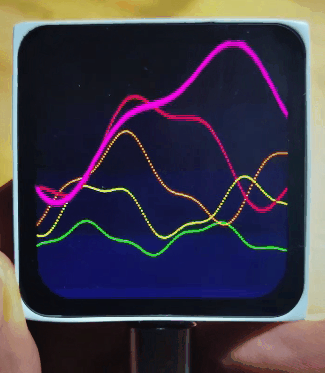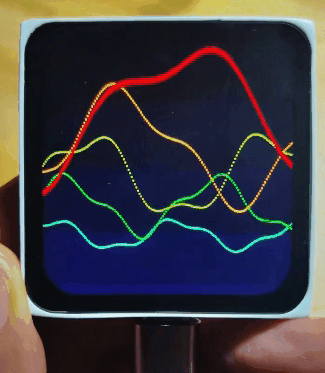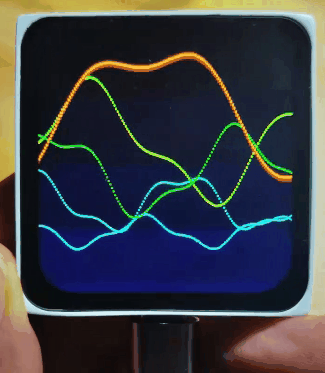
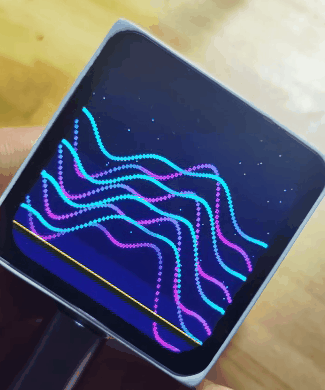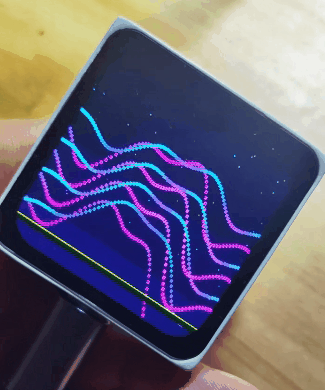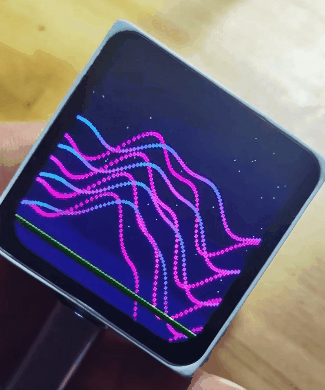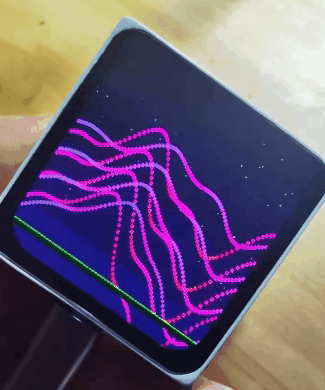
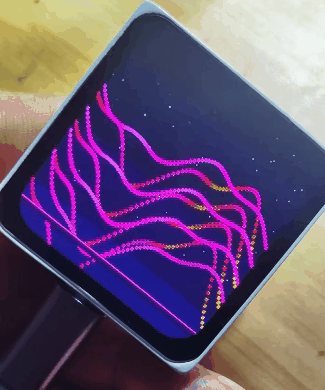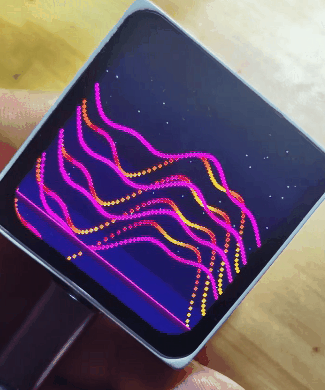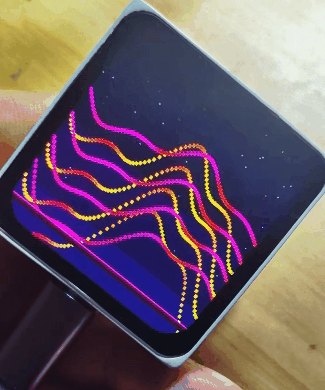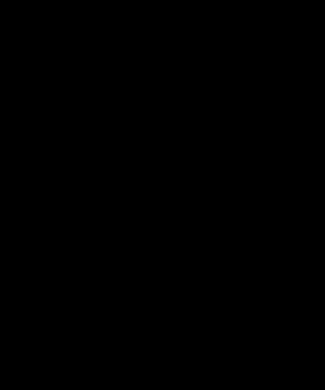
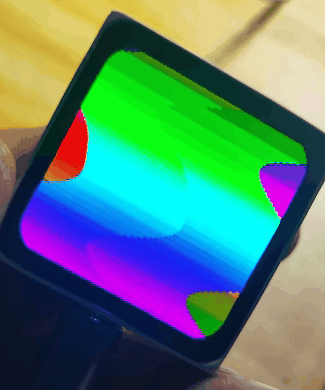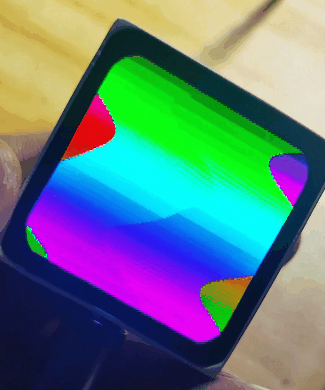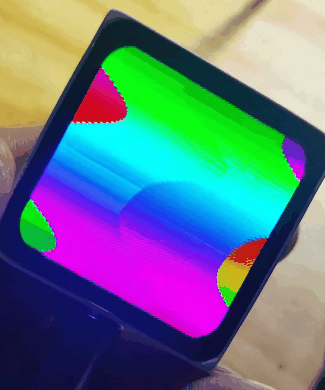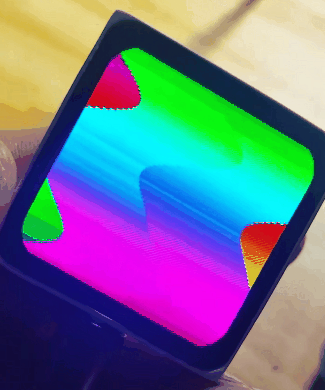
在 ESP-Mosaico 的 480×480 方形屏上,用 ChatCoding 连续做了四版动态视觉:流动彩色正弦波浪、极光窗帘 + 星空、霓虹故障艺术、丝绸剪切。
风格跨度很大,但把四版的实测数据摆在一张表里,浮现出来的规律高度一致——真正的瓶颈不在画面复杂度,而在几个平台层面的固定成本结构。
这篇把它拆开讲清楚。
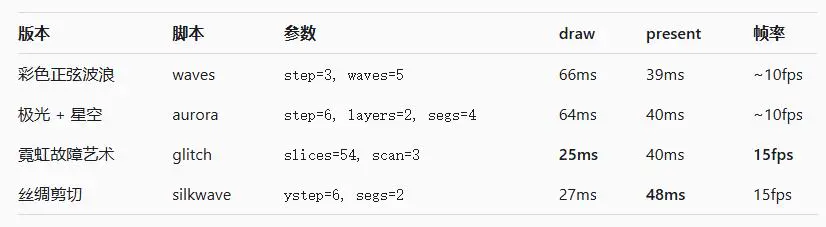
四版的 draw 从 25ms 到 66ms 翻了两倍多,帧率却只从 15fps 掉到 10fps。原因一眼可见:present 稳定在 39–48ms,占据了单帧的大半时间。优化 draw 的收益,被这道地板吃掉了大半。
正弦波浪对话截图
## 一、present 是唯一的硬地板
present 也就是把整帧推到屏上,四版分别是 39 / 40 / 40 / 48ms,几乎不随画面内容变化。这个数字值得单独盯着看:480×480 的 RGB565 单帧数据量约 450KB,present 的耗时主要由传输带宽决定,而不是由你画了什么决定。
由此得到一个必须写进设计前提的推论:
帧率天花板由 present 锁死。 present 40ms 时,理论极限就是 ~25fps,无论 draw 优化到多快。glitch 版画得最省,draw 只有 25ms,总帧仍被压到 15fps。
优化的边际收益在 draw 侧,但存在明显下界。 当 draw 降到 25ms 附近,继续压 draw 对帧率的贡献已经很小(25→0 也只能从 15fps 到 25fps,何况不可能),此时应该转向脏矩形局部提交、降刷新区域,而不是继续抠单像素开销。
换句话说,这张屏的工程现实是:先接受 40ms 的地板,再在剩下的 40ms 里排布你的 draw 预算。
## 二、反直觉规律一:fill_rect 的成本看行数,不看面积
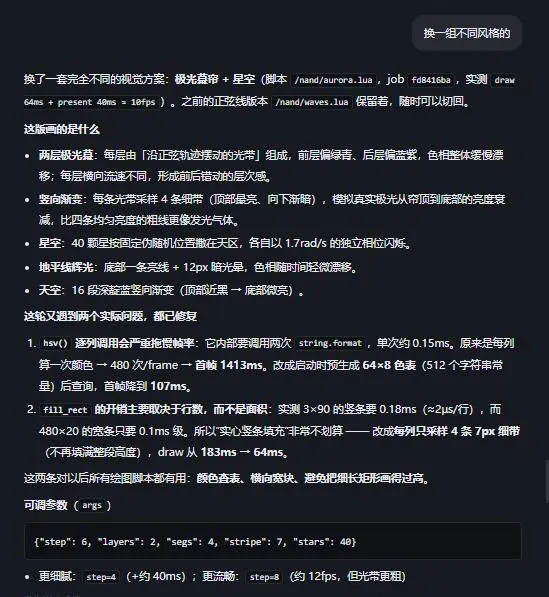
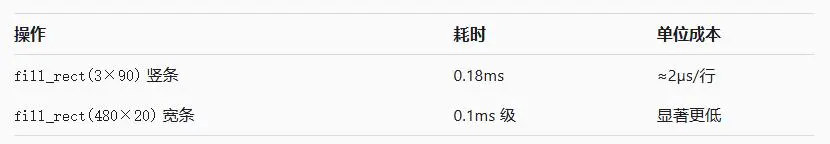
四版里最有价值的发现来自 aurora 版。实测两组数据:
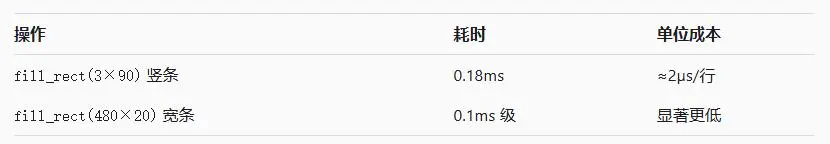
一根 3×90 的细长竖条(270 像素)要 0.18ms,而一块 480×20 的宽条(9600 像素,面积是前者的 35 倍)只要 0.1ms 级。结论非常明确:
矩形填充的开销与行数(扫描线数量)强相关,与面积关系弱得多。
这是软件光栅化的典型特征——每行的地址推进、裁剪判断、写入启动都有固定开销,行数越多越吃亏,而同一行内横向多写几十个像素几乎免费。慢的根源是"行数",不是"像素数"。
这条规律直接改掉了 aurora 的绘制方式:原本每列填满整段高度,改成每列只采样 4 条 7px 细带(不再填满整段),draw 从 183ms 骤降到 64ms。视觉上反而更像发光的极光气体——顶部最亮、向下渐暗,比四条均匀亮度的粗线更接近真实光帘。
由此推出的两条绘制纪律:
优先横向铺满,避免大量细长竖条。 同样的视觉意图,横着画几乎总是更便宜。
宁可稀疏采样,不要连续填满。 视觉上的"发光衰减"可以用几条细带模拟,不需要真的逐行填出渐变。
## 三、反直觉规律二:line() 应当直接判出局
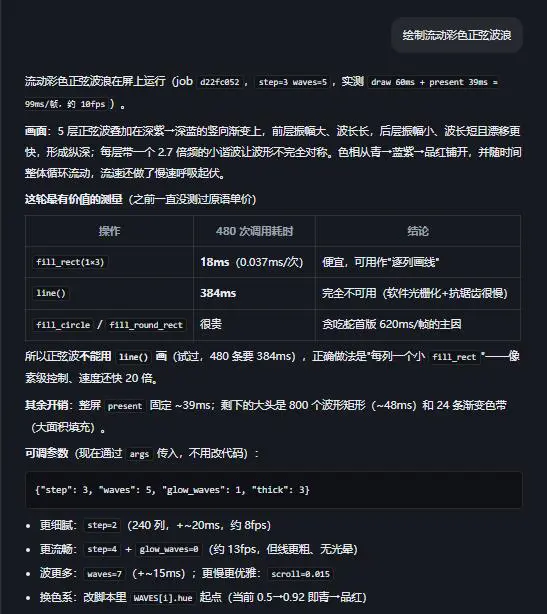
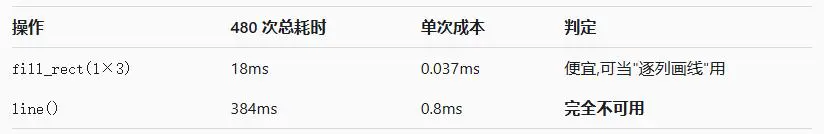
waves 版做过一组 480 次调用的对照测试,结果差距悬殊:
同样画 480 条线,line() 比 480 个 1×3 小矩形慢 21 倍。原因是 line() 走的是软件光栅化加抗锯齿路径,单次调用成本高出两个数量级。而"贪吃蛇"首版 620ms/帧的主因也在这里——它用了 fill_circle / fill_round_rect 这类高级图元,同样落在昂贵路径上。
所以四版里没有一版用 line() 画曲线,统一改成"每列一个小 fill_rect"来逼近曲线,用像素级控制换回 20 倍以上的速度。这是一条一旦踩过就再也不会忘的纪律:
基础矩形填充是快路径,高级图元(直线、圆、圆角、抗锯齿)是慢路径。曲线用离散矩形逼近,而不是调用曲线 API。
## 四、反直觉规律三:颜色格式化是隐形大头
aurora 版暴露了第二个杀手:hsv() 逐列调用。它的内部要执行两次 string.format,单次约 0.15ms。逐列算颜色意味着每帧 480 次调用,首帧直接冲到 1413ms。
修复方式不是优化 hsv(),而是彻底不在热路径里算颜色:启动时预生成一张 64×8 的色表(512 个字符串常量),运行时只做查表。首帧从 1413ms 降到 107ms,快了 13 倍。
这条与之前讨论过的"256 项可热替换调色板"完全同源:颜色计算必须前置到初始化,热路径只允许查表。字符串拼装在 Lua 沙箱里是极重的操作,任何涉及 format、拼接、动态生成颜色的调用,都不能出现在逐像素或逐列循环里。
waves 版的剩余开销也印证了这一点:除 present 的 39ms 外,大头是 800 个波形矩形(~48ms) 和 24 条大面积渐变变色带——都是填充和颜色相关的操作,与"行数成本"和"色表查表"两条规律直接对应。
## 五、非线性拐点:为什么稳定点是 54 条而不是 72 条
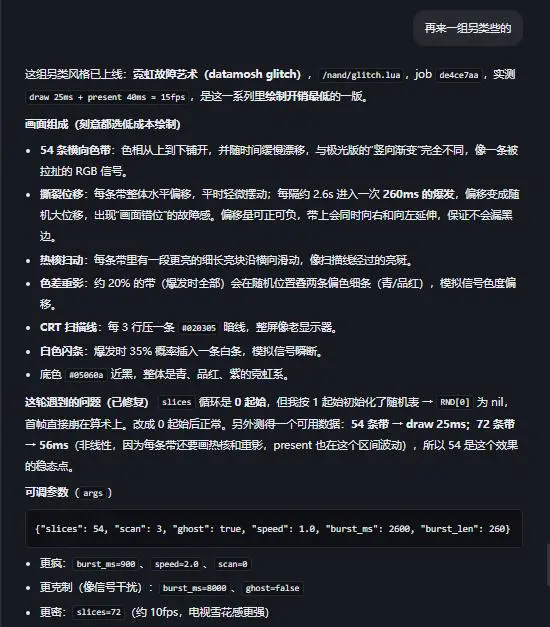
glitch 版给出了一组很关键的非线性数据:
元素数量只增加约 33%,耗时却涨了 124%。这不是线性关系,说明存在一个成本拐点——超过某个条带密度后,单帧开销被放大。截图里没有给出放大机制的具体来源(可能来自每帧固定开销、缓存局部性,或系统里其他任务的争抢),但工程结论是明确的:
性能不能靠外推估算,必须逐档实测扫描,找到那个"稳定点"。 54 条是 glitch 的稳定点,不是随便取的整数。
这也是"线性算力承诺"在真实设备上的一份实测注脚——算法层面可以是 O(n),但硬件层面的常数项会随规模变化,拐点只能测出来,不能推出来。
## 六、帧时间波动:为什么要按"稳定档位"选,而不是按最好值
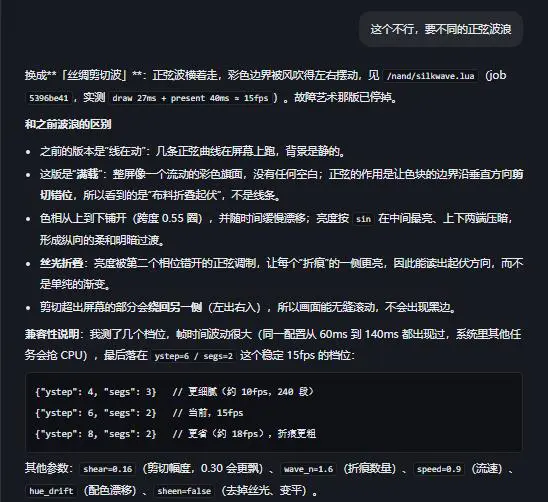
silkwave 版遇到的情况很典型:同一档位下,帧时间在 60ms 到 140ms 之间反复波动,原因是系统里其他任务会抢 CPU。最终落定在 ystep=6 / segs=2 这个能稳定跑 15fps 的档位,而不是选那个偶尔能冲到更快、但抖动剧烈的配置。
这在嵌入式屏效里是一条容易被忽视的判据:目标不是一个漂亮的峰值帧率,而是一条平稳的帧时间曲线。 抖动的画面(时而流畅时而卡顿)比稳定偏慢的画面观感差得多。因此每档的选型标准应当是"最坏情况下的帧时间是否可接受",而不是"平均值好不好看"。
silkwave 给出的三档预设本身就是按这个标准排的:
{"ystep": 4, "segs": 3}   // 更细腻,约 10fps(240 段)
{"ystep": 6, "segs": 2}   // 当前,稳定 15fps
{"ystep": 8, "segs": 2}   // 更省,约 18fps,折痕更粗
## 七、一个 nil 下标崩掉首帧
glitch 版踩的坑值得单独记一笔:slices 循环从 0 起始,但随机表 RND 是按 1 起始初始化的,于是 RND[0] 是 nil,首帧直接崩在脚本上。改成 0 起始后恢复正常。
这是 Lua 数组下标习惯(1 起始)与循环变量习惯(0 起始)错位造成的典型边界错误,在沙箱里表现为首帧即崩,没有任何中间态可比对。它与之前确立的"数组下标钳制"是同一类防御:任何下标在访问前必须确认落在已初始化区间内,尤其是循环边界与随机索引。
## 八、视觉母题与算力成本并不正相关
把四版放一起看,有一个值得玩味的现象:
故障艺术(glitch) 视觉上最"激烈"——撕裂、爆发、色差重影、扫描线,但 draw 开销最低,只有 25ms,帧率最高(15fps)。
极光与丝绸 视觉上更柔和"高级",反而 draw 更高(64ms / 27ms)。
原因在于 glitch 的构图恰好落在快路径上:54 条横向色带——正是"宽条、少行数"的理想形态,一次填充覆盖整行,天然符合 fill_rect 的成本模型。而极光和丝绸需要沿列方向采样、需要精细的亮度衰减,更容易触发"细长竖条 + 高行数"的慢路径。
这给出一条选型层面的启发:视觉母题的选择直接决定算法成本的上界。在固定画布上,如果能在创意阶段就倾向"横向、大块、少行数"的构图,同样的创意强度可以用更少的 draw 预算换来。视觉冲击力和算力开销之间没有必然联系,选对形态就能两者兼得。
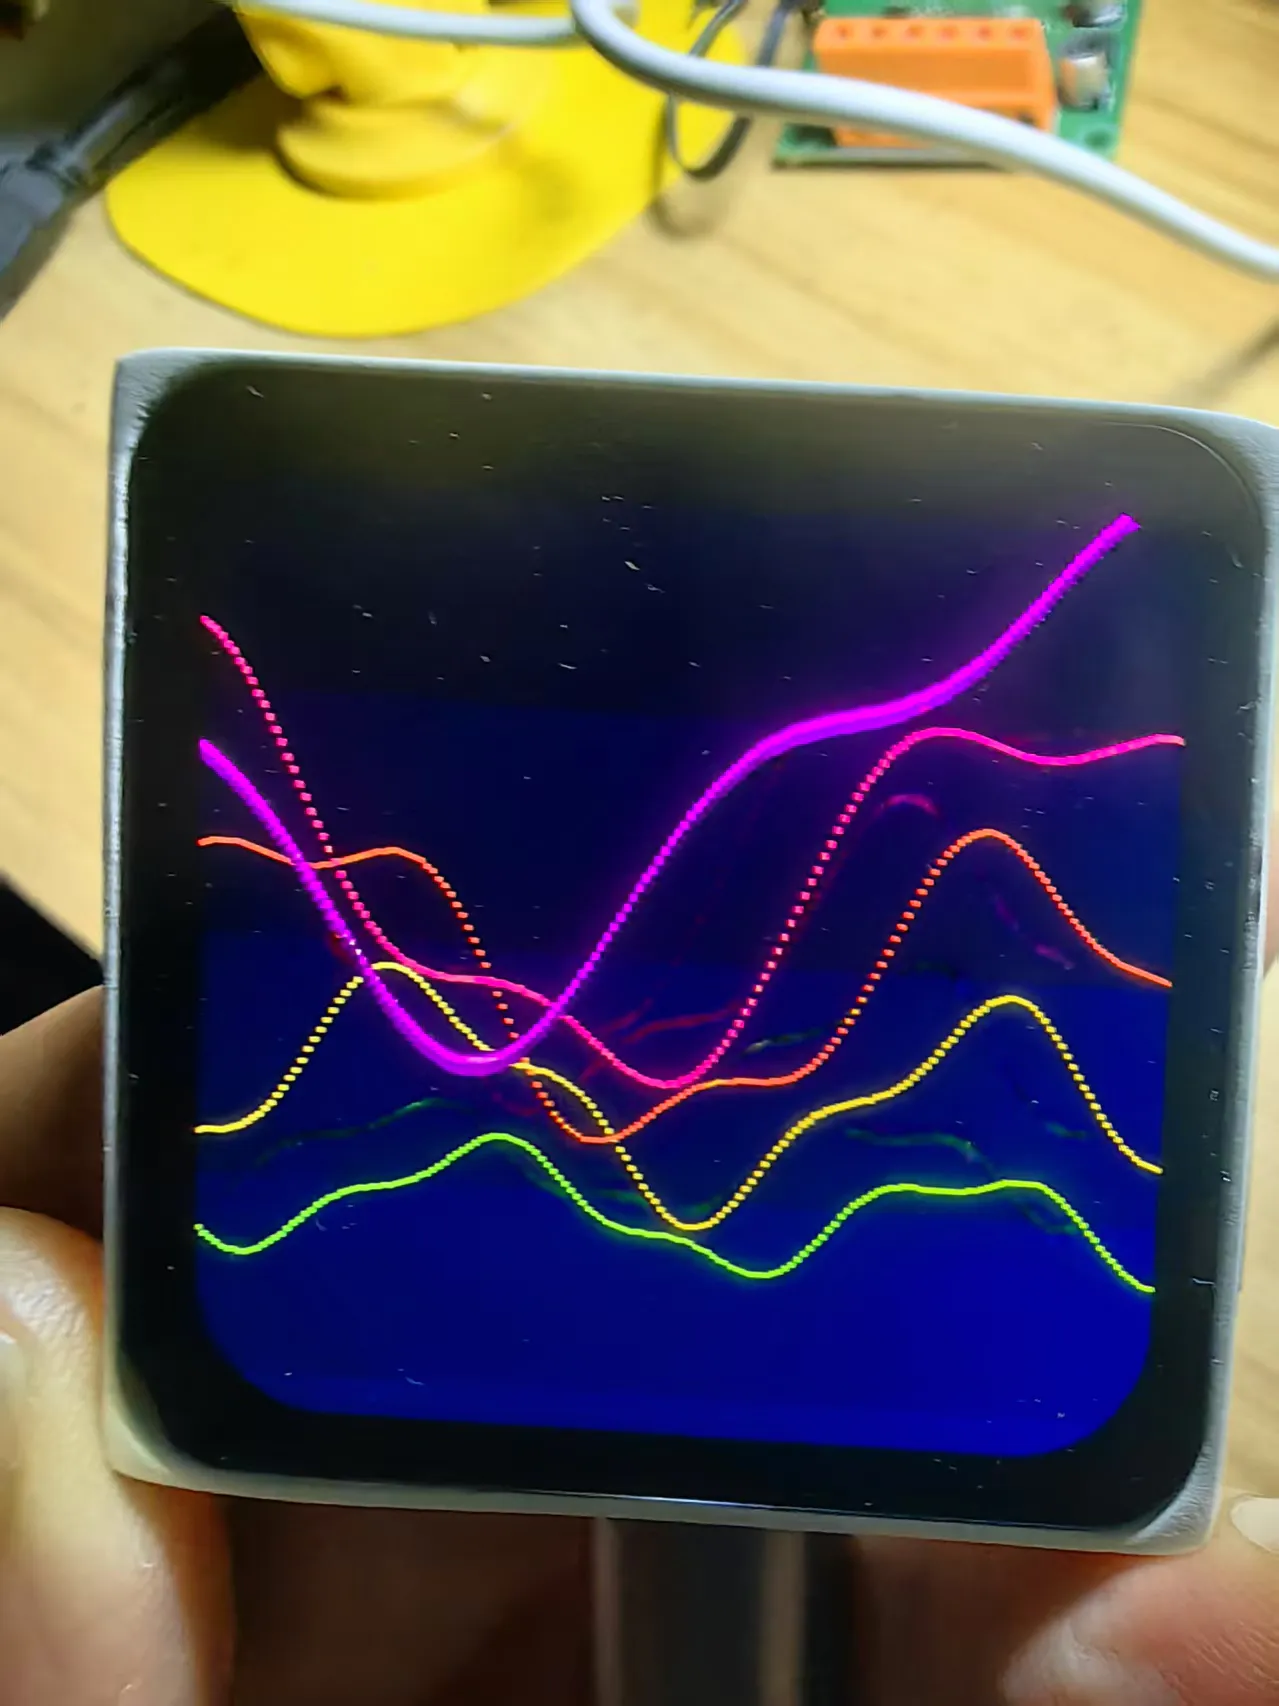
正弦波浪实验记录
## 九、四版共同收敛出的绘制纪律
把四版的实测经验压缩成可直接复用的清单:
先给 present 留好 40ms,再排 draw 预算;draw 降到 25ms 附近后,收益来自脏矩形与降刷新区域,而非继续抠像素。
优先横向填充,避免细长竖条;填充成本看行数,不看面积。
曲线用离散小矩形逼近,不调用 line();高级图元整体走慢路径。
颜色一律预生成查表,热路径禁止 string.format;逐列算颜色的代价是毫秒级累计。
性能逐档实测扫描,不用外推;非线性拐点只能测出来。
按最坏帧时间选档,不按峰值;稳定比快更重要。
所有下标访问前确认已初始化区间;循环边界与随机索引是崩溃高发区。
四版走下来,一个清晰的图景已经稳定:这张屏的性能账本里,真正的大头是 present 的固定成本、fill_rect 的行数成本,以及颜色格式化的隐性成本。三者都在"平台层",不在"算法层"。把这三处认清楚,再谈粒子数、迭代次数、数学映射的复杂度,才是在正确的预算结构里做优化。glitch 版用最低的 draw 换到最高帧率,恰恰说明了一个朴素但有用的结论——在固定画布上,聪明的构图选择比聪明的算法优化更早地决定了成败。