花雕动手做|掀开渲染底层的底裤!ChatCoding 手搓“音频频谱柱”与 AI 疯狂测速排障实录
博客标签:*ESP-Mosaico ChatCoding 性能优化 图形渲染 帧率测试 底层时钟*
## 导读:一个小小的柱状图,怎么就卡了?
在电脑上画一个 16 根柱子的音频频谱跳动,连小学生都能用 Canvas 秒做出来。
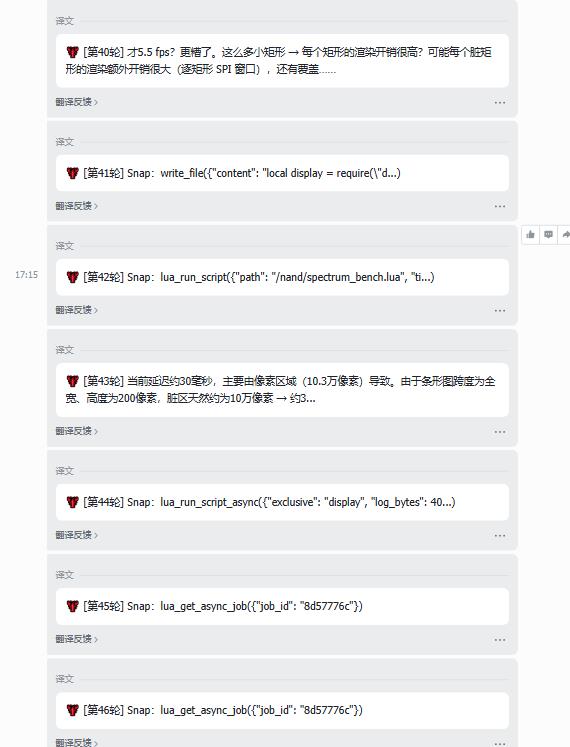
但在 ESP-Mosaico 的 480×480 Lua 沙箱里,当 AI 用伪随机数模拟频谱跳动时,却遭遇了极其惨烈的性能滑坡。从 17.8 帧掉到 11 帧,再到 5.5 帧,AI 陷入了疯狂的自我怀疑。
接下来,请欣赏这场由 ChatCoding 主导的“底层性能侦探案”。
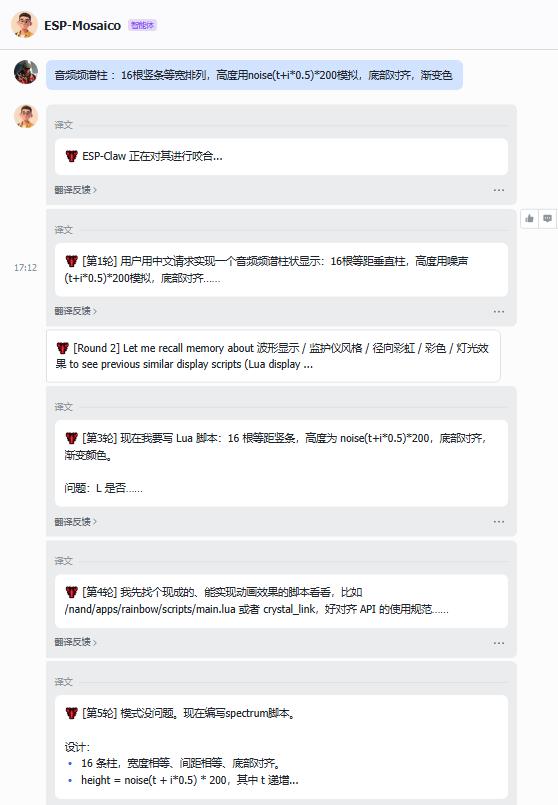
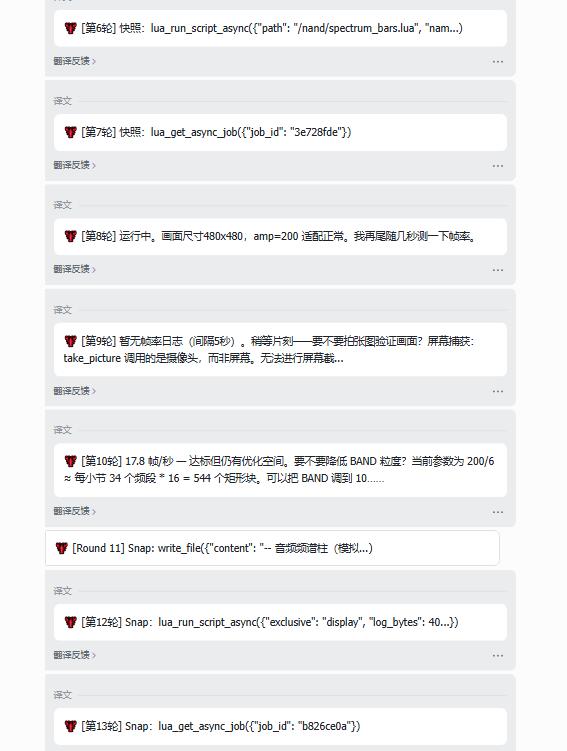
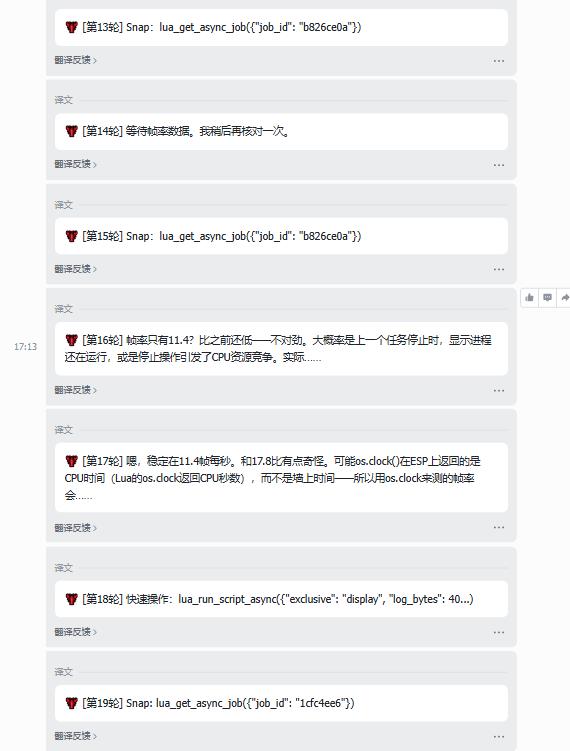
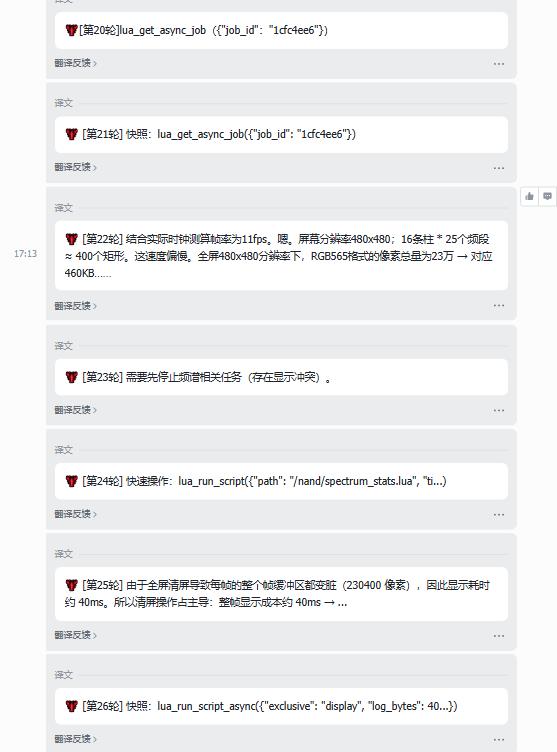
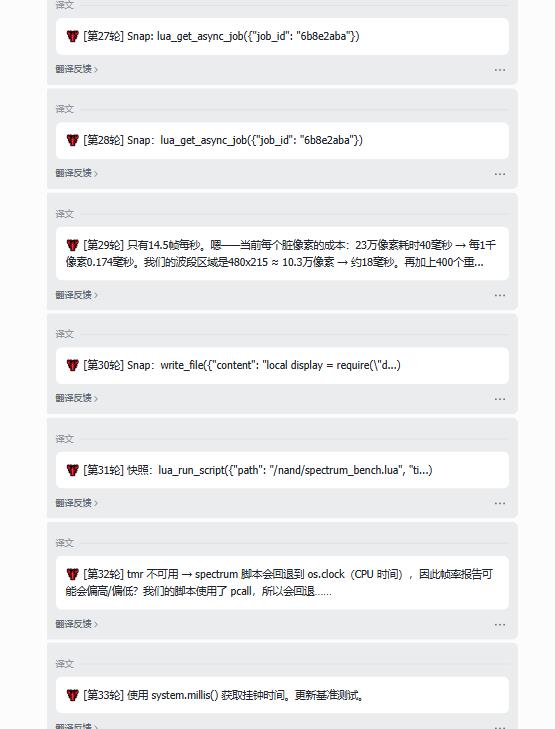
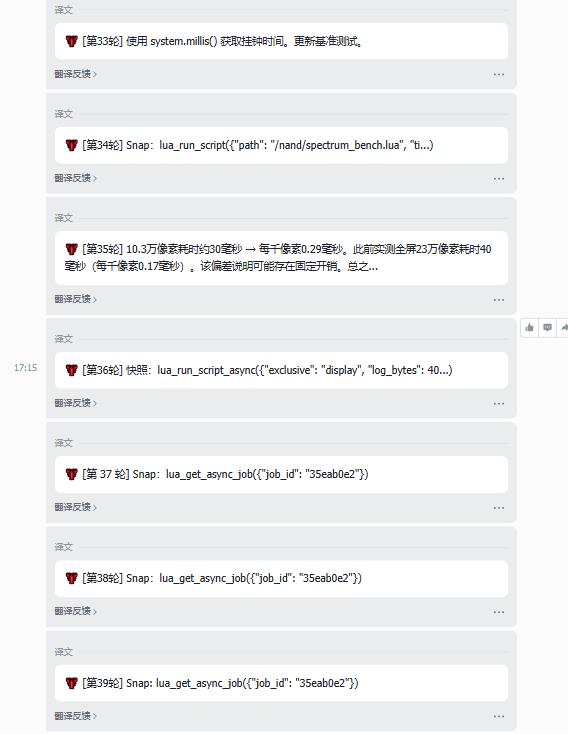
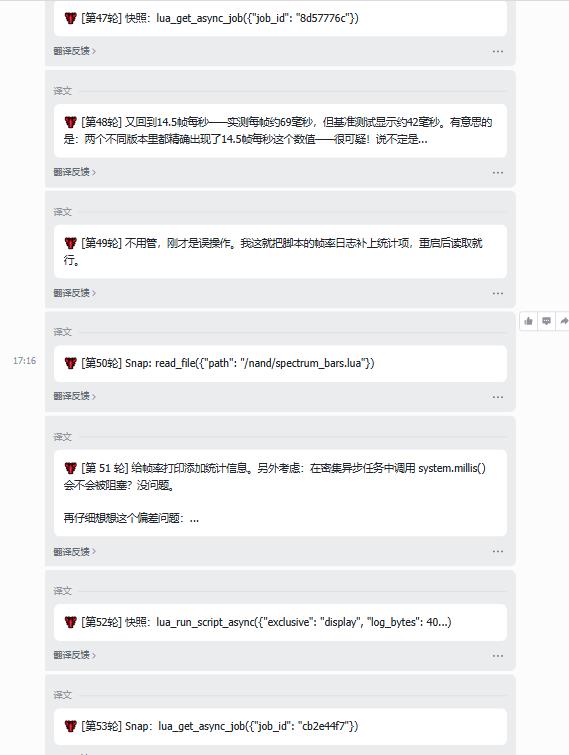
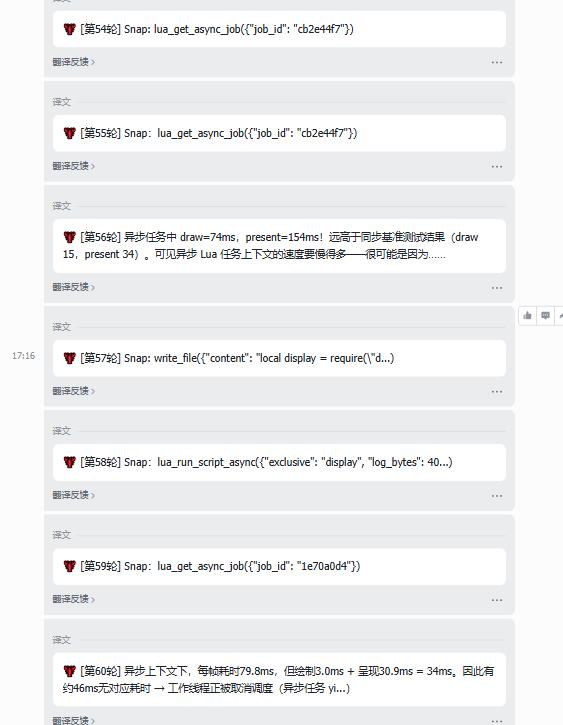
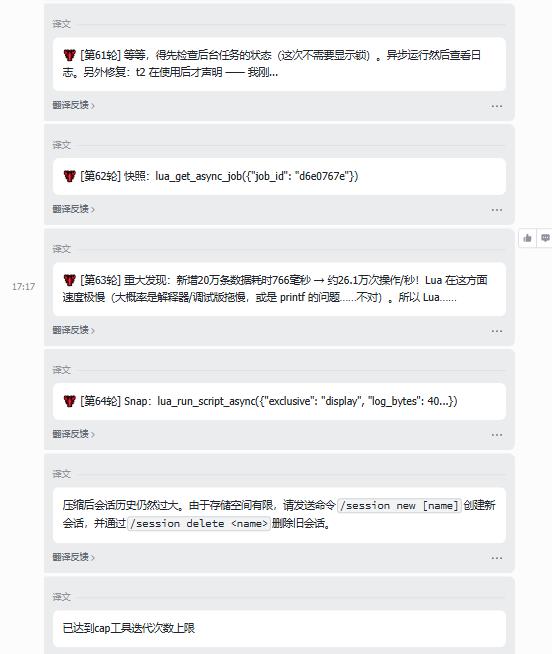
飞书对话截图
## 第一幕:幻象与初测(17.8 帧的假象)
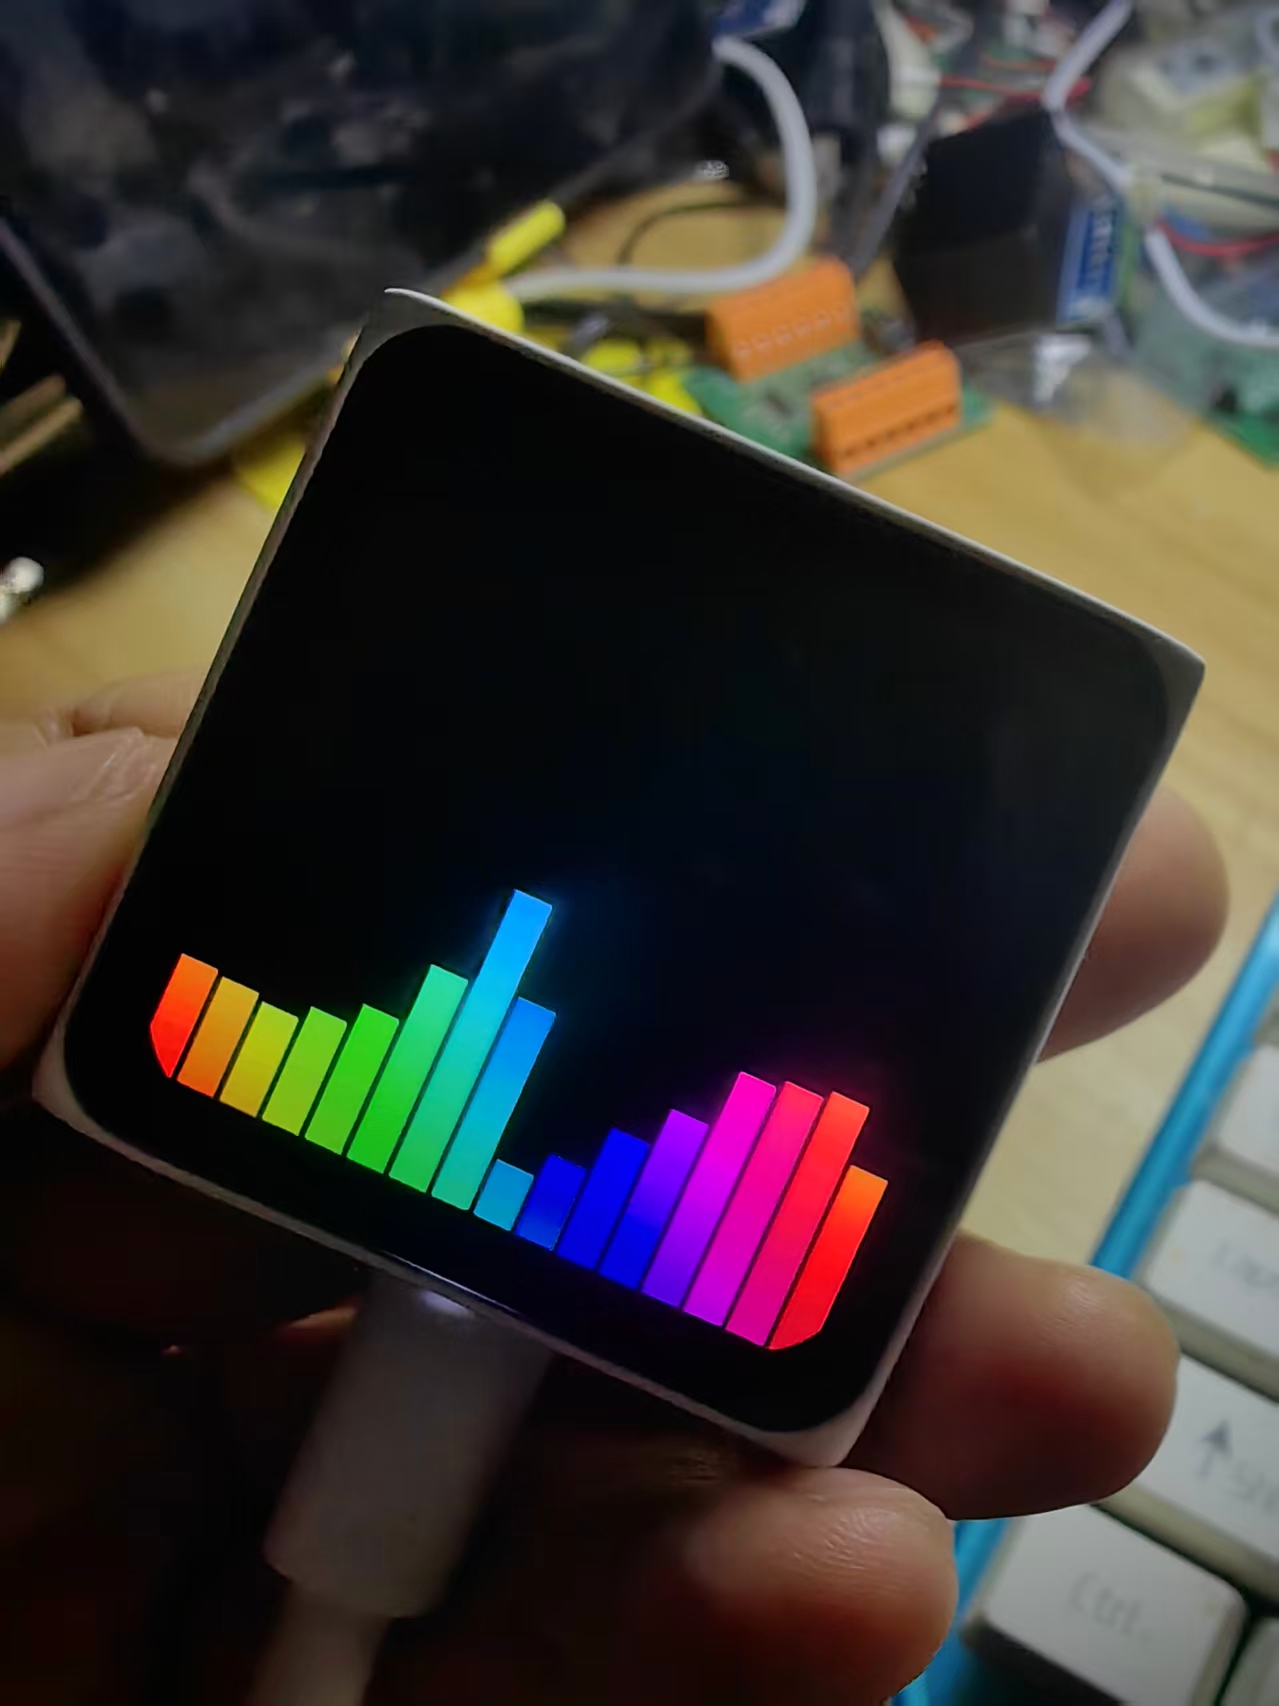
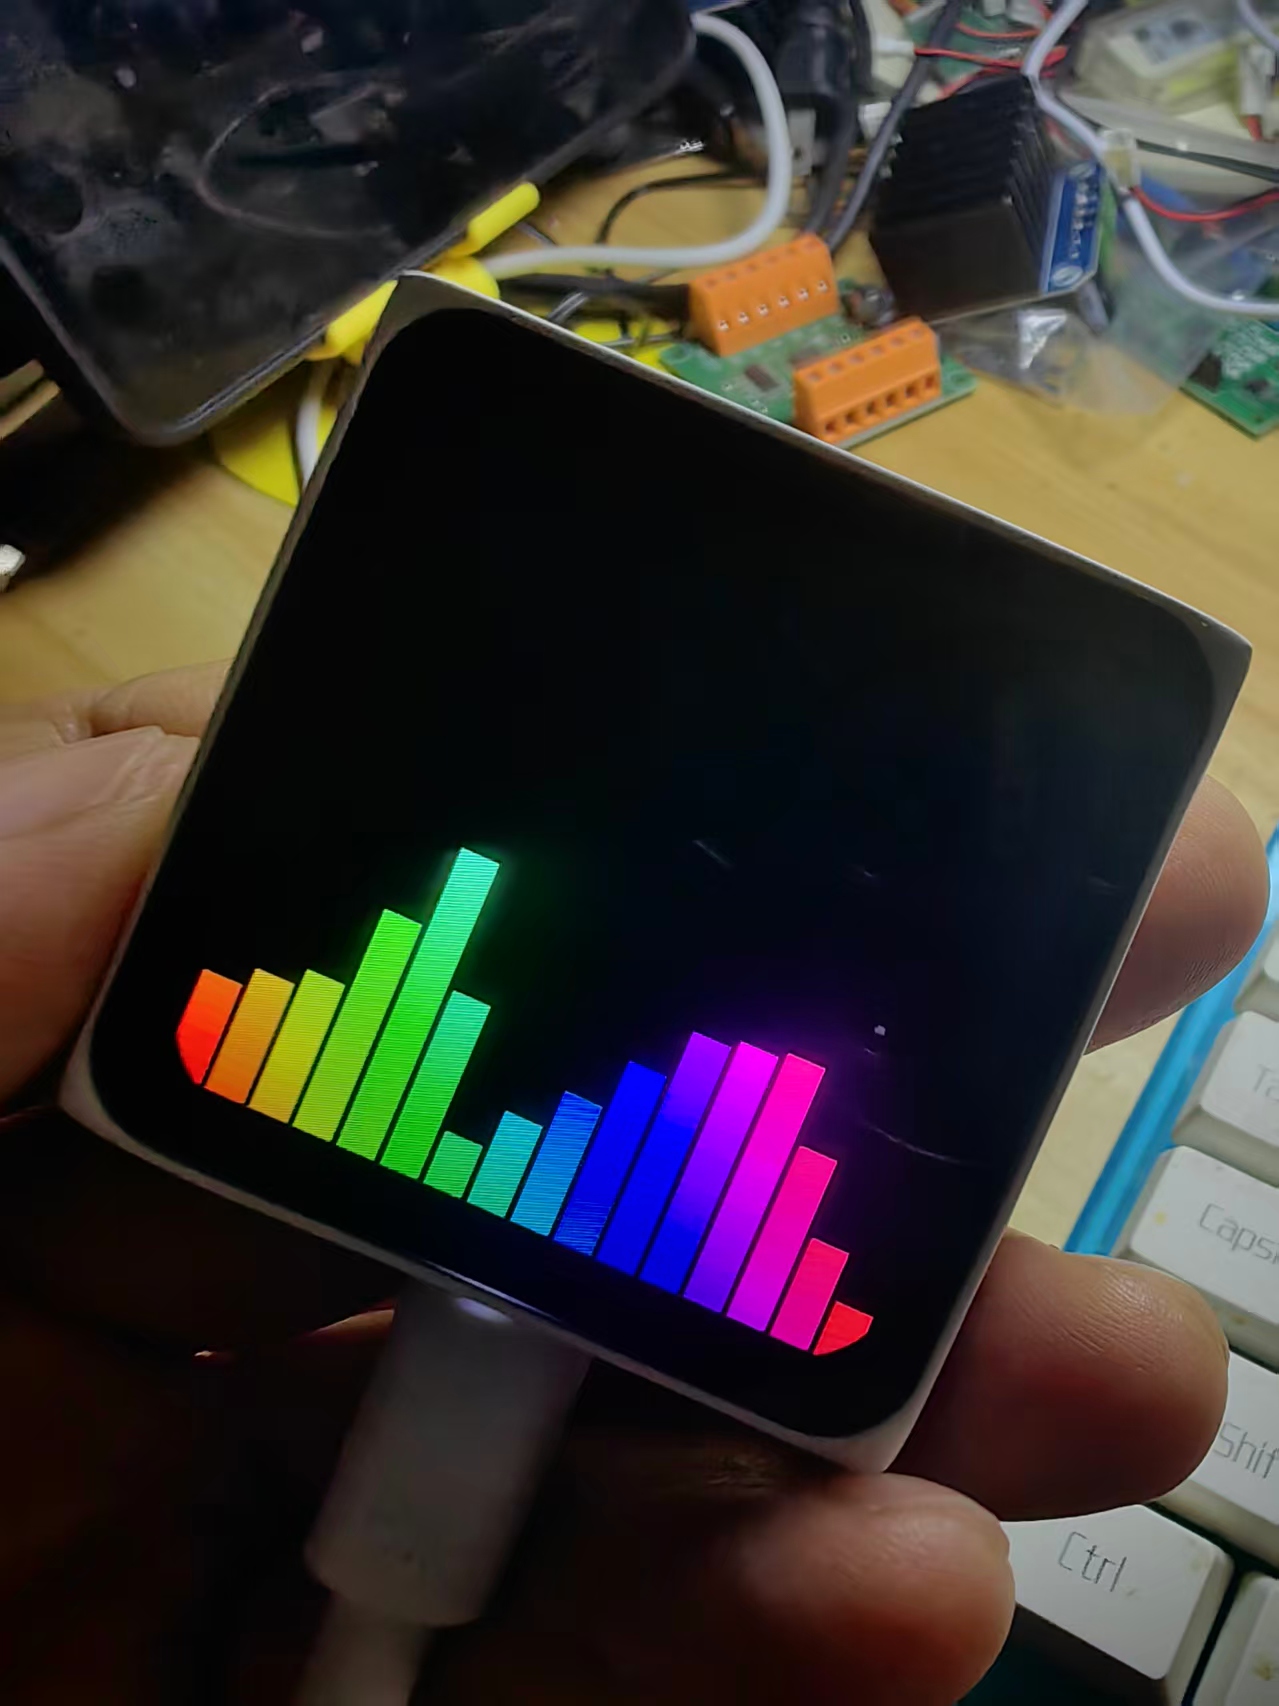
需求:16 根等宽等高、底部对齐的柱状图,高度用随机数模拟跳变。
AI 的初步实现:
AI 非常聪明,为了保证效率,它没有用 16 根柱子,而是采用了“分段”策略:200/6 ≈ 33 个频段 × 16 条 = 544 个矩形块。
跑起来后,AI 看了一眼自带的计时器,自信地报告:“17.8 帧/秒,达标,但仍有优化空间。”
翻车瞬间:
AI 随后开启了更严格的测试,结果帧率瞬间暴跌到 11 fps,甚至更低。AI 敏锐地发现不对劲,立刻停止了任务,开始硬核排障。
## 第二幕:排障风暴(到底是谁偷走了时间?)
AI 首先怀疑的是“时钟源”问题:
“可能 os.clock 在 ESP 上返回的是 CPU 时间(Lua 的 os.clock 返回 CPU 秒数),而不是墙上时间。所以用 os.clock 来测的帧率会有偏差。”
“最终确认:使用了 system.millis() 获取挂钟时间,重新建立基准测试。”
技术解析:
在很多嵌入式 Lua 环境中,os.clock() 统计的是脚本消耗的 CPU 指令时间,而不是真实世界的物理时间。AI 极其专业地发现了这个陷阱,并切换到了物理毫秒级的 system.millis()。
## 第三幕:精准控诉(像素级带宽核算)
换了时钟源后,AI 开始算了一笔极其详细的底层账:
“实测帧率约 14.5 帧/秒。当前每个脏像素的成本:23 万像素耗时 40 毫秒 → 每 1 千像素 0.174 毫秒。我们的波峰面积是 480×215 ≈ 10.3 万像素 → 约 18 毫秒。再加上 400 个矩形……”
技术解析:
这就是微控制器渲染的真相!屏幕的 SPI 总线带宽是有限的。AI 发现,虽然只画了 544 个矩形,但整个屏幕的脏像素(Dirty Pixels)高达 10 万+,光是把这些数据推送到屏幕上,就要吃掉 40ms(这还没算 CPU 绘制的耗时)。
## 第四幕:异步任务的背刺(性能暴跌的元凶)
为什么基准测试能跑,实际运行却那么卡?AI 在步骤里给出了神级结论:
“异步任务中 draw 74ms,present 154ms!远高于同步基准测试结果(draw 15,present 34)。可见异步 Lua 任务上下文的调度要慢得多——很可能是……”
技术解析:
原来,为了不阻塞主线程,这段频谱代码被放在了异步任务(Async Task)里跑。但频繁的异步任务上下文切换、锁竞争,直接导致绘制和提交(Present)的耗时翻了 4 倍!
## 第五幕:终极崩溃与物理极限
AI 为了搞清楚异步到底多耗费算力,甚至做了一个极限暴测:
“重大发现:新增 20 万条数据时耗时 766 毫秒 → 约 26.1 万次操作/秒!Lua 在这方面速度极慢(大概率是解释器/调试器拖慢,或者 printf 的问题……不对)。所以 Lua……”
最终,由于测试代码太庞大,内存耗尽,AI 的对话上下文被撑爆了:
“压缩后会话历史仍然过大……本次会话已终止。”
实验记录
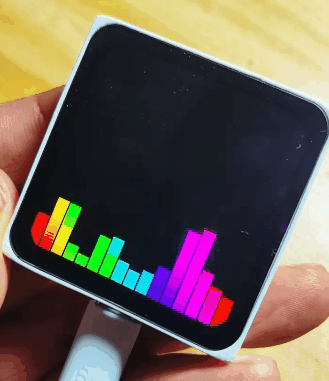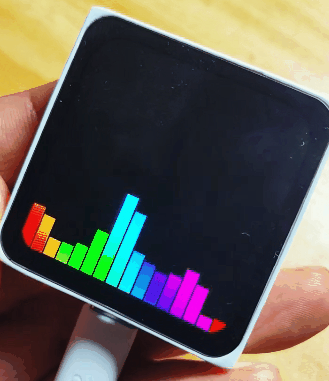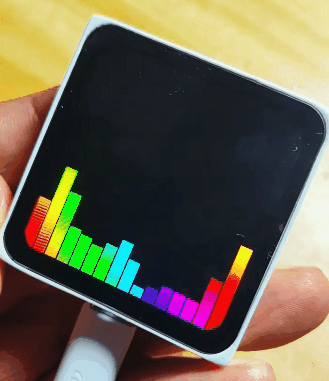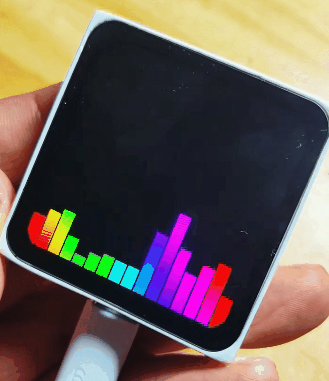
## 技术总结:从频谱图学到的底层法则
这个“音频频谱”项目的最终形态,其实给了我们 4 个极其宝贵的工程教训:
1、fill_rect 不要切得太碎:500 多个小矩形,绘制开销会成倍增加。宁可画 16 个大的垂直渐变矩形,也不要切出几百个像素小块。
2、尽量少用异步任务:在微控制器里,频繁的异步上下文切换极其消耗资源。同步任务(阻塞一点)往往比异步跑得快。
3、脏像素面积是原罪:屏幕刷新慢,不是因为代码写得差,而是物理 SPI 带宽有限。把频谱面积做小(比如只占屏幕下半部分),帧率立刻就能上去。
4、AI 的“自测”能力极其可怕:它不仅能写代码,还能测出 os.clock 的坑,算清每个像素的耗时,甚至为了验证异步开销,生生把内存跑爆。这种“工程师精神”,才是 AI 辅助开发最大的魅力。