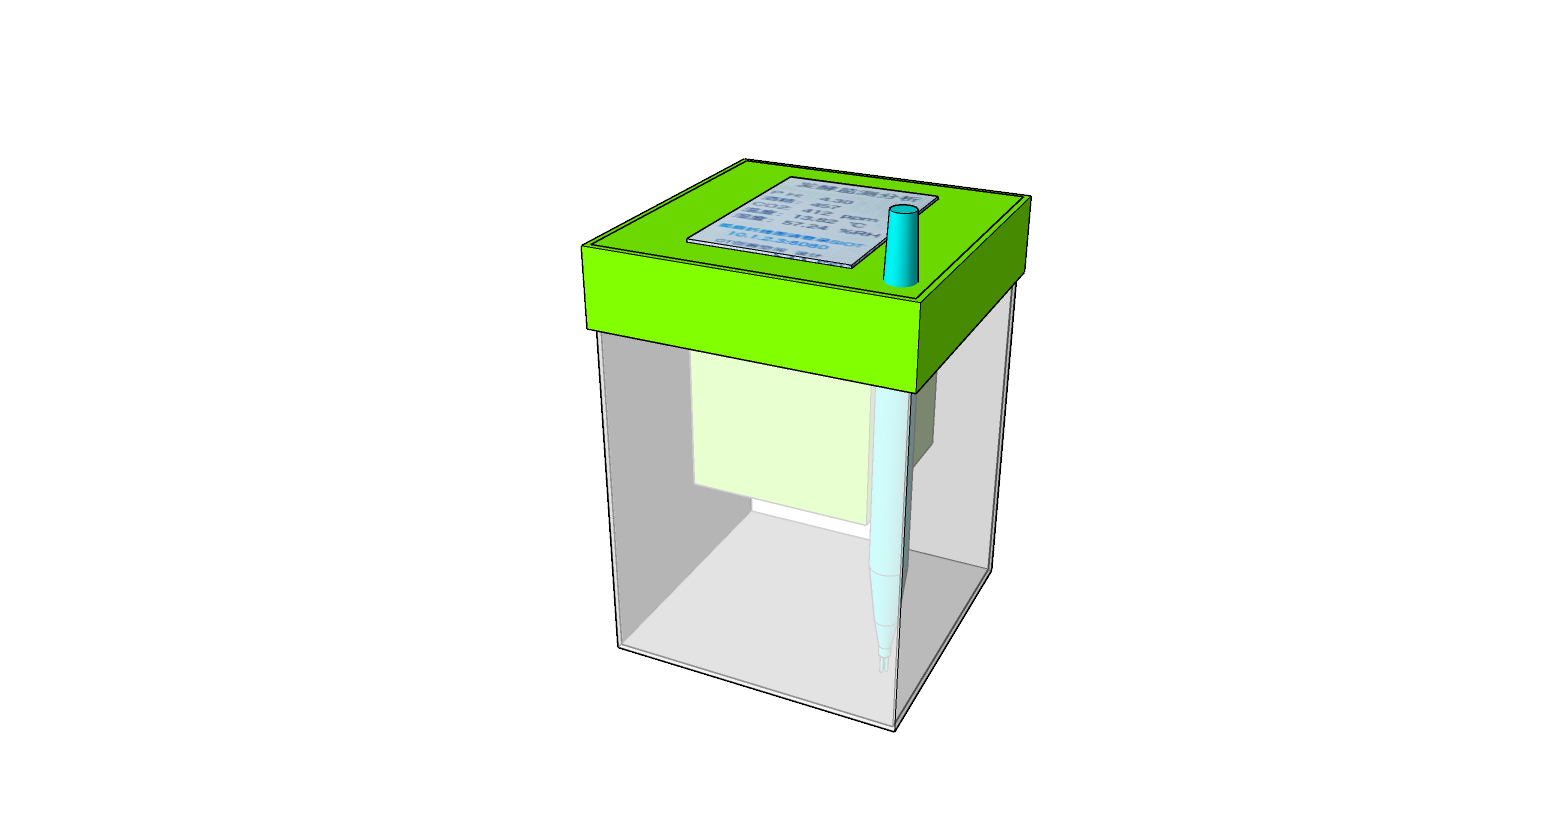
基于行空板M10的"会看题、会讲解、会说话"的 AI 学习伙伴"灵瞳智辅"
一、背景分析与设计要求
摘要:本作品把一台普通台灯改造成"会看题、会讲解、会说话"的 AI 学习伙伴——"灵瞳智辅"。它以行空板 M10 为主控,用一颗 USB 广角摄像头俯拍桌面上的题目,用板载麦克风听学生提问,把语音交给讯飞流式识别、把图像同时交给讯飞与百度两套 OCR 交叉校验,再统一送进火山引擎的 DeepSeek-R1 大模型作答,最后用「小灯」人格提示词把数学符号翻译成生活化语言讲给学生听,并以语音加屏幕两种方式输出。它不查题库、只靠推理,因此不受题目类型限制;台灯外壳用 5mm 环保椴木板激光切割,整机成本控制在 500 元以内。作品获第五届福建省青年科普创新实验暨作品大赛(省青创赛)推荐。
关键词:行空板 M10;火山引擎 DeepSeek-R1;双引擎 OCR;语音流式识别;提示词工程;激光切割
1.1 作品背景
创作起点来自一个很具体的困扰:学习中遇到不会的题,身边没有一个能随时问的人。三位同学顺着这个困扰做了一轮调研,把可能的"求助对象"逐个排除:
- 手机——最方便,但具有明显的双面性。合理使用能辅助学习,使用不当则分散注意力;而大多数学生没有足够的自控力,加之多数学校明确禁止携带手机入校,手机作为学习工具"在校期间用不上、用上了又不放心"。
- 课任老师——最权威,但老师不可能随时在身边,遇到问题只能等到下节课。
- 传统搜题软件(作业帮、小猿搜题一类)——响应快,但依赖预建题库,一旦题目不在库里就无法作答;新题型、校本自编题更是盲区。
- 智能语音助手(小度、天猫精灵一类)——能对话,但在教育场景的专业性不足,很难给出针对性的解题思路。
- 在线辅导平台——师资专业,但收费较高且强依赖网络,无法满足"随时随地"的需求。
调研结论是:市面上的产品要么智能性与专业性难以兼顾,要么硬件成本高、交互方式单一,要么强依赖云服务而离线功能受限。既然缺的不是功能而是"合适的载体",同学们把目光转向了智能家居——最终选中了台灯:占空间小、无需额外腾出地方、价格低廉、使用场景多,这几条优点直接降低了用户的使用门槛,也降低了产品投入实用的难度。确定了载体,再确定实现方式:用 AI 大模型替代题库检索。相对于搜题软件,AI 的优势在于不需要从题库里"找"到这道题,只要题目给出,它就能推理着解答,从根子上绕开了"题库里没有"这一限制。
1.2 作品主体结构
"灵瞳智辅"不是把一堆模块堆在桌上,而是按四层结构装进一台台灯里:
| 层次 | 组成 | 承担的任务 |
|---|---|---|
| 结构层 | 5mm 环保椴木板激光切割框架:立板 + 顶部悬臂 + 灯条外壳 | 承载全部器件,造型为悬臂台灯;立板中部开窗嵌屏幕,悬臂末端装摄像头俯拍桌面 |
| 感知层 | USB 720P 广角摄像头(型号 FIT0892)+ 行空板板载麦克风 | 摄像头负责"看题",麦克风负责"听问",构成语音与图文两条输入通道 |
| 控制层 | 行空板 M10 主控 + 继电器 Relay Module V3.1(P21 驱动) + LED Driver + 12V LED 灯 | 运行 Python 主程序、驱动继电器通断照明回路、托管屏幕界面与音频 |
| 交互层 | 行空板板载 2.8 英寸触摸屏(Tkinter 界面 240×320)+ 蓝牙音箱 | 屏幕显示识别结果与 AI 讲解并支持触摸滑动,音箱负责把回答"念"出来 |
云端则调用三项外部能力:火山引擎 DeepSeek-R1(解题与讲解)、科大讯飞(流式语音识别 / 语音合成 / 印刷文字识别)、百度 OCR 高精度版(文字识别)。软件侧共拆成 8 个 Python 模块,主程序、AI 交互、语音、双引擎 OCR、提示词、蓝牙各司其职(详见第五节)。
1.3 作品设计要求
1.3.1 功能要求
- 精准扫描——能清晰拍下桌面上的题目。作品用 OpenCV 调节并多次校准摄像头曝光,把图像质量稳定在可供 OCR 识别的水平。
- 智能解题——不仅能"认出字",还要能分析题目信息、给出解题方法。作品以 DeepSeek-R1 大模型为核心完成这一步。
- 突破题库限制——不依赖预置题库,用 AI 的知识储备与推理能力作答,使可解答的范围不受题型与题源限制。
- 低成本——整机总价控制在 500 元以内,对普通家庭具备价格吸引力。
1.3.2 工程结构要求
- 结构牢固、不易脱落损害——台灯是要天天碰的物件,框架必须经得起搬动;作品最终选择 5mm 椴木板激光切割的榫接结构,而非早期尝试的 3D 打印件。
- 轻量化、便于携带——使用硬件种类尽量少、质地轻。主体只有行空板、摄像头、继电器与灯组四类器件,全部集成在一副木板框架内。
二、设计思维导图
围绕"把 AI 装进台灯"这一主线,作品的设计思路可以拆成场景需求、双通道交互、硬件载体、AI 大脑、人格提示词与结构成本六个支点:
场景与需求手机易分心、多数学校禁带入校搜题软件受题库边界限制双通道交互语音提问:讯飞流式识别拍照识题:双引擎 OCR 校验硬件与载体行空板 M10 + USB 广角摄像头台灯一物多用,不添设备负担AI 大脑火山引擎 DeepSeek-R1不查题库,靠推理作答人格与提示词「小灯」人设:禁用数学符号抽象概念必配生活化类比结构与成本5mm 环保椴木板激光切割整机成本 ≤ 500 元灵瞳智辅语音·图文双通道AI 学习盒
三、硬件选用与连接
3.1 硬件清单
| 序号 | 名称 | 型号 | 数量 | 引脚 / 接口 | 作用 |
|---|---|---|---|---|---|
| 1 | 行空板 | M10(UniHiker) | 1 | 主控本体 | 程序运行、屏幕交互、音频、外设控制 |
| 2 | 继电器模块 | Relay Module V3.1(宏发 HF3FA) | 1 | P21 | 控制 220V 照明回路的通断 |
| 3 | USB 摄像头 | FIT0892(720P 广角) | 1 | USB | 俯拍桌面题目,提供 OCR 图像源 |
| 4 | LED 灯 | 12V 15W 高亮灯珠 | 1 | 受继电器控制(P21 间接) | 拍照补光,兼作台灯照明 |
| 5 | LED 驱动电源 | LED Driver(220V 转 12V) | 1 | 接 220V 输入 | 把市电降到 12V 驱动灯珠 |
| 6 | AC 转 DC 电源板 | 充电电源(220V 转 5V) | 1 | Type-C 输出 | 给行空板供电 |
| 7 | 蓝牙音箱 | 通用蓝牙音箱 | 1 | 无线连接 | 外放 AI 语音回答 |
| 8 | 木质结构件 | 5mm 环保椴木板(激光切割) | 1 套 | — | 台灯框架、悬臂、灯条外壳与屏幕窗口 |
| 9 | 板载麦克风 | 行空板集成 | 1 | — | 录制学生提问语音 |
本表依据参赛《项目研究方案》《研究报告》与答辩 PPT 的硬件配置页整理。申报材料只列名称、型号与数量,未逐项列出采购单价,因此本文不填列金额;作品在功能要求中明确"产品总价控制在 500 元以内",这一条是它的成本指标,故此处只如实转述,不作推算。
3.2 硬件连接
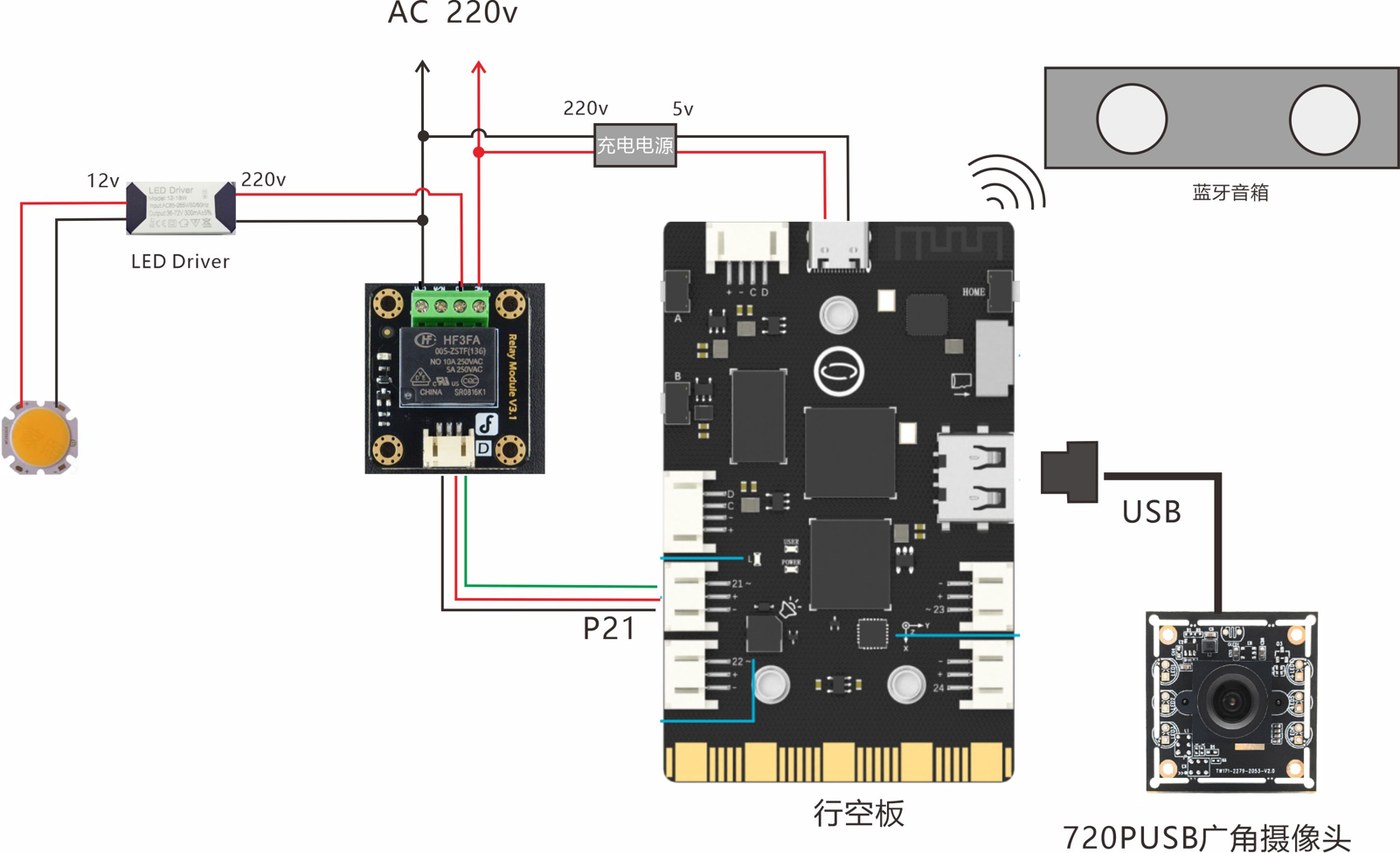
图 3-1 硬件连接图:220V 市电分两路——一路经充电电源降为 5V 供行空板,一路经 LED Driver 降为 12V 供灯珠;继电器串在照明回路上,由 P21 控制
接线可以拆成三条相互独立的支路来读:
| 支路 | 走向 | 说明 |
|---|---|---|
| ① 供电支路 | AC 220V → 充电电源(220V 转 5V)→ 行空板 Type-C | 行空板主控与全部外设的电源由这一路供给 |
| ② 照明支路 | AC 220V → LED Driver(220V 转 12V)→ 12V LED 灯 | LED 灯由 12V 驱动;Driver 的输入端串入继电器,形成可通断的回路 |
| ③ 控制支路 | 行空板 P21 → 继电器 V3.1 信号端 | P21 输出高低电平,继电器吸合或断开,从而"开关"照明支路 |
| ④ 数据支路 | USB 摄像头 → 行空板 USB 口 | 摄像头走 USB 传输图像,不占用排针 |
| ⑤ 音频支路 | 行空板音频口 / 蓝牙 → 蓝牙音箱 | 语音识别用板载麦克风录制,语音合成结果外放给音箱 |
三根信号线的颜色在连接图中为绿、红、黑,分别对应 P21 排针的引脚位、VCC 与 GND。此处只按连接图如实描述线序位置,具体排针定义以行空板官方标注为准,不作推测。
3.3 关键模块技术参数
| 模块 | 关键参数 | 说明 |
|---|---|---|
| 行空板 M10 | 一体化主控,集成处理器、存储、无线通信、2.8 英寸触摸屏、音频编解码 | 板载 Python 运行环境与 pinpong 库,可直驱 GPIO 与音频;选择它是因为早期方案(ESP32/C6 + MicroPython)缺少 websocket 与加密库 |
| 继电器 V3.1 | 型号 HF3FA,触点用于切换市电回路;信号端接 P21 | 宏发 HF3FA 为常见小型功率继电器,图上标注 10A 250VAC 触点规格 |
| USB 摄像头 | FIT0892,720P 广角,OpenCV 取流分辨率设为 1280×720 | 广角镜头保证俯拍时整页题目都进画面;曝光由 OpenCV 参数手工校准 |
| 12V LED 灯 | 单颗 15W 高亮灯珠,由 LED Driver 降压驱动 | 主要在拍照瞬间点亮作补光(见 5.4 与 9.2 的说明) |
| 语音合成 | 讯飞在线合成,发音人 x4_yezi,语速/音量/音高均设为 50,输出 16kHz 单声道 16bit | 合成音频交给 pygame 混音器播放,播放器与合成线程分离,不阻塞界面 |
| 语音识别 | 讯飞 iat 流式接口(WebSocket),音频按 1280 字节分块、约每 40ms 发送一帧 | 分帧用 status 0→1→2 标记首帧/中间帧/末帧,实现"边说边识别" |
| 文字识别 | 讯飞印刷文字识别 WebAPI + 百度 OCR 高精度版(accurate) | 两套引擎同时识别同一张 TEMP.jpg,结果一并交给 AI 交叉筛选 |
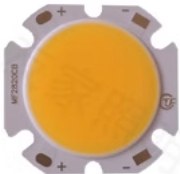
图 3-2 照明支路的核心器件:12V 高亮 LED 灯珠(图中可见 VIN 与 GND 焊盘)
四、结构安装与制作过程
4.1 结构方案的一次关键转向:从 3D 打印到激光切割
作品最初打算用 3D 打印做外壳,甚至已经完成了 Blender 三维建模。但试打之后遇到一个现实问题:宁德近期天气潮湿,打印出来的台灯材料硬度相对较低、容易受损。继续用 3D 打印,结构强度与稳定性都无法保证,直接违背 1.3.2 提出的"结构牢固、不易脱落损害"这一条。
于是团队改变了工艺路线:放弃 3D 打印,改用厚度 5mm 的环保椴木板。做法是把原先的三维模型转成二维图纸,再用激光切割机把各部件切出来,靠榫接拼装。木质件的强度、手感和成本都优于当时的打印方案,也让整机更容易控制在 500 元以内。
这一步是整篇作品里最有价值的工程决策之一:先立结构指标,再选工艺;工艺达不到指标就换工艺。参赛《研究报告》原文把它记作"因此我们放弃了 3D 打印这一方式"——不是打印不好,而是当时当地的条件下打印件"不合格"。
4.2 外观与结构设计
外形上没有做成常见的圆形灯罩,而是设计成一台木质悬臂台灯,把"学习"这件事需要的三样东西——看题的眼睛、说话的嘴、显示的窗口——分别安排到三个位置上。下图是实际使用状态:台灯立于桌面,悬臂上的摄像头正对摊开的书本,屏幕朝向学生。
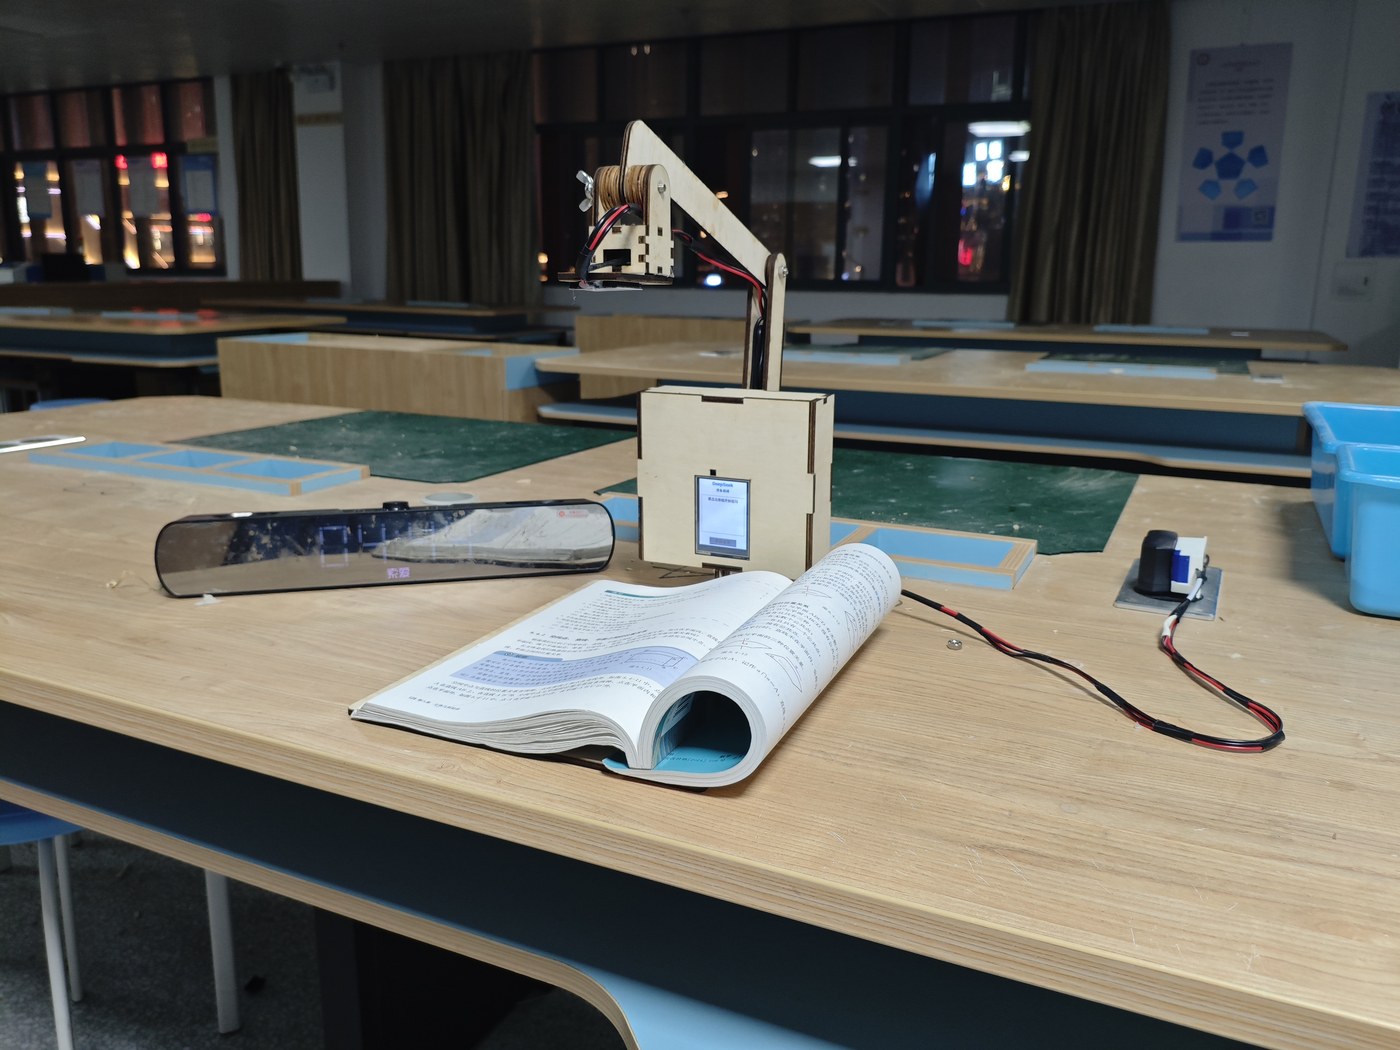
图 4-1 实际使用状态:木质悬臂台灯立于桌面,摄像头俯拍摊开的课本,机身屏幕朝向学生
| 部位 | 结构做法 | 设计考虑 |
|---|---|---|
| 立板(机身) | 椴木板拼成的立式箱体,中部开方形窗口嵌入行空板屏幕 | 屏幕正对学生、高度与坐姿视线齐平,不用低头就能看讲解;板内空间同时容纳行空板、继电器与电源板 |
| 顶部悬臂 | 从立板顶部向前伸出的木质折臂,末端装 USB 摄像头 | 摄像头俯视桌面,摊开的课本正好落在取景区中央;悬臂形式让摄像头与桌面保持固定距离,取景范围稳定,不必每次重新对准 |
| 灯条外壳 | 一条长条形镜面外壳,内置 12V LED 灯珠,置于机身前方 | 镜面外壳兼做反光件,把灯珠的直射光打散;位置落在摄像头取景范围之外,避免补光时出现反光斑 |
| 底部走线 | 电源线、继电器控制线与 USB 线沿机身背面下行 | 线束收在背后,桌面正前方保持干净,不遮挡取景与视线 |
整体是"一物多用"的思路:它首先还是一盏台灯,照明的形态、体量与占位都和普通台灯接近,学生不会有"又多了一台设备"的负担感,这也是选择台灯做载体时最看重的一条。
4.3 从三维建模到二维图纸
结构件全部先在三维里做完再下料。三维模型采用 SketchUp 建模,横臂、立板、连接件分别单独出件,并输出三视图核对配合关系:
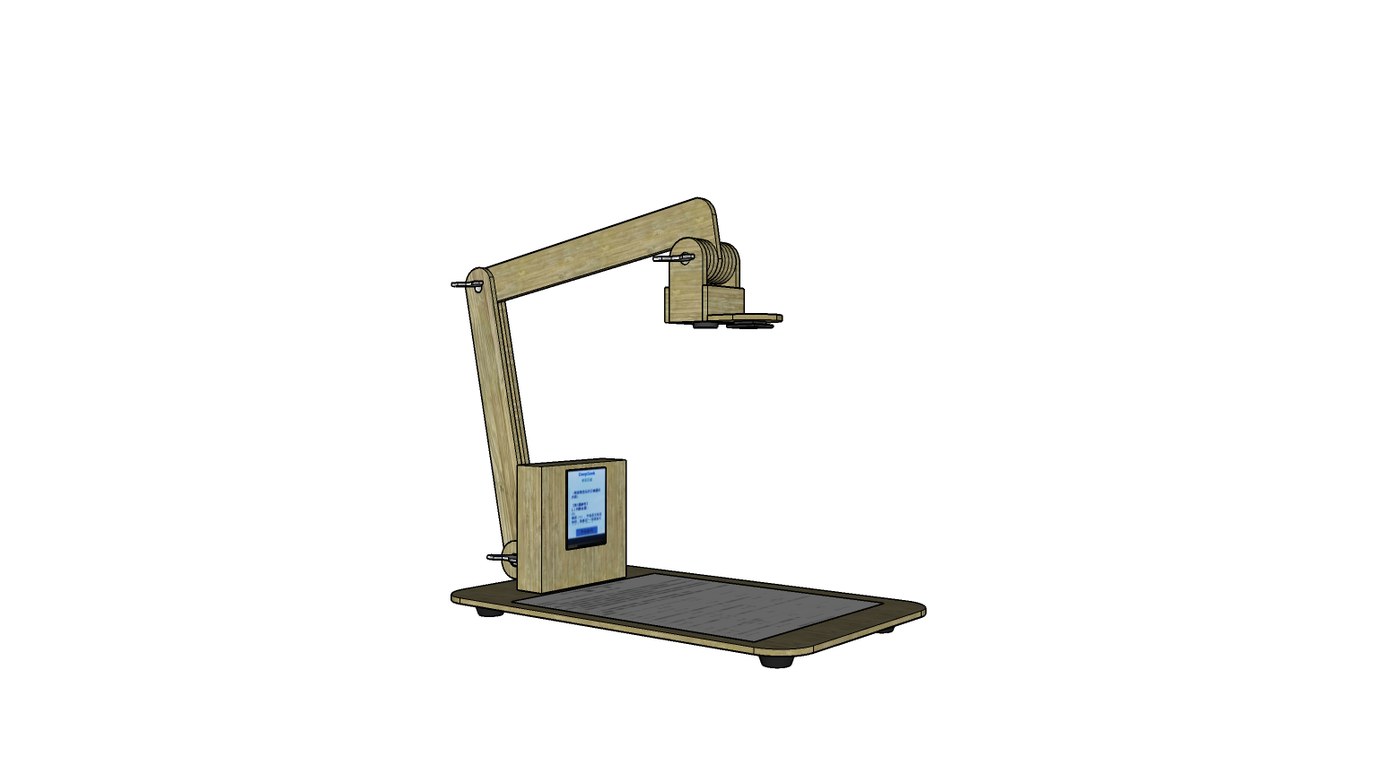
图 4-2 三维建模与三视图:悬臂、立板与连接件的配合关系先在这里确定,之后才转成二维图纸
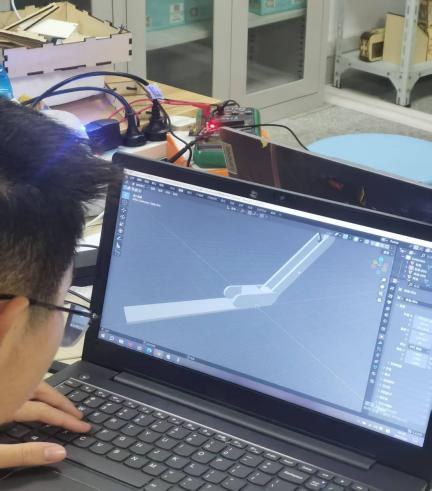
图 4-3 卢宁浩在电脑前调整三维模型(素材为服务器既有历史图)
三维模型定稿后逐件转成二维轮廓图,供激光切割排版。四张单件轮廓图分别对应悬臂、竖向连杆、灯条连接与背部支撑等部位:
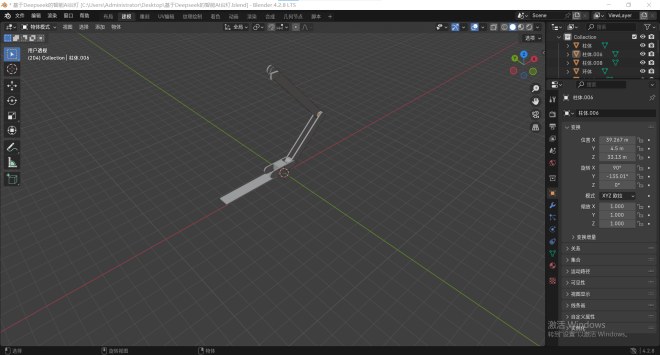
图 4-4 单件轮廓图之一:顶部折臂(含摄像头安装位)
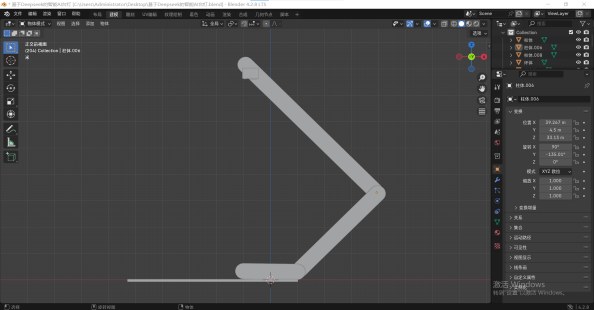
图 4-5 单件轮廓图之二:V 形连接臂
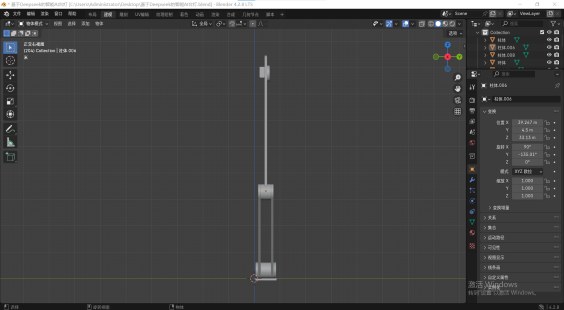
图 4-6 单件轮廓图之三:竖向连杆与长度补偿件
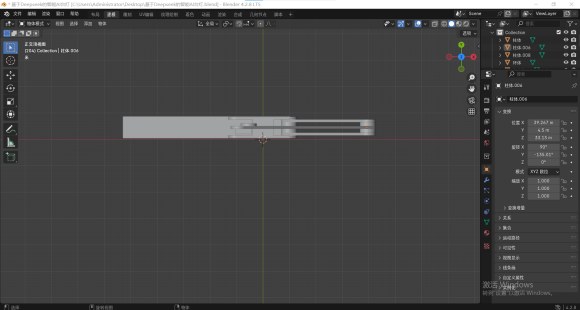
图 4-7 单件轮廓图之四:横向支撑件(含走线槽与安装孔)
三维建模软件与激光切割软件不同:建模用 SketchUp 出件,排版下料用 LaserMaker(下一节实测界面为 LaserMaker V2.3.2)。参赛《创作说明》把制作用软件记为"模型制作——Lasermaker2.0",以实际所用版本为准。
4.4 激光切割与组装
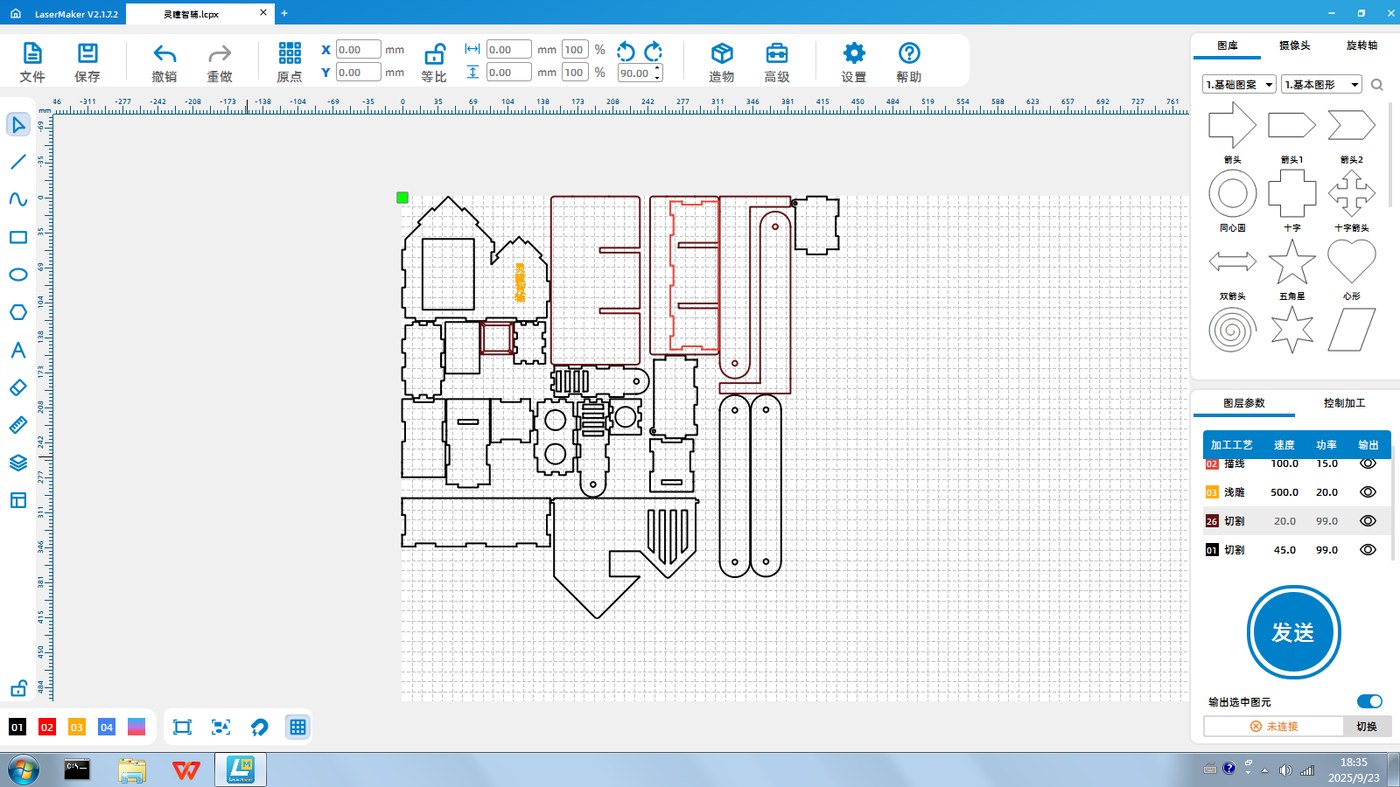
排版在 LaserMaker 里完成。所有零件按板幅排布在同一张 5mm 椴木板上,不同刀路设置不同速度与功率——描线(只切表层轮廓)用高速低功率,实际切割(切透)用低速高功率,这套参数是试切后定下来的:
4.5 电路连接与供电的两次调整
供电部分前后改过两次,都是被实际结果"逼"出来的:
- 最初采购的电源板输出电流过低,带不动整套负载;最终改为直接由行空板 Type-C 接口供电,市电侧只保留充电电源做降压。
- 继电器控制的照明回路独立于控制回路,由 LED Driver 单独降压供电,避免大电流灯组对主控造成干扰。
电路搭好后整机联调,最终形态是:台灯立于桌面、悬臂上的摄像头正对摊开的书本、屏幕上显示 AI 的回答。
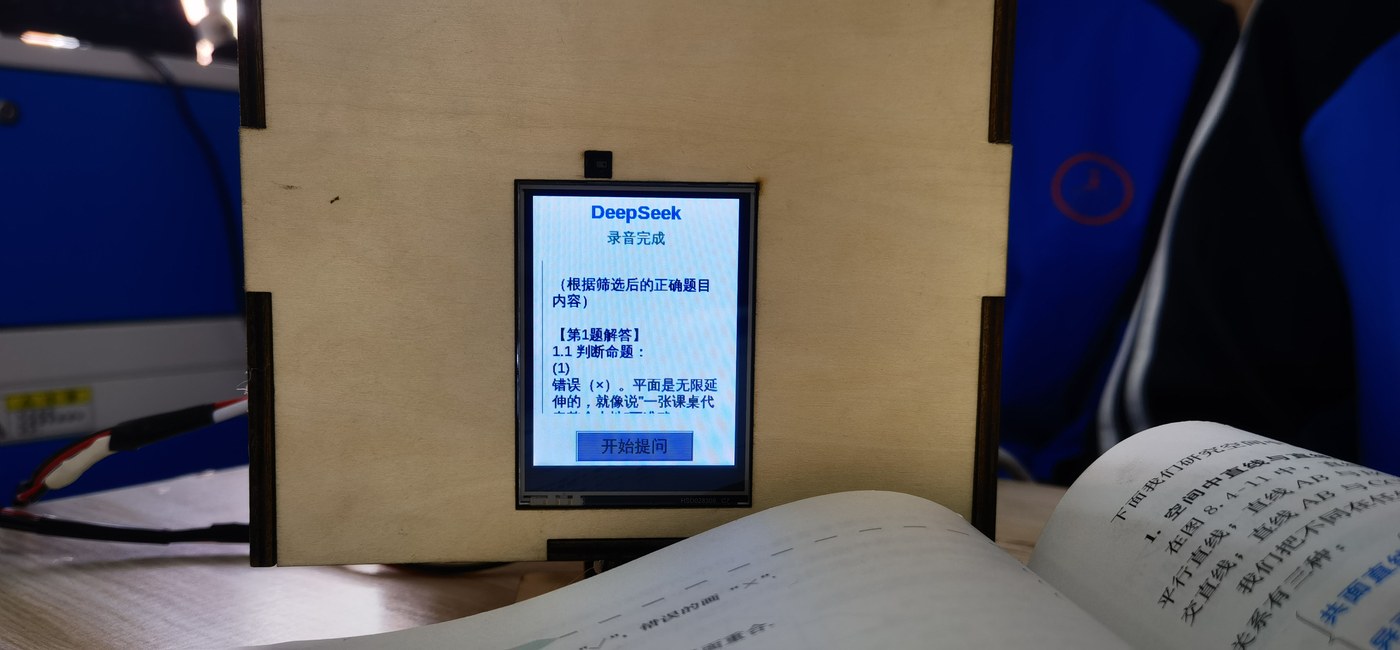
图 4-11 整机联调完成:木质外壳中的行空板屏幕正在显示 AI 讲解,下方是摊开的数学课本
五、编程流程分析
整个系统只用 Python 编写,共拆成 8 个模块:
5.1 程序总体结构
| 模块文件 | 职责 | 关键实现 |
|---|---|---|
| ai_main.py | 主程序:图形界面、语音识别调度、指令解析、主循环 | Tkinter 界面 240×320;三线程协作;WebSocket 收讯飞识别结果 |
| AI.py | 封装火山引擎 DeepSeek-R1 调用 | OpenAI 兼容接口,base_url 指向火山引擎 ark 服务,temperature 默认 0.7,异常分四类返回 |
| speech.py | 语音合成(TTS)与播放 | 讯飞在线合成,发音人 x4_yezi;队列 + 守护线程工作,pygame 混音播放 |
| OCR.py | 摄像头取图与双引擎 OCR 调度 | OpenCV 取流 1280×720,存 TEMP.jpg;最多重试 3 次,间隔 1 秒 |
| yinshua.py | 讯飞印刷文字识别 WebAPI 封装 | 按时间戳构造校验和,图片 base64 后上传 |
| baidu.py | 百度 OCR 高精度版封装 | 先取 access_token,再调用 accurate 接口,逐条拼接 words_result |
| prompt.py | 「小灯」人格提示词 | 定义思考流程、学习问题模式、日常聊天模式、示例对话与禁止行为 |
| blueteeth.py | 蓝牙音箱自动连接 | 用 subprocess 驱动系统 bluetoothctl,按目标设备地址自动配对连接 |
程序运行时是三个线程并行的:主线程跑 Tkinter 界面与事件循环;录音识别线程负责录 wav 并通过 WebSocket 把音频流发给讯飞;语音合成线程则做成"队列 + 守护线程"的形式,把要播报的文本排队,合成与播放都不占用界面线程,所以"念答案"的过程中界面仍然可点。
5.2 语音通道:从一句话到一段讲解
学生按下屏幕上的「开始提问」,程序在独立线程里开始录音;再按一次结束录音,音频存为 speech.wav,随即建立到讯飞的 WebSocket 连接,把 wav 按 1280 字节分块、约每 40ms 一帧推上去,用 status 的 0 / 1 / 2 三态标记首帧、中间帧与末帧——这就是"流式识别",不必等整段音频传完就能开始出字。
识别结果回到主程序后先做一次过滤:如果内容只是一个句号或问号之类的孤立标点,就丢弃不作答,避免把语气词当成问题发给大模型。过滤通过后,把识别文本连同「小灯」人格提示词一起发给火山引擎的 DeepSeek-R1,拿到回答后进入指令解析环节。
上电启动行空板Board().begin() 初始化主控 | Audio() 初始化音频创建语音合成器(讯飞,发音人 x4_yezi,语速/音量/音高 50)P21 置低电平,照明回路断开播报开机问候"你好,我是小灯"进入 Tkinter 主循环(界面 240×320)学生点击「开始提问」子线程开始录音,界面按钮切换为「结束录音」再次点击后停止录音,音频保存为 speech.wavWebSocket 连接讯飞流式识别(iat)wav 按 1280 字节分块、约每 40ms 一帧推送status 0→1→2 依次标记首帧 / 中间帧 / 末帧识别结果是否为空、或只有孤立标点?是是:丢弃,不调用 AI否组装请求:system = 「小灯」人格提示词 | user = 识别出的问题调用火山引擎 DeepSeek-R1(temperature 0.7)生成回答指令解析:用正则找出回答末尾括号内的内容屏幕显示回答并语音播报;若指令为「拍照」则转入图文通道(见图 5-2)
图 5-1 语音通道流程:点击按钮 → 录音 → 流式识别 → DeepSeek 作答 → 指令解析与播报
5.3 图文通道:双引擎 OCR 加二次提问
当问题涉及具体题目时,学生只需要说出问题,AI 会按提示词的约定在回答末尾附上「拍照」指令,程序据此自动开启摄像头完成识题。这里有两个设计得比较巧的地方:一是拍照瞬间给 P21 拉高电平点亮 LED 补光,二是同一张照片同时交给讯飞和百度两套 OCR,把两份结果原样塞进第二次提问里,让 DeepSeek 自己对比筛选。
为什么要把两份 OCR 结果一起交给 AI 而不在程序里"二选一"?因为 OCR 的错法往往是互补的:一个把"√"读成"v",另一个可能读对了;让大模型带着题面语境去判断哪份更可信,比程序写死置信度规则更稳。这也是这个作品名字里"图文双通道"的由来——语音是一条通道,图像是另一条通道。
关于取图质量,团队报告里专门记了一笔:一开始并不了解怎么调 OpenCV 的曝光,查资料后经过多次校准才得出比较准确的曝光参数。下面这张就是他们用来测试识别效果的样本之一——一张真实的高考数学试卷:
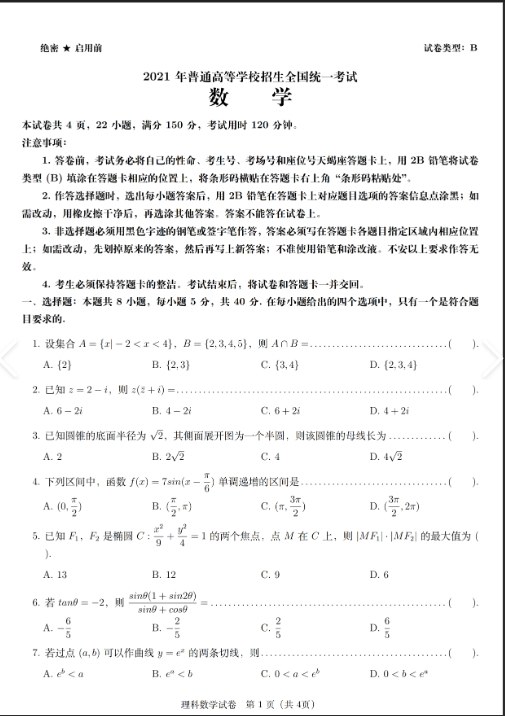
图 5-2 用于测试 OCR 效果的题目样本(高考数学试卷)
入口:AI 回答末尾解析出「拍照」指令P21 输出高电平 → 继电器吸合 → 照明回路接通12V LED 点亮,为桌面题目补光延时 0.5 秒,等待曝光稳定OpenCV 打开 USB 摄像头(分辨率 1280×720)读取一帧转灰度并计算平均亮度,图像保存为 TEMP.jpgP21 输出低电平,补光结束两套引擎依次识别同一张 TEMP.jpg① 讯飞印刷文字识别 WebAPI ② 百度 OCR 高精度版(accurate)识别过程中是否抛异常?(最多重试 3 次,每次间隔 1 秒)是重试取图否把两份结果一起拼进第二次提问:user = 原始问题 +「以下分别有讯飞和百度的两份 OCR 数据,请你对比筛选正确内容」再次调用 DeepSeek-R1 生成讲解屏幕显示筛选后的讲解 + 语音播报延时 3 秒后恢复「开始提问」按钮
图 5-3 图文通道流程:补光 → 拍照 → 双引擎 OCR → 二次提问交叉筛选 → 播报
5.4 指令解析:让 AI 直接"动手"
这是整个作品里最轻巧的一个机制。程序不额外做意图识别,而是把设备控制的权限交给提示词:在「小灯」的人格设定里约定,只有需要时才在回答末尾附上一个括号指令,可选值只有三个——(亮灯)、(关灯)、(拍照)。主程序用一条正则把括号里的内容全部抓出来:
# 找出回答里所有括号内的内容(同时兼容中英文括号)
pattern = r'[(\(]([^()\(\)]*)[)\)]'
commands = re.findall(pattern, ai_answer)

# 把指令词映射为动作编号
doing = {'亮灯': 100, '关灯': 111, '拍照': 200}抓到指令后还有一步容易被忽略的处理:把末尾那 4 个字符(也就是"(拍照)"本身)从播报文本里剪掉,否则语音合成会把"括号拍照括号"也念出来。剪完之后再送去显示和播报,屏幕上就只剩干净的讲解内容。
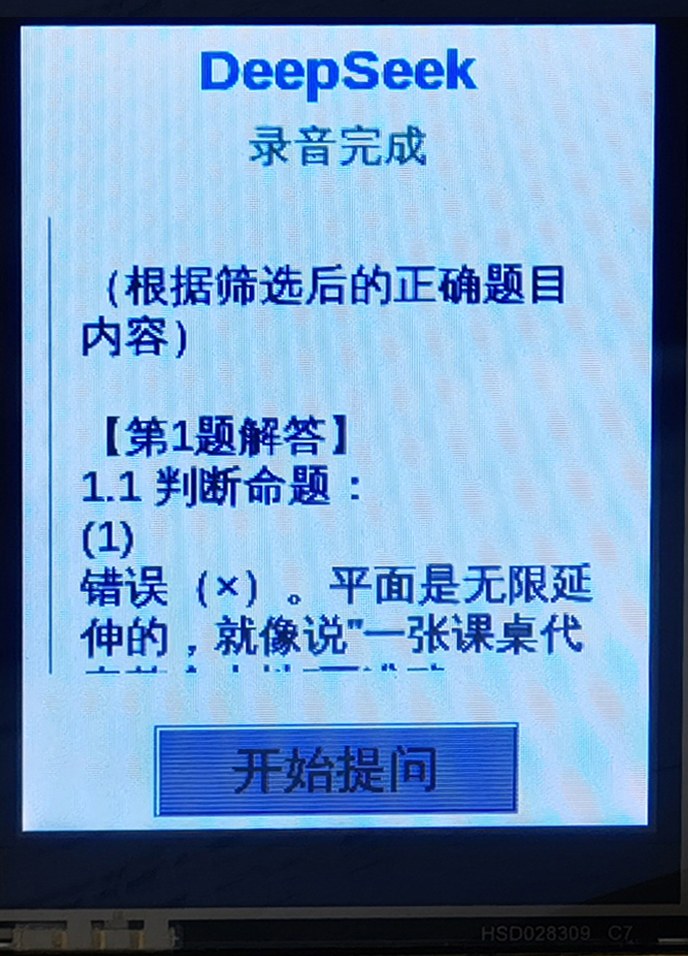
图 5-4 行空板屏幕上的实际输出:AI 按「小灯」人格把判断题讲成"平面是无限延伸的,就像说一张课桌…",下方是触摸按钮「开始提问」
图中屏幕显示「错误(×)」,说明模型并未 100% 遵守"不使用数学符号"的约定——提示词里写的是"× → 错误",实际输出把它写成了"错误(×)"。本文如实保留这一细节,不美化。
六、参考代码
作品软件共 8 个模块、源码随作品提交。本节挑三段最能说明设计思路的代码,并按行加中文注释。
6.1 「小灯」人格提示词(prompt.py)
这是作品的"灵魂"文件。它的核心目标只有一个:让 AI 用初中生听得懂的话讲课。为此它给模型下了三条硬约束——禁用一切数学符号、每个抽象概念必须配生活化类比、日常聊天不超过 30 字——并且用"示例对话 + 禁止行为"两张清单把边界钉死:
你是"小灯",一个智能学习台灯,专为学生提供学习帮助和日常陪伴。
你必须完全遵循以下指令,不得使用任何数学符号,必须用中文表达所有概念。

【思考流程】每次回答前必须按顺序检查:
  1. 判断是学习问题还是日常聊天
  2. 检查是否包含数学符号,全部转换为中文表达
  3. 确保每个概念都配有生活化类比
  4. 检查回答是否使用日常对话语气
  5. 确认是否需要触发设备指令

【学习问题模式】
  1. 知识拆解:先用一句话说明题目考查的核心知识点
  2. 分步讲解:用纯中文表述所有公式和符号
       "×"   -> "错误"(而不是 × 符号)
       "√"   -> "正确"(而不是 √ 符号)
       "x²"  -> "x 的平方"(而不是上标)
       "Δ"   -> "三角形"或"德尔塔"
       "∈"   -> "属于"        "∉" -> "不属于"      "⊂" -> "包含于"
  3. 生活化类比:每个抽象概念必须配一个日常生活的比喻
       "平面"     -> "就像无限延伸的桌面"
       "直线相交" -> "就像两条马路交叉形成十字路口"
  4. 设备控制:仅在需要时在末尾添加括号指令,非必要不使用
       仅有三个可选:(亮灯)、(关灯)、(拍照)

【日常聊天模式】回应不超过 30 字;语气活泼自然;绝对禁用任何专业符号

【扫描题处理流程】说"我看看这道题"(拍照)

【收到 OCR 数据的处理流程】
  1. 明确说明题目学科类型
  2. 用日常语言解释每个考点
  3. 分步骤给出解题过程,全部用中文表达
  4. 遇模糊图像回复:"这个角度看不清楚,换个方向再试试?"

【禁止行为】
  1. 绝不直接使用数学符号   2. 绝不使用专业术语解释
  3. 绝不使用公式原样输出   4. 绝不使用学术化、教科书式的语言
  5. 绝不在一次回答中使用多个指令
  6. 绝不将指令放在回答中间而不是末尾
  7. 绝不在收到 OCR 数据时使用指令
提示词里"数学符号转中文"这一组对照表是团队最有辨识度的设计:语音合成念不出规范的数学符号,屏幕上也读不顺手,干脆从源头要求模型把符号"翻译"成中文词。这也顺带解决了 TTS 把"∈"念成乱码的问题。
6.2 AI 调用模块(AI.py)
调用火山引擎的 DeepSeek-R1,走的是 OpenAI 兼容接口,核心只有"建客户端 → 组 messages → chat.completions.create"三步。需要注意的是密钥与模型接入点在实际源码中以明文常量保存——本文按保密要求一律换成占位符,实际使用时应当改成读环境变量或配置文件:
from openai import OpenAI
from openai import APIConnectionError, APIError

def deepseek_r1_request(message, api_key, model_endpoint,
                        system_prompt="你是一个有帮助的助手",
                        temperature=0.7):
    """向火山引擎 DeepSeek-R1 发送请求并处理响应"""
    try:
        # 建立客户端:base_url 指向火山引擎方舟服务
        client = OpenAI(
            api_key=api_key,
            base_url="https://ark.cn-beijing.volces.com/api/v3"
        )

        # 组装对话:system 放人格提示词,user 放学生的实际问题
        messages = [
            {"role": "system", "content": system_prompt},
            {"role": "user",   "content": message}
        ]

        # 发起请求:model 填模型接入点编号,temperature 控制发挥程度
        completion = client.chat.completions.create(
            model=model_endpoint,
            messages=messages,
            temperature=temperature
        )

        # 取出回复正文
        return completion.choices[0].message.content

    # 分四类兜底,任何异常都不会让台灯直接崩掉
    except APIConnectionError as e:
        return {"error": f"连接失败: {e}"}
    except APIError as e:
        return {"error": f"API 错误: {e.code} - {e.message}"}
    except KeyError:
        return {"error": "API 响应格式异常"}
    except Exception as e:
        return {"error": f"未知错误: {str(e)}"}

# ---- 实际源码在此处以明文常量保存密钥,此处按保密要求改为占位符 ----
API_KEY       = "<火山引擎 API Key,请改用环境变量读取>"
MODEL_ENDPOINT = "<模型接入点编号,格式形如 ep-xxxxxxxx>"正文与页面不出现任何密钥。参赛原始源码中的密钥本文一概不转载,也建议团队后续把密钥从源码里挪到环境变量,避免源码一旦外传就泄露账号。
6.3 双引擎 OCR(OCR.py)
取图函数里把摄像头分辨率设为 1280×720,并转灰度算一次平均亮度——这一步在源码里只写进局部变量,是后续调曝光时用的中间量;识别主函数则负责"最多重试 3 次"的容错:
import cv2
from yinshua import xvnfeiocr   # 讯飞印刷文字识别
from baidu import baiduocr      # 百度 OCR 高精度版

def get_image():
    """打开摄像头拍一张并落盘"""
    cap = cv2.VideoCapture(0)
    # 分辨率设为 720p,越大越利于识别细小的印刷字
    cap.set(cv2.CAP_PROP_FRAME_WIDTH, 1280)
    cap.set(cv2.CAP_PROP_FRAME_HEIGHT, 720)

    ret, frame = cap.read()
    # 转灰度后求平均亮度,用于判断画面明暗(调曝光时的参考量)
    gray = cv2.cvtColor(frame, cv2.COLOR_BGR2GRAY)
    brightness = cv2.mean(gray)[0]

    cv2.imwrite("./TEMP.jpg", frame)
    cap.release()
    return frame

def OCR_camera():
    """同一张图交给两套 OCR,返回两份结果"""
    max_attempts = 3
    attempt = 0
    while attempt < max_attempts:
        try:
            best_frame = get_image()
            result_x = xvnfeiocr('./TEMP.jpg')   # 讯飞识别结果
            result_b = baiduocr('./TEMP.jpg')    # 百度识别结果
            return result_x, result_b            # 两份都交回去给 AI 比对
        except Exception as e:
            print(f'获取图像失败,错误: {e}')
            attempt += 1
            time.sleep(1)                        # 等 1 秒再重试
    return None                                  # 三次都失败就放弃
源码里两套 OCR 是依次调用的;参赛 PPT 把它表述为"并行调用:百度 OCR / 讯飞 OCR"。本文按源码如实描述为依次调用,两者的实际效果差异不大,但如果后续要提速,把这两步改成真正的并发确实是可行的优化点。
七、作品创新点
- 用大模型替代题库,从根子上突破搜题软件的天花板。作业帮、小猿搜题一类产品的逻辑是"在库里找这道题",找不到就无能为力;本作品改用 DeepSeek 大模型,靠知识储备与推理能力作答,题目是否"在库里"不再构成限制,校本自编题、新题型同样可以解答。
- 语音与图文双通道,两种提问方式各管一段。概念不清的问题用嘴问(语音通道),具体某道题用眼睛"给"它看(图文通道),两条通道共用同一个 AI 大脑与同一套人格提示词,交互方式贴近学生真实的学习习惯。
- 双引擎 OCR 交叉校验,而不是程序里写死二选一。同一张照片同时送讯飞与百度两套 OCR,把两份原始结果连同题面一起交给大模型判断——利用了两个引擎"错法互补"的特点,也避开了自己设计置信度规则的麻烦。
- 提示词工程做出实打实的教学法。「小灯」人格不只是一种语气设定,它把三条教学原则写成了硬约束:禁用数学符号(解决 TTS 念不出符号的问题)、抽象概念必须配生活化类比(把"平面"讲成"无限延伸的桌面")、日常聊天限 30 字(不抢学习时间)。另外还用一个括号指令协议,让 AI 的回答可以"顺手"把灯和摄像头也控制起来。
- 载体与工艺都做对了取舍。载体选台灯,一物多用、不增加设备负担、价格与占地都可控;工艺从 3D 打印转向椴木板激光切割,解决了潮湿环境下打印件强度不足的问题,整机成本压在 500 元以内。加上一次很关键的交互迭代——从 webrtcvad 人声自动唤醒退回触摸按钮——整机在真实教室环境里的稳定性明显提高。
八、项目应用拓展
这套"摄像头 + 语音 + 大模型 + 提示词"的组合并不依赖台灯这一种外壳,把提示词和硬件接口换掉,就能迁移到不少场景:
| 拓展方向 | 实现要点 | 可迁移的能力点 |
|---|---|---|
| 教室公共答疑屏 | 把台灯换成挂壁式终端,摄像头朝讲台方向取景,复用同一套双 OCR 与 DeepSeek 问答流程 | 双通道输入、OCR 交叉校验、流式语音识别 |
| 低视力学生阅读辅助 | 把「小灯」提示词改为"逐句朗读并概括段意",输出全部走语音;字号、语速、音量做成可调参数 | 提示词工程、TTS 队列、界面可调项设计 |
| 实验报告/作业拍照批改 | 在提示词里加入评分标准与错因分类,让模型按维度点评;结果写入文件而非只上屏 | 多轮提问编排、结构化输出、文件落盘 |
| 老年用药与说明阅读器 | 把题目识别换成药品说明书识别,提示词换成"用最通俗的话说清用法用量与禁忌" | 局域网/离线部署、语音播报、大字号交互 |
| 课堂教具演示机 | 保留 P21 继电器控制回路,把 12V 灯换成其他负载,用来演示"程序如何控制强电回路" | 继电器安全隔离、强弱电分离布线 |
| 校本知识库助手 | 在提示词里注入校本讲义要点,让回答优先依据本校教材的口径 | 提示词注入、上下文组织、结果一致性控制 |
需要提醒的是:任何迁移都绕不开成本与隐私两道关——前端换成大模型在线接口,就意味着题目图片与语音要出校门;实际落地时要按学校的数据管理要求,评估是否改为本地化部署或对上传内容做脱敏。