国产芯片也能跑7B大模型?实测1080p视频场景9路,70字/秒,功耗30W
在安防、工业质检、智能机器人等边缘AI项目落地中,很多工程人员都会遇到一个普遍难题:业务既要多路摄像头实时画面分析,又需要本地大模型完成事件解读、报告生成。市面上多数边缘设备采用单芯片设计,视频识别和大模型推理共用一套算力资源。摄像头并发数量上来,大模型就会反应卡顿;大模型负载高,视频又容易丢帧漏检,两项业务很难同时稳定运行。
这款面向复合AI负载的高端边缘算力平台,专门针对“多路视频AI+本地大模型”同步运行的复合AI场景打造。下面从硬件构成、实测性能、同类产品对比三个方面完整介绍。
一、产品硬件构成
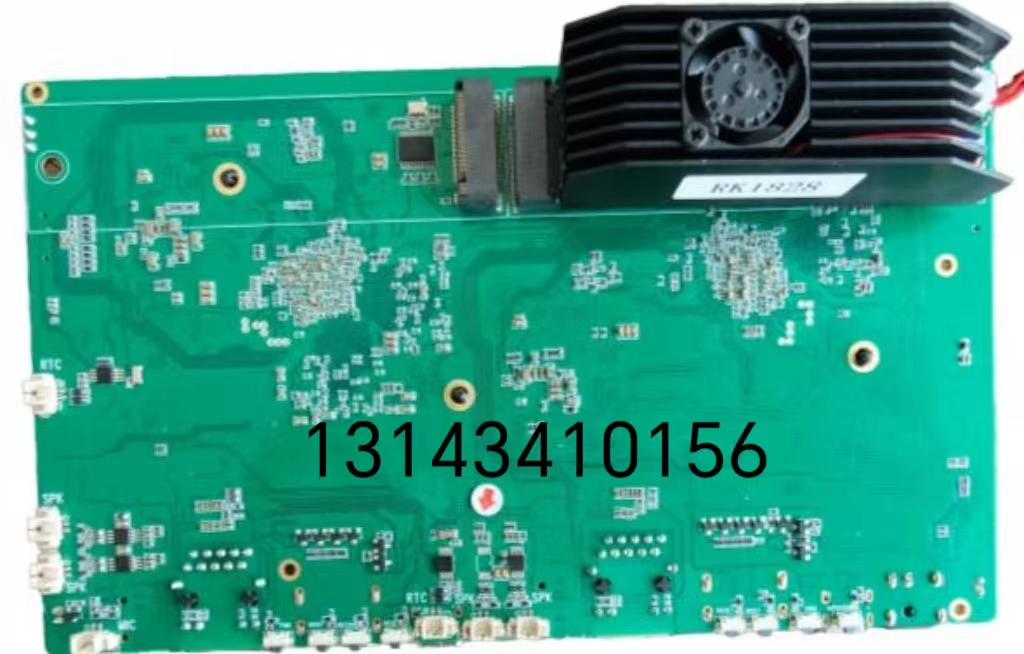
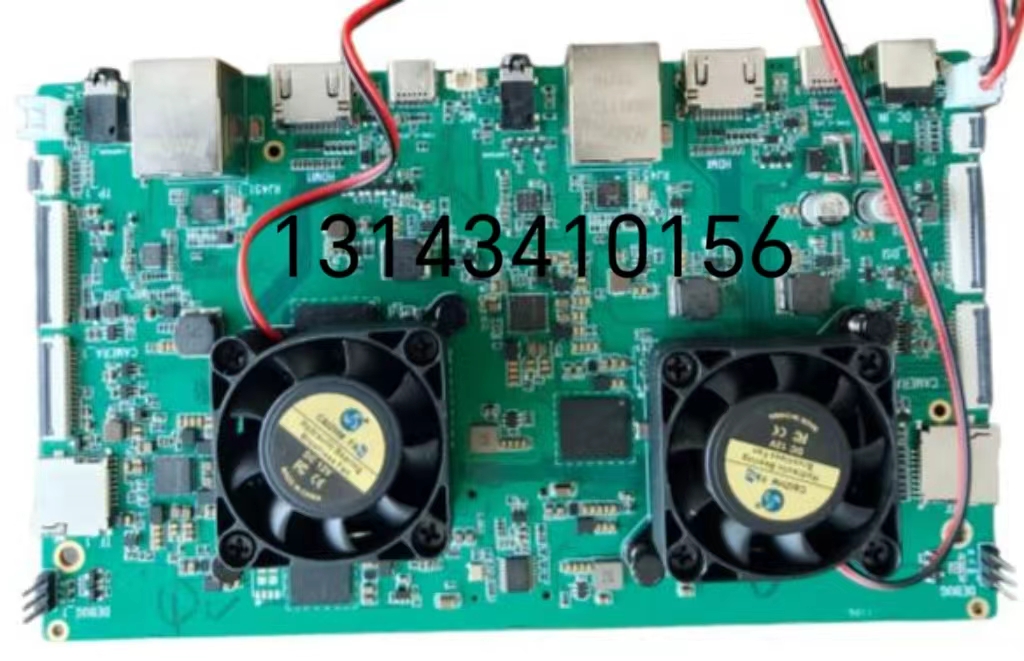
整机采用异构分工硬件架构:2片RK3588视觉计算单元 + 1片RK1828大模型AI协处理单元,不同硬件负责不同类型的计算工作,再由统一调度系统统筹管理全部任务。
1. 双RK3588视觉计算单元
两颗芯片主要包揽全部视频相关工作:网络视频接收、硬件解码、图像预处理、视觉目标AI推理,同时承担整机系统业务。两颗芯片之间通过PCIe高速通道互通数据,分担多路视频带来的巨大计算压力。每颗单元自带独立内存、存储,配套完整视频编解码硬件模块,专门适配多路监控、工业相机数据流。
2. RK1828 AI协处理单元
作为独立的大模型专用硬件,通过PCIe连接到整机,不参与视频解码、图像处理工作,全部算力留给大语言模型推理。相当于给大模型单独配备一套专属算力底座,不和视频业务抢夺硬件资源。
3. 接口与形态
板卡式整机集成设计,方便嵌入机箱、行业终端设备。
网络:2路千兆网口,对接网络摄像头;
输出:2路HDMI接口,支持画面显示输出;
外设:2路TypeC接口,可接键鼠做设备调试;
内部高速互联:依靠PCIe总线完成芯片之间数据交互。
4. 软件配套
双RK3588使用RKNN2推理框架,RK1828使用RKNN3大模型专用推理框架。已经完成YOLOv5s目标检测、Qwen2.57B大语言模型、Qwen3VL8B多模态图文模型适配验证;内置FFmpeg、OpenCV、RGA图像加速组件,基于Linux系统,支持开发者二次开发。
核心硬件设计思路:不靠单颗芯片包揽所有活,把视觉计算、大模型计算物理拆分,从硬件层面减少不同业务之间算力冲突。
二、产品可实现的实际性能(全部为实验室实测结果)
性能分为三部分:单独跑视频、单独跑大模型、视频+大模型同时满载运行(真实业务最常用场景)。
1、仅运行多路视频AI推理(不启动大模型)
测试模型采用行业通用YOLOv5s目标检测,模拟多路摄像头输入。
720P视频:最高支持16路并发推理。随着视频路数增加,整机整体识别吞吐会小幅回落,但可以稳定完成画面目标检测;
1080p视频:最高支持9路并发推理,满足高清工业相机、高清安防摄像头分析需求。
备注:测试得出的整体FPS代表整机合计处理吞吐,不等于每一路视频永久跑满60帧,系统会根据业务自动调度资源。
2、仅运行本地大模型(不运行视频业务)
RK1828独立运行Qwen2.57B大模型,最高支持8K超长上下文,可以读取数千字长文档再进行问答总结。
短文本1K上下文,文字生成速度约63token/s;即便开到8K长上下文,依旧可以稳定输出回答;
完成多轮连续会话测试:模拟工业验收业务,连续记忆多轮对话信息,完成标准整理、结果判定、生成总结报告,不会出现遗忘历史上下文、答非所问现象。
3、视频AI + 大模型联合负载(核心性能,模拟真实项目工况)
这是本产品最关键的能力,两套业务同时满载运行,模拟现场一边看摄像头、一边大模型做语义分析的真实工况。
1)720P视频场景:最高16路720P视频推理 + Qwen2.57B大模型持续多轮问答同步运行。视频并发拉满,大模型文字生成速度仅有小幅下降,基本稳定维持65token/s,不会随着摄像头数量增多持续大幅降速;视频识别也保持高吞吐,整套系统稳定工作。
2)1080p视频场景:最高9路1080p视频推理 + 7B大模型同步运行。高负载下大模型会有一定性能损耗,但依旧保持62token/s以上可用生成速度,整套设备不间断稳定运行。整机满载工作温控表现良好,芯片温度可控,不需要复杂昂贵散热方案,适合工业密闭机箱内部部署。
三、与市面主流同类型边缘产品对比
选取行业两大标杆产品:华为昇腾310P(Atlas300I Pro)、英伟达Jetson Orin AGX。
注意:对比参考多路视频+7B大模型同时工作的复合负载实测表现,不是芯片手册上面的纸面理论算力。很多产品单任务跑分很漂亮,混合业务下短板会暴露出来。
通俗解读差异
1.硬件逻辑不一样
昇腾310P、Orin AGX都属于“单芯片多面手”。单独跑视频,或者单独跑大模型的时候,性能亮眼。但到真实项目,两项重任务一起跑的时候,算力要来回分配。摄像头越多,分给大模型的算力就越少。
本产品采用任务硬件隔离思路:专门芯片处理视觉,独立协处理器运行大模型,依靠统一调度协同工作。优势集中在复合负载场景,不是单纯比拼单跑大模型的极限速度。
1.功耗部署优势
完成同等多路视频+7B大模型业务,整机功耗显著低于两款标杆设备。对于空间狭小、散热条件有限的工业机箱、边缘盒子更加友好。
适合和不适合的业务场景
✅适合:智慧安防园区、工业视觉质检、本地智能机器人,需要多路视频分析同时本地跑大模型,要求数据本地留存、不上云、低时延的项目。
❌不适合:完全没有视频解析需求,只单纯跑大模型推理的业务场景,本产品异构架构优势无法发挥。
总结
市面上不少AI硬件宣传着重芯片纸面算力,但是实验室单模型跑分不等于项目现场好用。
这款平台没有追求单芯片极致参数,而是针对边缘最普遍的“视觉+大模型”复合AI业务做硬件和软件协同优化。把视频处理、大模型推理进行硬件分工隔离,解决多AI任务抢算力的行业痛点,为边缘端数据不出场的AI项目提供一套稳定可行的硬件方案。