把圆屏小智变成会议记录机:DFR1221 语音转写与局域网纪要导出
开会时把大家的发言逐句转成文字,自动整理成 Markdown 纪要,手机或电脑连同一个 WiFi
打开网页就能看、能复制、能下载;纪要、转写和 WAV 录音同时存进板上的 TF 卡,
还能让小智把要点读给你听。
这块 1.85 寸圆屏原本只是个桌面 AI 小伙伴,本文记录怎么在不改小智 AI 全局源码、
不新增上行协议的前提下,把它改造成一台会议记录机。
文末给出编译好的固件,不想装 ESP-IDF 也能直接烧来试。
workbuddy,deepseek harness等,可使用自定义大模型,这个项目便是我现在使用硅基流动的大模型完成的。注册硅基流动,可免费获得16元模型使用代金券。注册地址:https://cloud.siliconflow.cn/i/KwyEBX3e,使用以上地址注册,你得16元代金券,我也得16元代金券(接着用)。
一、背景:从「能聊天」到「能记会」
硬件是 DFRobot 的 DFR1221 ESP32-S3 1.85 寸圆形触摸屏开发板:ESP32-S3R8、16MB Flash、
8MB OPI PSRAM、360×360 圆屏、CST816S 触摸、板载 PDM 麦克风、PCM5100A I2S DAC。
之前已经把它适配进了开源项目 xiaozhi-esp32。这里要再说明一次那次的起点:
官方 Wiki
和配套资料给的是产品规格、原理图、Arduino / ESP-IDF 点屏示例,并没有提供适配小智 AI 所需的板级源码
——小智 AI 要的是一个把显示、触摸、音频、背光、按键、唤醒词全部按框架接口接好的 Board 派生类,
这份驱动需要自己写,QSPI 引脚、触摸 RST/INT、DAC XSMT 等关键信号还得对照原理图和官方示例 pincfg.h 补齐。
适配完成后我把整套板型开源了,本篇就站在那个基础上继续做。
之所以想到会议纪要,是因为这块板的形态太合适了:一直插着 USB 供电、麦克风就在板上、
圆屏能显示状态,放在会议桌中间不占地方。而小智 AI 本身已经接了云端 ASR 和大模型,
等于语音识别这条最难的路已经铺好了,缺的只是「别一问一答,改成一直听」以及「把文字送到手机 / 电脑上」。
最终成果一览
| 项目 | 结果 |
|---|---|
| 连续听写 | 服务端 VAD 逐句断句(kListeningModeAutoStop);新增 StartListeningWithMode(),普通唤醒仍走 manual |
| 开始 / 结束 | 双击屏幕(主)、双击 BOOT(备)、语音指令、网页按钮,四种入口等价 |
| 转写累积 | 相对时间戳、相邻去重、最多 600 条;唤醒词与控制指令精确匹配后过滤 |
| 本地纪要 | 结构化 Markdown:要点摘录 / 待办候选 / 关键词命中 / 完整发言记录 |
| AI 精修 | 可选,任意 OpenAI 兼容 /chat/completions,Key 只存设备 NVS |
| 导出 | 局域网网页查看 / 复制 / 下载;TF 卡 .md + .txt + .wav 三件套,网页分块流式下载 |
| 语音播报 | 说「读一下会议纪要」调用 self.meeting.report,由云端 LLM + TTS 朗读要点与待办 |
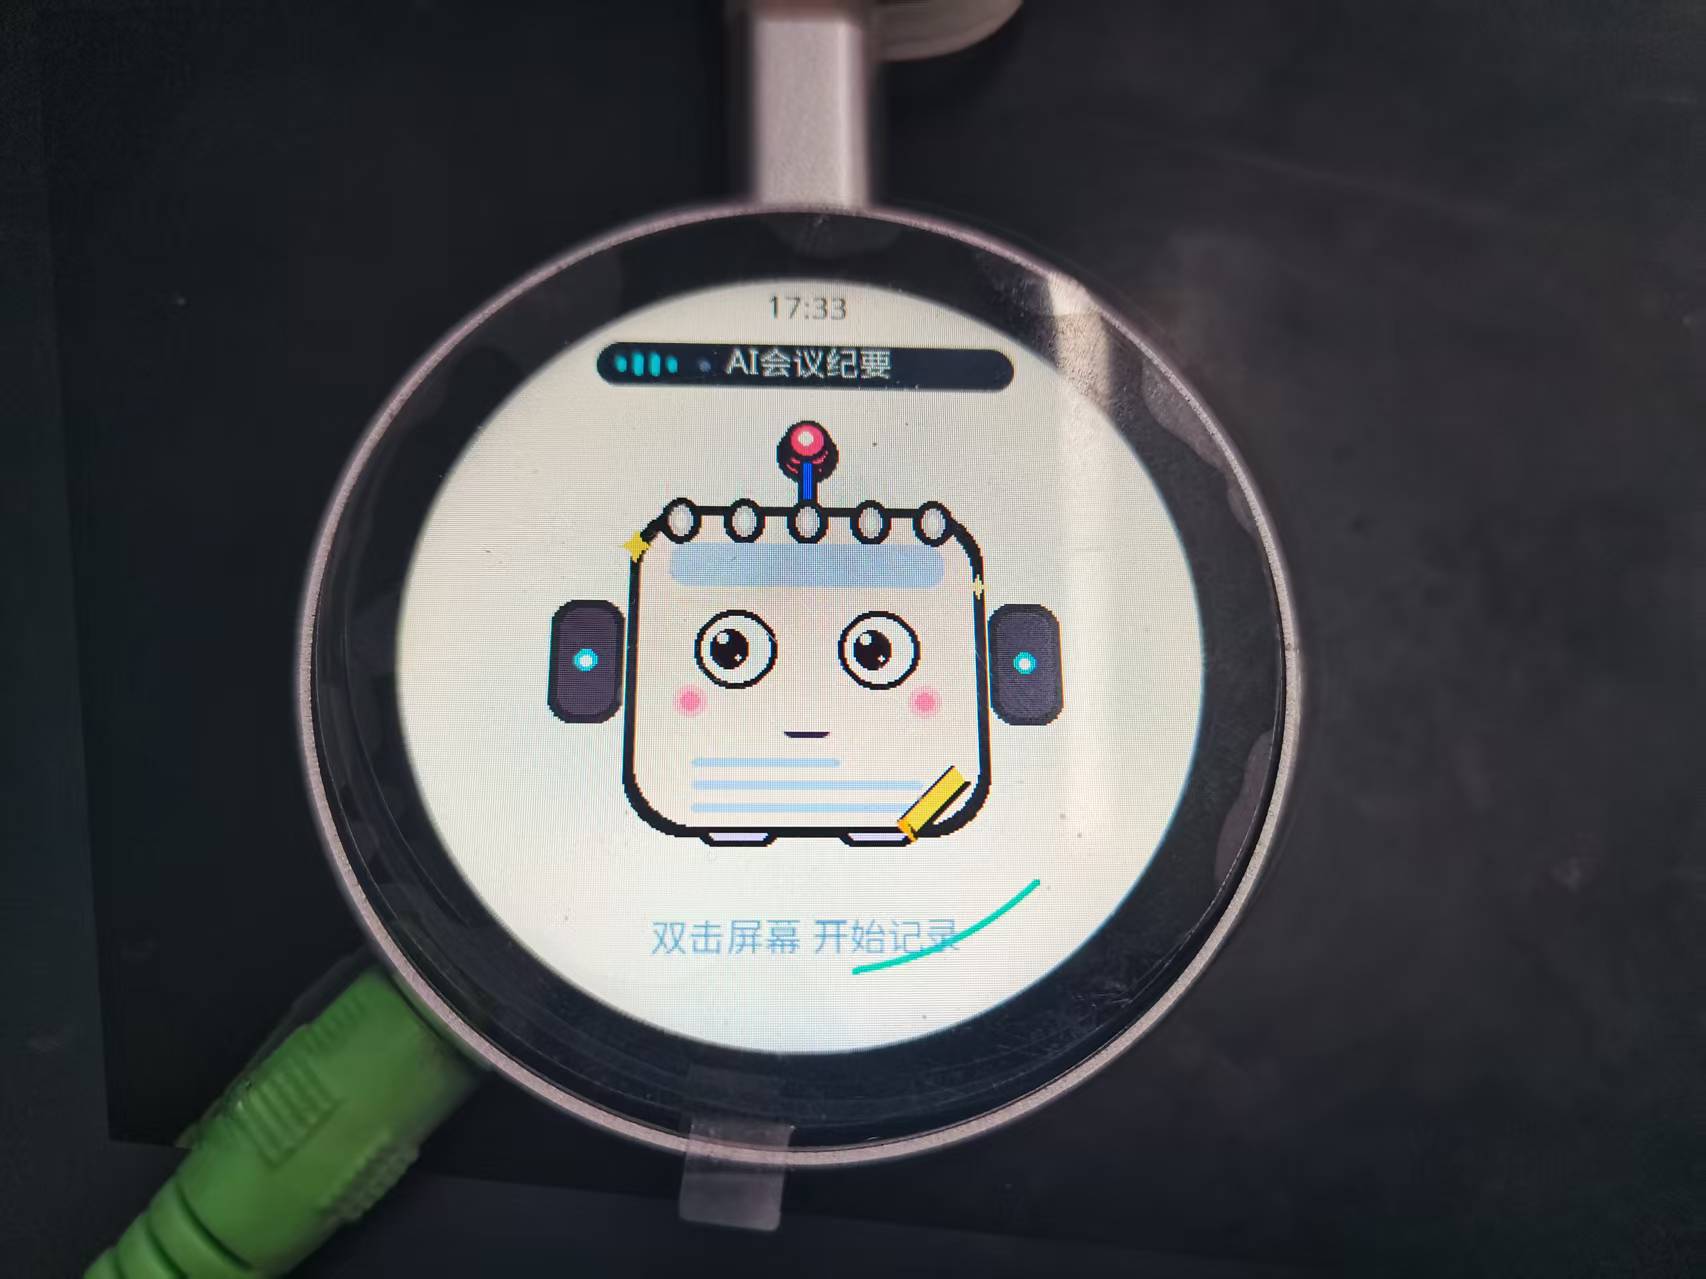
| 待机界面 | 去掉圆形时钟与原三套角色,只留会议主题角色「小纪要」常驻;动态「AI会议纪要」标识 + 双击提示 |
| 稳定性 | 5 秒守卫自动重连 goodbye 会话;WiFi 常驻性能模式消除网页卡顿 |
| 固件 | 16MB 合并镜像 + 5 个分分区 bin,Flash Download Tool 可直接烧 |
| 最终 app 大小 | 2,770,816 B,app 分区剩余 33%(删掉 24 个旧角色 GIF 后反而小了约 215 KB) |
语音对话控制
演示视频
手动双击控制
演示视频
二、踩坑零:manual 不是「连续听写」,是「对讲机」
一开始我以为这活儿最省事:Application::StartListening() 里用的就是 kListeningModeManualStop,
名字听起来就是「要手动停」,那不就是一直听下去吗?于是直接复用它,application.cc 一行没改。
第一次实测就打了脸。1 分 32 秒的会议,纪要里只留下两句:
[00:01:25] 你好小智
[00:01:32] 结束会议。
这两句恰好是唤醒词和结束指令——它们走的是普通对话链路,所以能出文字。
而会议期间真正的发言,一条都没有。
第二次更彻底:67 秒,0 条。我对着板子做了 22 秒的静音会议,全程 state 停在 listening、
没有任何 stt;直到用网页触发 Stop(),日志才变成这样:
I (1024439) Meeting: meeting STOP
I (1024439) StateMachine: State: listening -> idle
I (1024719) Application: >> 诡异停止记录。      ← 280 ms 后才吐出识别结果
I (1024759) StateMachine: State: idle -> speaking
也就是说:manual 是对讲机(PTT)语义。服务端把整段音频攒在缓冲区,
只有收到客户端 listen stop 时才做一次整段识别,它压根不做逐句断句。
所谓「连续听写」,只是我望文生义的想象。
真正的逐句转写要用 kListeningModeAutoStop:服务端用 VAD 自己断句,说完一句就下发一条 stt。
但 Application::StartListening() 把模式写死了,SetListeningMode() 又是私有方法。
所以给 Application 加了一个公开入口:
void Application::StartListeningWithMode(ListeningMode mode) {
    pending_listen_mode_ = mode;
    xEventGroupSetBits(event_group_, MAIN_EVENT_START_LISTENING);
}

void Application::StartListening() {          // 普通点击唤醒保持原样
    pending_listen_mode_ = kListeningModeManualStop;
    xEventGroupSetBits(event_group_, MAIN_EVENT_START_LISTENING);
}
HandleStartListeningEvent() 里原本三处硬编码的 kListeningModeManualStop 改为读
pending_listen_mode_,并补了「已经在 listening 时按新模式重发」的分支。
会议开始时请求 auto,单击唤醒仍然走 manual,两边互不影响。
守卫重连也必须显式带 auto,否则线一断就悄悄退回 manual,转写再次归零。
换成 auto 之后的两个新问题
auto 让转写通了,但每句都会触发完整的 LLM + TTS 回复——开会时设备不停插嘴,
而且它说话期间麦克风是关的。两个补丁:
- 打断回话:
SetChatMessage()收到role=assistant且正在开会时,
立即AbortSpeaking()并跳过渲染。实测listening -> speaking -> listening
只需约 0.9 秒,麦克风静默时间从「整段回复」压到不到 1 秒。 - 丢弃尾部残留:
Stop()之后服务端仍会把已上传的音频 flush 出来,
表现为idle -> speaking、设备突然自说自话。现在停止后 8 秒内到达的stt
直接丢弃(日志drop late stt after meeting stop),不显示、不记录、不触发对话。
文字怎么拿到
application.cc 收到 stt 后会调用 Display::SetChatMessage("user", text) 上屏,
而这个函数是虚函数。所以在板型的 Display 派生类里覆写一次,就能把每条识别结果顺手收进会议缓冲区:
void SetChatMessage(const char* role, const char* content) override {
    PetAvatarDisplay::SetChatMessage(role, content);   // 原来的上屏逻辑照常
    if (role && content && strcmp(role, "user") == 0) {
        MeetingManager::GetInstance().AppendUserSpeech(content);
    }
}
缓冲区里每条记录带 [hh:mm:ss] 相对时间戳、相邻重复自动去重、最多保留 600 条,全部在 meeting.h 里。
三、怎么开始、怎么结束
这是实测下来最容易被卡住的地方,所以单独讲。四种入口等价:
| 方式 | 开始 | 结束 |
|---|---|---|
| 双击屏幕 | 双击一次 | 再双击一次(推荐,最直观) |
| 双击 BOOT 键 | 双击一次 | 再双击一次(触摸失效 / 熄屏时备用) |
| 语音 | 「开始会议」「帮我把会议记下来」 | 「结束会议」「停止记录」「生成会议纪要」 |
| 网页 | 打开 http://<设备IP>/ 点「开始会议」 |
点「结束并整理」 |
对应注册了 4 个 MCP 工具:self.meeting.start / stop / status / summarize。
设备 IP 在开机日志 MeetingWeb: meeting web UI at http://... 里,开始录制时屏幕通知也会显示一次,
不用另外翻路由器后台。
会议模式下设备不会用 TTS 回应你(云端为每句生成的回复,在第一句到达时就被打断),这是第一次真人实测时最真实的困惑:说了「结束会议」,
屏幕没动静、也没声音,根本不确定会议到底结束没有。为此做了三件事:
- 开始录制时屏幕常驻 20 秒提示,同时显示网页地址和结束方式;
- 结束后明确弹「会议已结束,纪要已生成」;
- 说「结束会议」时,除了等云端 LLM 调
self.meeting.stop,设备端本地也识别这句话并直接调Stop()(幂等,云端随后再调一次也无害)。
第 3 点的实现是把 stt 文本先做去标点归一,再用一份精确匹配的控制指令表分类:
ControlKind control = ClassifyControl(s);
if (control != ControlKind::kNone) {
    ESP_LOGI(kTag, "skip control utterance: %s", s.c_str());
    if (control == ControlKind::kStop) {
        ESP_LOGI(kTag, "local stop command -> ending meeting");
        Application::GetInstance().Schedule([]() {
            MeetingManager::GetInstance().Stop();
        });
    }
    return;  // 不写入转写
}
精确匹配很重要:会议里说「我们下周的会议改到周三」「会议纪要要在明天之前整理好」,
这些真实句子必须原样保留。我用 11 组用例校验过分类逻辑,含「会议」二字的长句全部判为正常发言,
只有「结束会议。」「小智,结束会议」「请生成会议纪要」这类短指令才被过滤。
四、踩坑一:双击屏幕和单击唤醒打架
把结束方式从 BOOT 键改到屏幕,看起来只是换个触发源,实际动到了整套触摸事件链。
LVGL 没有内置双击事件,得自己用「两次 CLICKED 的时间 + 坐标差」判定;而原来的单击是立刻执行的。
| 冲突对象 | 现状 | 不处理的后果 | 解法 |
|---|---|---|---|
| 单击唤醒对话 | OnTap() 收到 LV_EVENT_CLICKED 立刻 ToggleChatState() |
第一下先唤醒 / 切换对话,第二下才算双击 —— 每次开会必先误触发一次对话 | 单击改为延迟执行,窗口内出现第二下就取消单击 |
| 左右滑动 | RegisterSwipe() 用 suppress_click_ 抑制 CLICKED |
延迟单击是个待执行定时器,滑动时不清掉,松手后照样误唤醒 | 滑动时同时取消待执行单击并清空双击状态;现在只保留一个角色,手势只负责消歧 |
| 事件冒泡 | screen / container / content 三层都挂 TapCb,聊天气泡另加 EVENT_BUBBLE |
一次物理点击可能回调多次,被误判成「超快双击」 | 60ms 时间窗去重 |
| 录制中误触 | 单击会 ToggleChatState() |
把 listening 停掉,守卫 5 秒后才重连,丢 1~2 秒语音 |
录制中忽略单击唤醒,双击仍可结束会议 |
最终实现是一个 360ms 的 lv_timer(比 320ms 双击窗口晚 40ms 触发,保证第二下点击先被处理):
void OnTap() {
    uint32_t now = lv_tick_get();
    if (now - last_click_ms_ < kTapDedupMs) return;   // 冒泡去重
    last_click_ms_ = now;

    if (suppress_click_) {                            // 滑动吞掉这次点击
        suppress_click_ = false;
        CancelSingleTap();
        pending_tap_ms_ = 0;
        return;
    }
    bool is_double = pending_tap_ms_ != 0 &&
                     now - pending_tap_ms_ <= kTapWindowMs &&
                     Abs(point.x - pending_tap_x_) <= kTapMaxDist &&
                     Abs(point.y - pending_tap_y_) <= kTapMaxDist;
    if (is_double) {
        pending_tap_ms_ = 0;
        CancelSingleTap();
        ToggleMeeting();                              // 开始 / 结束会议
        return;
    }
    pending_tap_ms_ = now;                            // 第一下:先别唤醒
    pending_tap_x_ = (int)point.x;
    pending_tap_y_ = (int)point.y;
    ArmSingleTap();
}
代价要说清楚:单击唤醒多了约 0.54 秒延迟(双击窗口 500ms + 40ms 余量)。换来的是双击可靠、录制中不丢语音。
BOOT 键的单击 / 长按(配网)、唤醒词、顶部状态栏走的是别的输入源,与双击完全不冲突;
BOOT 双击保留作硬件备用入口。
串口日志分别是 Touch tap #N ... -> DOUBLE、Double tap -> toggle meeting recording、
single tap ignored while meeting is recording。
补记:真正让「双击没反应」的是 LVGL 默认可点击
上面那套判定逻辑本身没问题,但把界面收敛成单角色常驻之后,实测反馈是「双击完全没反应」。
查下去发现 lv_obj_create() 在 LVGL 9 里默认就带 LV_OBJ_FLAG_CLICKABLE:标准 UI 的
emoji_box_(角色容器)、顶部状态栏、聊天气泡,加上本板型新增的嘴型与待机装饰对象,
全都是可点击却没有注册回调、也没开事件冒泡的「事件黑洞」。而屏幕正中央恰好就是底部
「双击屏幕 开始记录」提示指向的位置,点击先落到 emoji_box_ 上被吞掉,
根本到不了注册在屏幕上的 TapCb。
修法是让整棵 UI 对象树把事件冒泡上去:
static uint32_t BubbleTree(lv_obj_t* obj) {
    lv_obj_add_flag(obj, LV_OBJ_FLAG_EVENT_BUBBLE);
    lv_obj_add_flag(obj, LV_OBJ_FLAG_GESTURE_BUBBLE);
    // ...递归所有子对象,返回覆盖的控件数
}

// SetupUI(): 对 lv_screen_active() 递归执行一次;CHILD_CREATED 事件本身
// 也会冒泡,于屏幕层挂一个回调即可覆盖后建的聊天气泡 / 弹窗。
冒泡之后一次物理点击会送来多份 PRESSED / CLICKED,于是去重从「60ms 时间窗」换成
「按下序号」:PRESSED 80ms 内只计一次并递增 press_seq_,CLICKED 只接受该序号下第一份;
双击坐标改取按下时坐标(抬起时 LVGL 可能已报 0)。同时把窗口放宽到 500ms、坐标容差 90px,
并让滑动手势不再清空待判定的双击 —— 手指轻微移动不再把双击打断。
为了不用每次都手摸屏幕,加了诊断入口 POST /api/tap:网页排队两次合成点击,由 LVGL 线程
走同一条 OnTap() 路径。实测日志:
touch event bubbling enabled for 28 widgets
Touch tap #1 (0,0) dt=0  dist=(0,0) -> single
Touch tap #2 (0,0) dt=70 dist=(0,0) -> DOUBLE
Double tap -> toggle meeting recording
Meeting: meeting START      StandbyBadge: standby badge: recording
... 再双击 ...
Meeting: meeting STOP       StandbyBadge: standby badge: idle
/api/status 的 recording 同步走完 false → true → false,WAV 与纪要也照常写入 TF 卡。
到这里,「双击开始 / 再双击结束」的整条链路才算真正闭环。
真人手指复测:合成点击不算数,得拿手点
合成点击只能证明「判定逻辑」对,证明不了「手指点得上」。所以又挂了 12 分钟串口,
让真人直接双击圆屏(build_tmp/realtouch_verify.log)。这回拿到的是完整的
开始 → 记录 → 停止 → 语音播报:
I (554738) DfrobotS3Round185: Touch press #9  at (223,178)
I (554778) DfrobotS3Round185: Touch tap   #9  (223,178) dt=12860 -> single
I (554918) DfrobotS3Round185: Touch press #10 at (232,168)
I (554938) DfrobotS3Round185: Touch tap   #10 (232,168) dt=170  dist=(9,10) -> DOUBLE
I (554938) DfrobotS3Round185: Double tap -> toggle meeting recording
I (554958) SdCard: WAV recording started: /sdcard/meetings/M20261109_215347.wav
I (554958) Meeting: meeting START
... 11 段逐句 stt ...
I (644578) Touch tap #11 (206,166) -> single
I (645138) single tap ignored while meeting is recording
I (671548) Touch tap #12 (210,168) -> single
I (671818) Touch tap #13 (206,176) dt=275 dist=(4,8) -> DOUBLE
I (671818) Double tap -> toggle meeting recording
I (671848) SdCard: WAV saved: 3703680 bytes of PCM
I (671848) Meeting: meeting STOP
I (671968) Meeting: minutes generated: 1882 bytes
I (672078) SdCard: meeting saved to TF card: M20261109_215347.md / .txt
两次真人双击的间隔分别是 170ms 和 275ms、坐标漂移 9~10px,都稳稳落在 500ms / 90px 窗口里;
录制中误触的单击被忽略,而第二次双击仍能在 listening 状态下把会议停掉。
3,703,680 字节 PCM ≈ 1 分 56 秒的 16kHz / 16bit / 单声道录音,与纪要里的
「共记录 11 段发言」对得上,全程无 assert、无重启。
顺带把第 4 点「能不能用对话播放纪要」也实测了:对设备说「读一下会议纪要」,
云端调用 self.meeting.report 后 TTS 依次念出
「这是刚才的会议纪要。会议时长 1 分 56 秒,共记录 11 段发言……没有识别到明确的待办事项。
完整纪要可以在手机或电脑浏览器打开网页查看或下载。」
I (737878) Application: >> 读一下会议纪要。
I (738328) Application: << % self.meeting.report...
I (739058) Application: << 这是刚才的会议纪要。
I (741138) Application: << 会议时长 1 分 56 秒,共记录 11 段发言。
小瑕疵:云端偶尔会把工具调用本身当成一句文本推下来,屏幕上会一闪而过
% self.meeting.report...。它不影响播报内容,属于服务端 LLM 的回显,未在设备端强行过滤。
五、纪要怎么生成:本地优先,AI 可选
结束会议时设备立即在本地生成一份结构化 Markdown,包含会议开始时间、记录时长、片段数 / 字数,以及四节正文:
- 要点摘录 —— 按「决定 / 结论 / 方案 / 风险 / 进度 / 预算…」等关键词挑句;
- 待办事项候选 —— 按「需要 / 负责 / 跟进 / 截止 / 下周 / 明天…」挑句,直接写成
- [ ]勾选框; - 关键词命中 —— 统计「决策 / 排期 / 复盘 / 客户…」出现次数;
- 完整发言记录 —— 按时间戳排列的逐句转写,一句不丢。
这里必须说实话:本地纪要是关键词启发式,不是大模型总结。它的价值是断网、没配 Key 也一定能出一份可读底稿。
想要更像样的「议题 / 讨论要点 / 决议 / 待办表格 / 风险」,可以在网页「API 设置」里填任意 OpenAI 兼容的
/chat/completions 端点、Key 和模型,结束会议时自动再生成一份 AI 精修版。
Key 只写进设备 NVS,网页不回显明文,仓库里没有任何 Key。
第一次真人实测还暴露了一个体验问题:短会、口语化发言往往一个关键词都命中不了,
于是要点 / 待办 / 关键词三节全是「(无)」,整份纪要等于空的。现在改成:
- 没匹配到要点时,自动退回「按时间列出全部发言(最多 15 条)」供人工提炼;
- 发言片段 ≤2 条但会议时长 ≥1 分钟时,纪要头部主动提示去查串口日志和会话重连。
纪要本身也存进 NVS 的 meeting 命名空间(约 11KB 上限),重启后仍能在网页看到;
超长会议的完整版从网页下载。
六、手机 / 电脑怎么拿到:一个网页,不用装 App
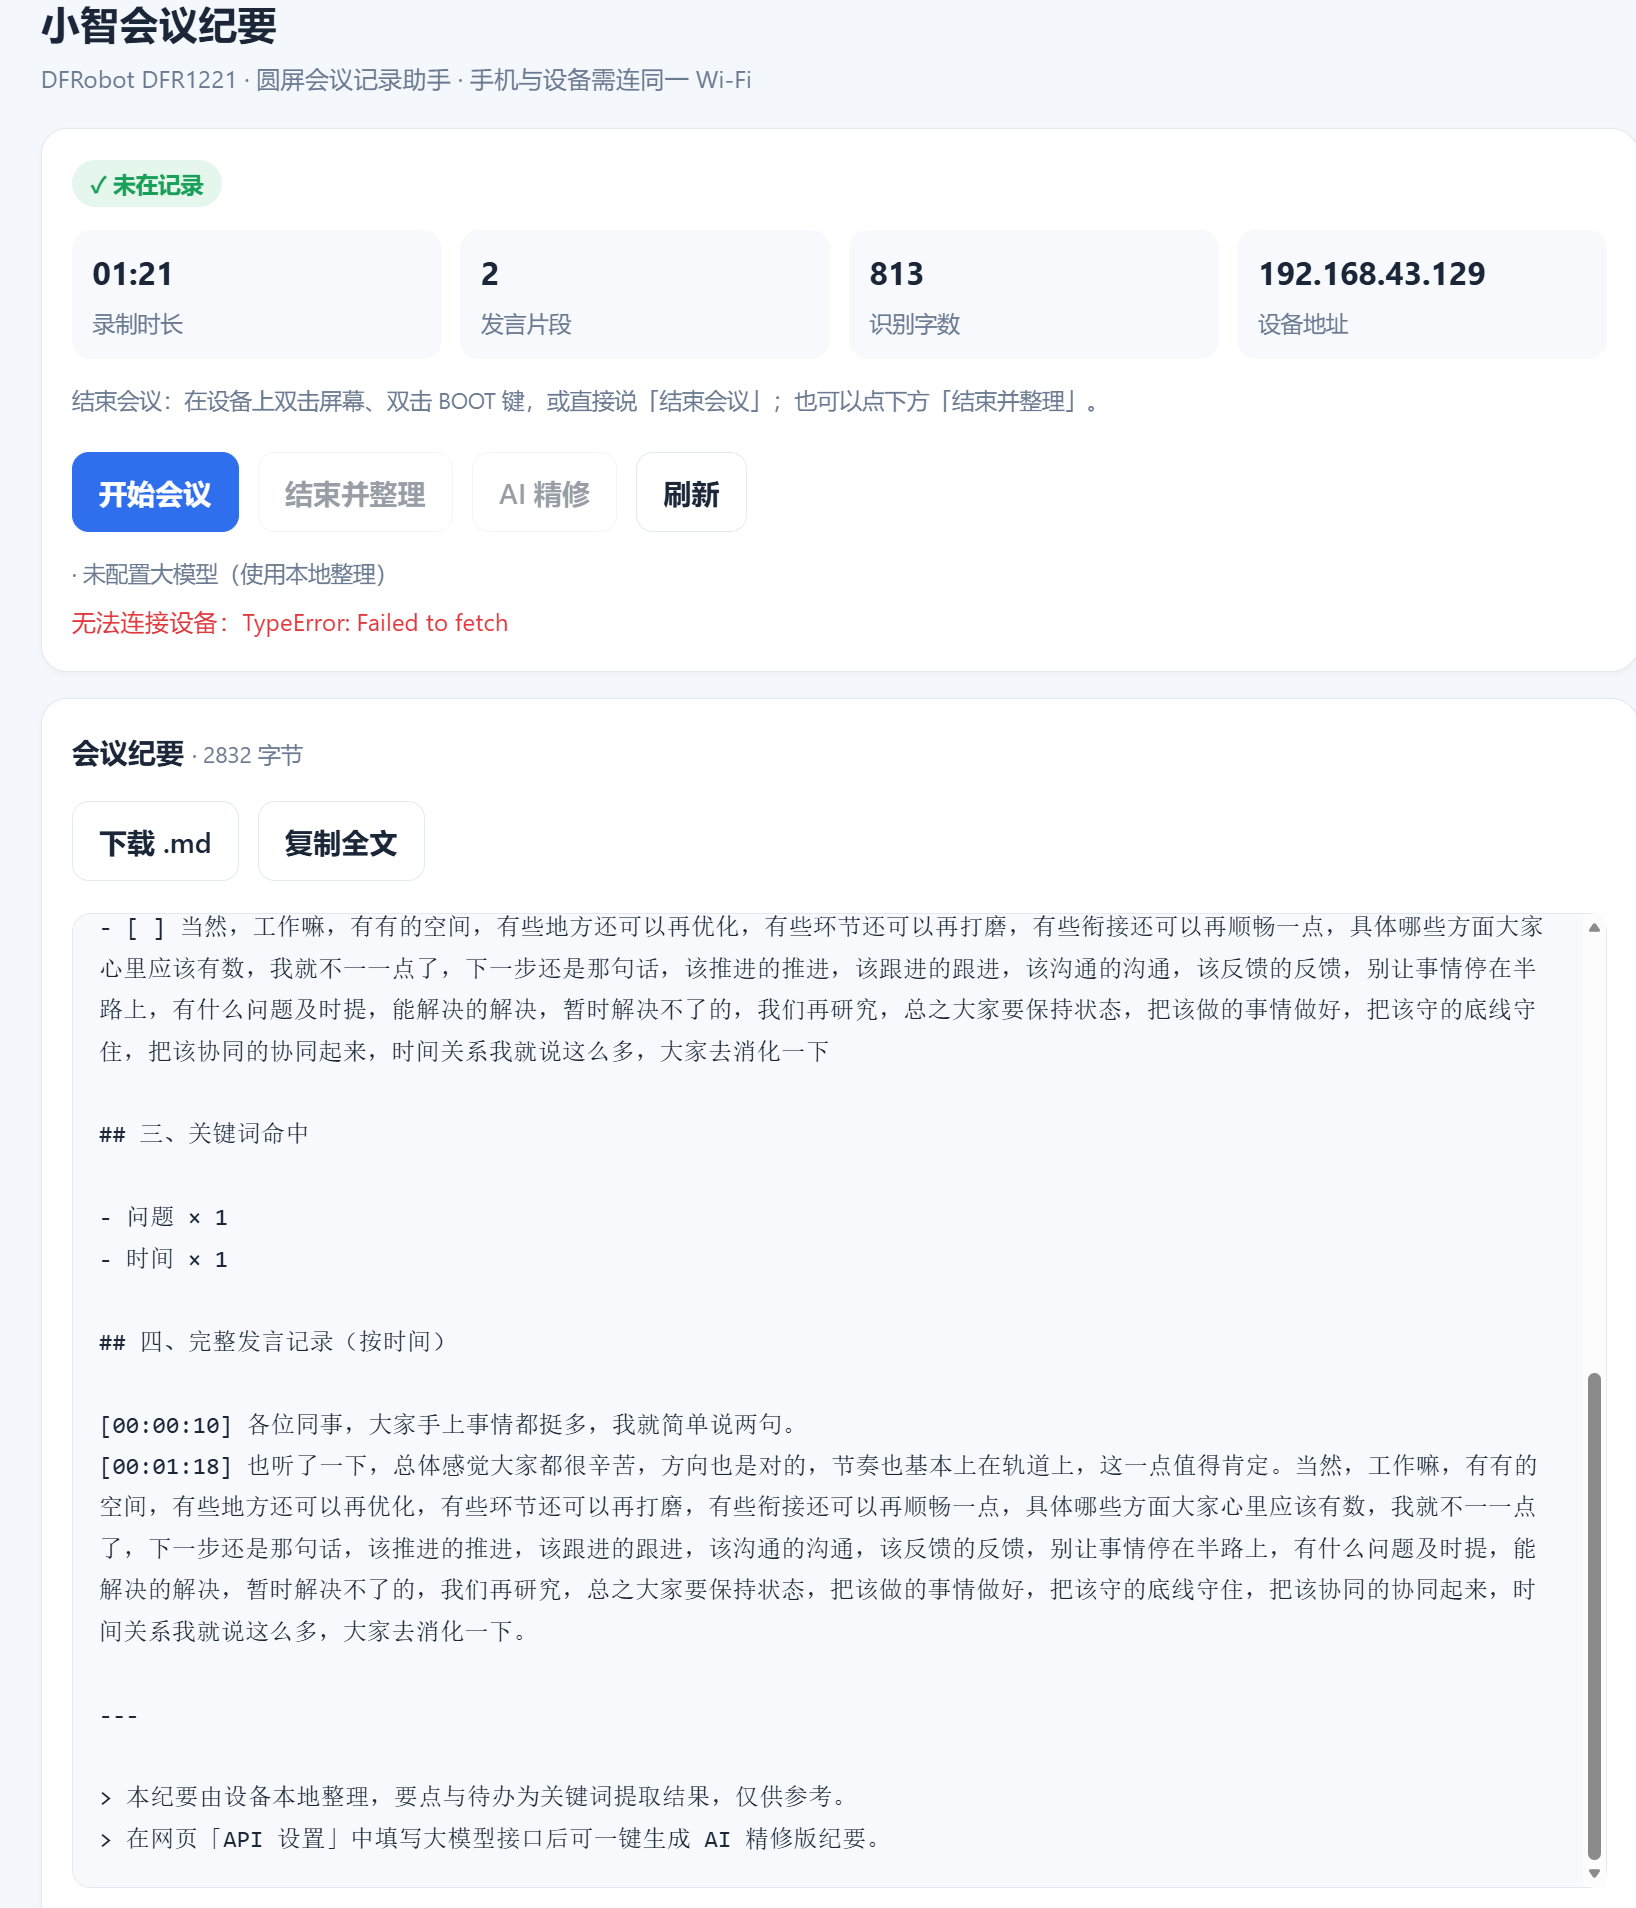
meeting_web.h 在设备上起了一个 HTTP 服务(80 端口,被占用时回落 8080),内嵌一个适配手机和电脑的响应式页面:
实时状态(是否录制、时长、片段数、字数、AI 状态,4 秒自动刷新)、纪要全文、完整转写折叠区、
「复制全文」和「下载 .md」按钮,以及 API 设置表单。页面上还直接写明了四种结束方式。
| 接口 | 作用 |
|---|---|
GET / |
网页 |
GET /api/status |
JSON 状态快照(含纪要全文) |
GET /api/transcript |
带时间戳的纯文本转写 |
GET /api/minutes |
Markdown 纪要 |
GET /download |
以附件形式下载 meeting-minutes.md |
POST /api/start / /api/stop |
开始 / 结束录制 |
POST /api/summarize |
触发 AI 精修 |
POST /api/config |
保存 / 清除 API 配置 |
七、踩坑二:网页时快时慢,真凶不在 HTTP
先用的是 esp_http_server,加上 Connection: close、lru_purge_enable、
httpd_sess_trigger_close() 之后仍有 1~4 秒抖动和偶发超时。ping 一测才发现方向错了:
平均 435ms、最长 1022ms、丢包 10%,是 WiFi 周期性省电在等下一个 beacon。
板级覆写 SetPowerSaveLevel(),强制常驻性能模式:
virtual void SetPowerSaveLevel(PowerSaveLevel) override {
    WifiBoard::SetPowerSaveLevel(PowerSaveLevel::PERFORMANCE);
}
改完 ping 稳定 37ms、0% 丢包,三轮 HTTP 全部接口 1335ms。代价是待机功耗略增,
本板 USB 供电可以接受。顺带把服务换成裸 BSD socket:一请求一连接、发完即关、
显式 Content-Length 与 Connection: close,不再有 keep-alive 占 worker 的问题。
调试提示:PC 上如果开了全局 HTTP 代理,测设备内网地址会得到
HTTP 000或超时,
用curl --noproxy '*'或裸 socket 直连,别被代理误导。
八、踩坑三:开到两分钟,服务端主动说 goodbye
长会议日志里会出现 MQTT: Received goodbye message,随后状态机 listening -> idle,
音频通道就断了 —— 人还在说话,却不再有转写。加了一个 5 秒守卫定时器,
发现状态掉出 Listening 就重新 StartListening():
W (xxxxx) Meeting: listening session dropped (state=3), re-arming
I (xxxxx) Application: STATE: idle -> connecting
I (xxxxx) Application: STATE: connecting -> listening
串口已实机验证恢复成功。守卫还会避开正在处理中的一句话(4 秒节流)和刚重连过的窗口(8 秒节流),
不会和正常对话抢状态。重连期间约 1~2 秒语音可能丢失,这是目前最值得继续打磨的一点。
九、两次真人实测:从 0 条到逐句成文
说「你好小智」→ 云端调用 MCP 开始开会 → 说「结束会议。」→ 设备确实产出了纪要。
这是 stt 文字第一次真实地流进 MeetingManager,原样输出如下:
# 会议纪要

- 会议开始:2026-11-08 22:55:32
- 记录时长:[00:01:32]
- 发言片段:2 条 / 27 字
- 生成设备:DFRobot DFR1221 小智会议助手
- 生成方式:设备本地结构化整理

## 一、要点摘录
(未从转写文本中匹配到明显要点,请直接看下方完整发言记录)

## 二、待办事项候选
(未识别到明确的待办表述)

## 三、关键词命中
(无)

## 四、完整发言记录(按时间)
[00:01:25] 你好小智
[00:01:32] 结束会议。
一眼能看出两个问题,都已按第三、五节的方式修掉:
- 唤醒词和结束指令被当成会议发言(
你好小智、结束会议。),现在会被精确匹配过滤; - 三节全空,现在会退回按时间列出全部发言。
但当时还有一件更要紧的事没想通:会议时长 1 分 32 秒,第一条转写却出现在 [00:01:25]。
我一度怀疑是采集链路、会话状态、甚至云端 VAD 的问题,直到第二次实测拿到 67 秒 0 条,
才顺着串口日志找到了真正的答案 —— 模式选错了,manual 根本不做逐句识别,详见第二节。
修复后复测:三轮发声,三条独立转写
换成 kListeningModeAutoStop 之后,用三轮独立发声、中间留静音做回归,串口时序如下:
I (22898) Meeting: meeting START
I (23088) State: connecting -> listening
I (34988) Application: >> 小块灭大。
I (34988) Meeting: [00:12] 小块灭大。
I (35018) State: listening -> speaking          (云端开始为这句生成 TTS)
I (35828) DfrobotS3Round185: mute assistant reply during meeting
I (35898) State: speaking -> listening          (0.9 秒后恢复听写)
I (57448) Meeting: [00:34] BI时代对于已经成为超级个体的同学们来说...
I (62818) Meeting: [00:39] 仓库如何快速的找到你想要工作的那个代码仓库呢?
I (65068) Meeting: meeting STOP
I (65268) DfrobotS3Round185: drop late stt after meeting stop: 啊,昨天我已经上。
每次发声都独立成条,纪要输出 3 条 / 200 字,时间戳连贯;停止后到达的残留片段被明确丢弃。
生成的纪要(节选):
- 记录时长:[00:00:42]
- 发言片段:3 条 / 200 字

## 一、要点摘录

> 未匹配到明显要点关键词,以下按时间列出全部发言,便于人工提炼。

1. [00:00:12] 小块灭大。
2. [00:00:34] BI时代对于已经成为超级个体的同学们来说,可能已经积攒了上百个战码仓库。那么有。
3. [00:00:39] 仓库如何快速的找到你想要工作的那个代码仓库呢?
说明:这次复测用系统蜂鸣声代替真人说话,验证的是「有声音 → 服务端 VAD 断句 → 逐条
stt→
时间戳入库」这条链路本身,识别出来的文字自然不是正常语句。时序、条数、会话恢复、打断与过滤
都是真实运行的;真人语音的识别质量由云端 ASR 决定,设备端不参与。
十、把界面收成「会议专用」
功能跑通之后,界面反而显得杂:待机是圆形模拟时钟,对话时才切回角色,另外还有三套可以左右滑动切换的形象。
既然这台设备现在的主业是记会,我把这几样都收掉了:删除待机表盘,删除小糯 / Grok Bot / 豆包三套角色,
只保留本轮新画的「小纪要 Minute Bot」,并且让它从开机到对话一直待在屏幕中央。
clock_face.h 这个历史文件名保留了下来,但内容重写成两个互不干扰的部分:
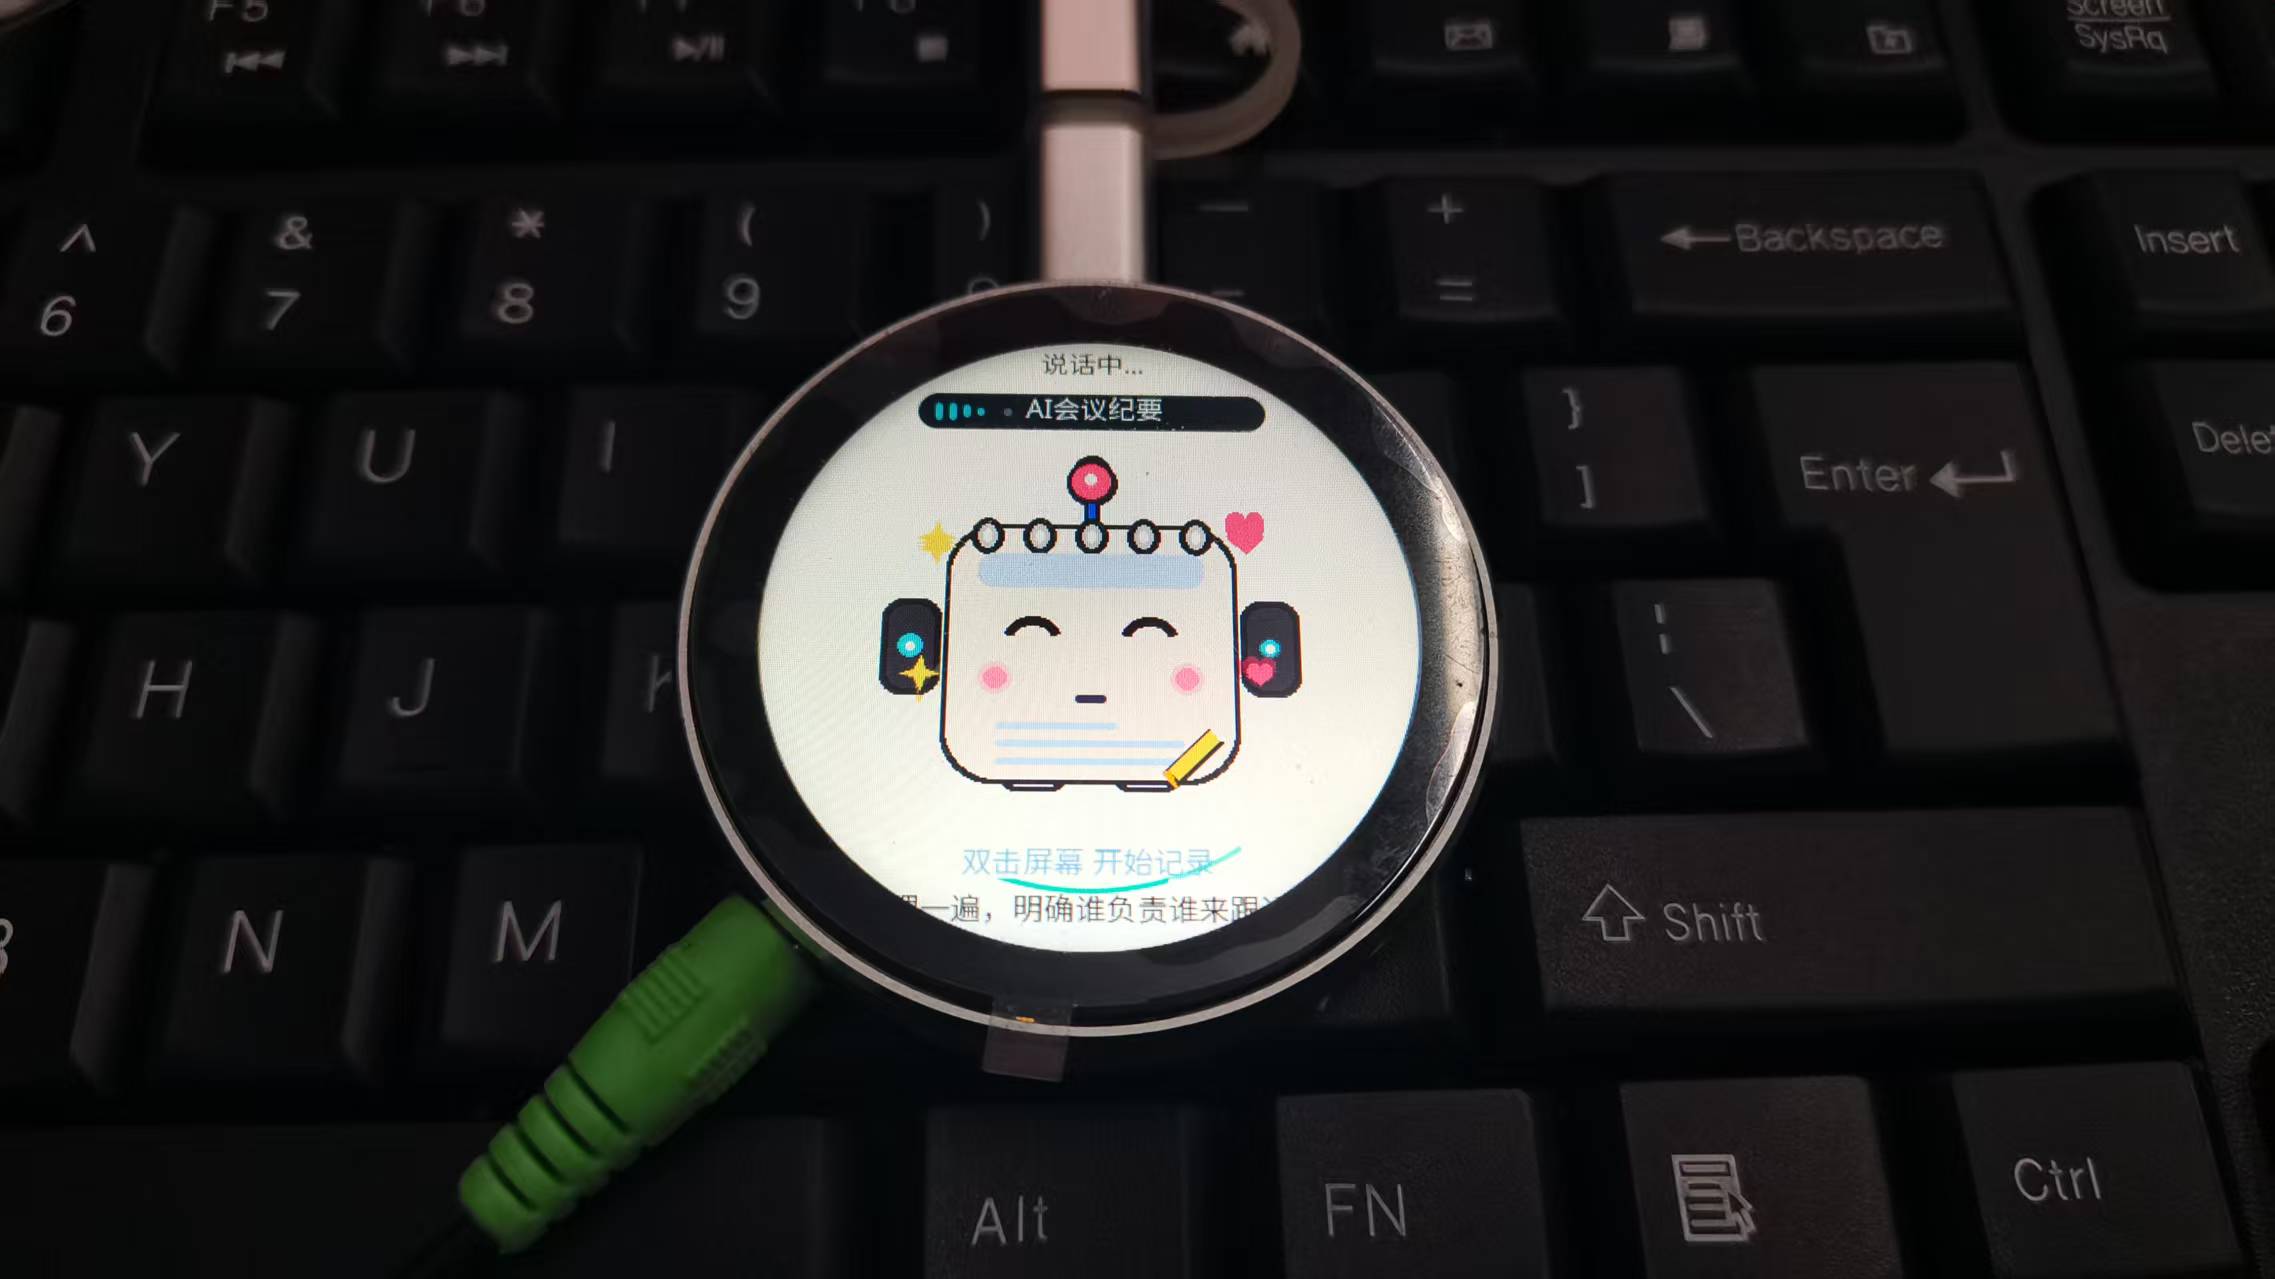
ClockTimeSync继续负责校时 —— 会议时间戳、顶部状态栏HH:MM、语音提醒都还依赖它,只是不再画表盘;StandbyBadge负责「会议感」:360px 圆屏外圈一段旋转扫描弧、顶部AI会议纪要标识条
(四根随状态起伏的声波柱 + 呼吸式 REC 灯)、底部双击屏幕 开始记录提示。
录制状态用一个 std::atomic<bool> g_meeting_recording_ui 从 meeting.h 单向传给待机层,
避免装饰代码反向依赖会议模块。开始录制后标题变成 AI会议纪要 REC、扫描弧转红、提示变成
双击屏幕 结束并生成纪要;结束后自动还原。串口里能直接看到:
I (32329) StandbyBadge: standby badge: recording
I (36369) StandbyBadge: standby badge: idle
角色部分,PetAvatarDisplay 不再有「idle 隐藏 GIF、显示时钟」这条分支,8 种状态 GIF 常驻,
嘴型仍由真实 TTS 幅度驱动。generate_pet_assets.py 的 SKINS 只注册 minutes 一套,
GIF 从 4 x 8 = 32 个(290.7 KB)降到 8 个(75.8 KB),编译进 app 的资源数组也同步缩小。
左右滑动的手势检测保留,但 NextSkin() / PrevSkin() 变成空实现 —— 它现在的唯一作用仍是
取消误触,日志也从 switch character 改成了 tap cancelled (single character)。
十一、踩坑四:8GB TF 卡挂不上,问题不在引脚
DFR1221 板载 microSD 卡槽,官方 ST77916_LVGL_DEMO/pincfg.h 给出了 4-bit SDMMC 引脚,
原理图里 DAT0~DAT3 / CMD / CLK 也确实全接上了:
#define SD_MMC_D0_PIN 2    #define SD_MMC_D1_PIN 1
#define SD_MMC_D2_PIN 6    #define SD_MMC_D3_PIN 5
#define SD_MMC_CLK_PIN 3   #define SD_MMC_CMD_PIN 4
sdcard.h 用 esp_vfs_fat_sdmmc_mount() 挂到 /sdcard,会议结束时往 /sdcard/meetings/
写 .md 纪要、.txt 转写和 .wav 录音;录音来自 audio_service.h 新增的输入旁路
g_audio_input_tap,16kHz / 16bit / 单声道 PCM,攒够 4096 个采样批量落盘,结束时回填 44 字节 WAV 头。
第一次上电却是:
W (988) vfs_fat_sdmmc: failed to mount card (13)
W (1008) SdCard: mount attempt 1 (4-bit, 20000 kHz) failed: ESP_FAIL
(13) 不是 ESP 错误码,是 FatFs 的 FR_NO_FILESYSTEM。我加了 4-bit / 1-bit / 1-bit 降频三种
挂载重试(都失败,排除接线),并在全失败后重新初始化 SDMMC 读卡信息和扇区 0:
I (1168) SdCard: probe: card name=SD8GB serial=6504607 capacity=7600 MB
I (1178) SdCard: probe: LBA0[0..31]=00 00 00 00 ...
I (1188) SdCard: probe: boot sig=0xAA55, MBR p0 type=0x07
MBR 有效、卡也认得,但分区类型 0x07 说明这张卡是 exFAT,而 IDF 的 FatFs 默认
FF_FS_EXFAT = 0,于是找不到可挂载的 FAT 卷。改本机 SDK 打开 exFAT 会让工程无法复现,
所以正解是把卡格式化成 FAT32。
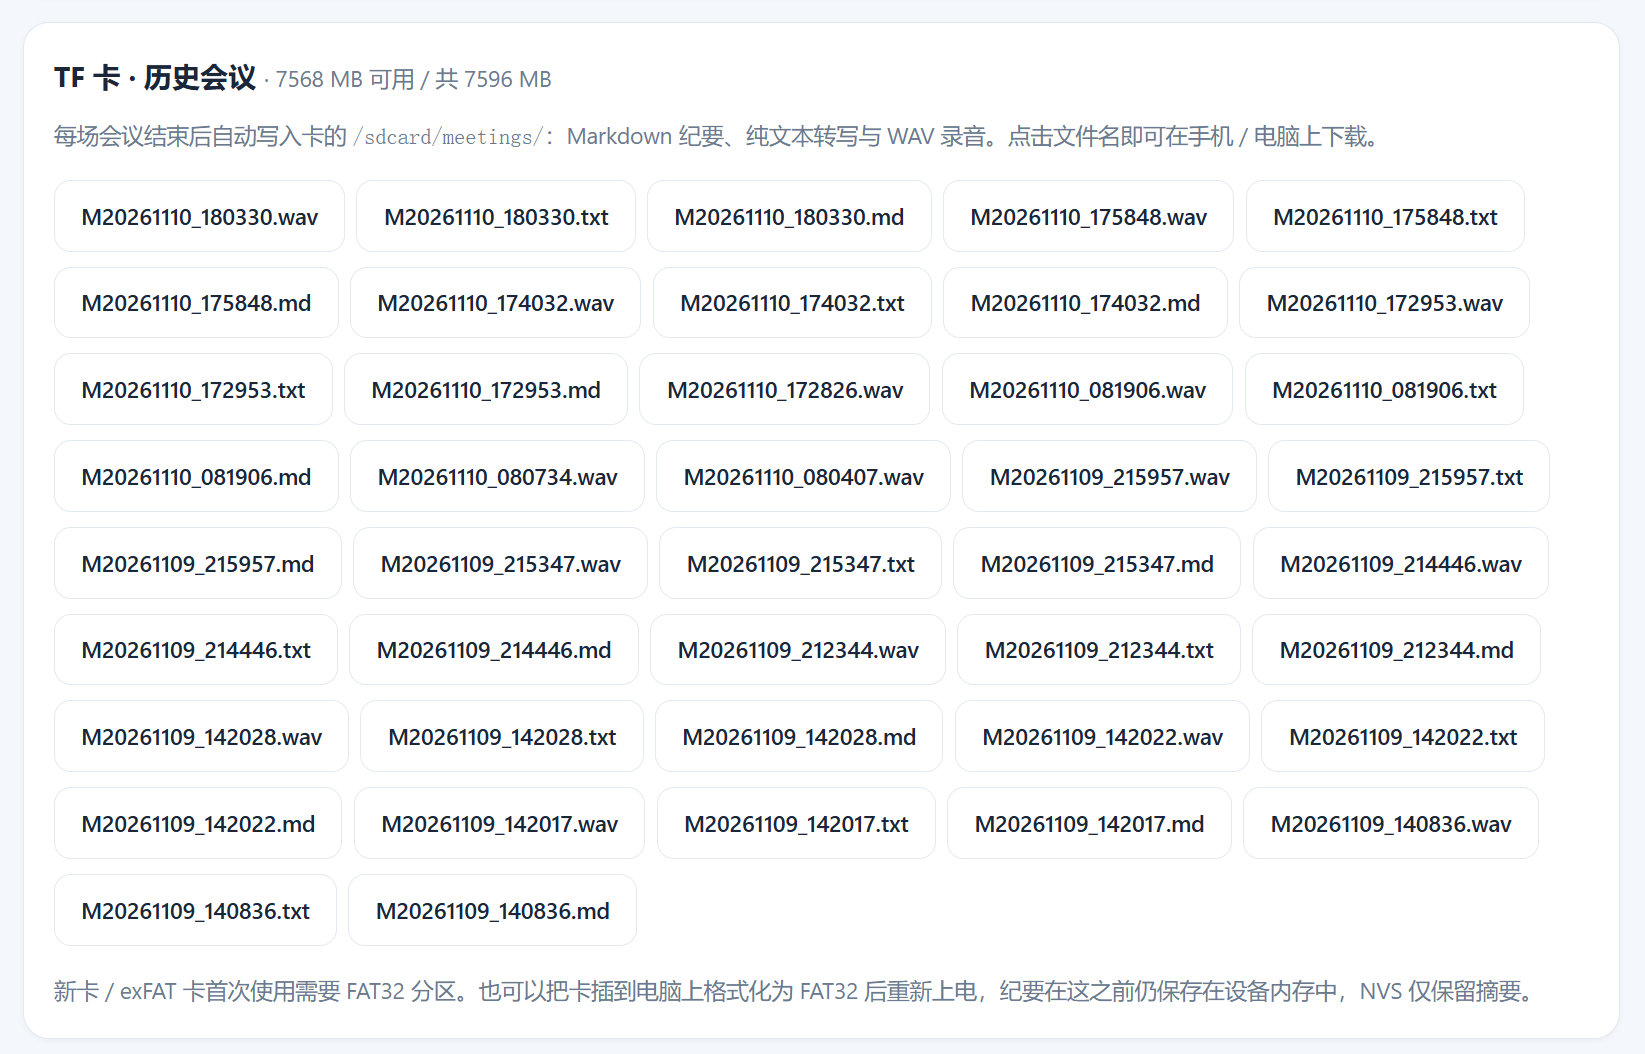
这里刻意没有开机自动格式化:那会悄悄抹掉卡上的资料。做法是网页「TF 卡 · 历史会议」
里放一个需两次确认的按钮,POST /api/sd/format 还要求请求体带
{"confirm":"FORMAT_MY_TF_CARD"} 才执行;不带令牌一律返回 400。确认后再以
format_if_mount_failed = true 重新挂载,由 IDF 完成分区 + 格式化:
W (144278) vfs_fat: formatting drive, allocation unit size=16384
W (151608) SdCard: TF card formatted and mounted: 7596 MB total
格式化后连续跑了三轮短会压测,网页 12 个文件全部可下载,Content-Length 与实际字节数一致,
WAV 头里的 data 长度与文件长度自洽:
M20261109_142028.wav   127404 bytes  wav=4.0s header_ok=True
M20261109_142028.txt       67 bytes  txt=(本次会议未识别到发言,请查看同名 .wav 录音)
M20261109_142028.md       701 bytes
顺带修掉三个只在「卡真的挂上之后」才暴露的问题:
- 偶发 assert 重启。
StartWav()原先在持有wav_mu_时调用ESP_LOGI,
日志要再拿 newlib 的 stdio 递归锁,触发
assert failed: xQueueSemaphoreTake queue.c:1713 (pxQueue->uxItemSize == 0)。
用xtensa-esp-elf-addr2line解出调用链后,把fopen/ESP_LOG/RefreshSpace()
都移出锁作用域,Web 任务栈从 8KB 提到 12KB,三轮压测再无崩溃。 - 下载有 4MB 上限。原先
/file/<name>把整个文件读进std::string,
长会 WAV 会被截断;改成 4KB 分块流式发送,内存占用与文件大小无关。 - 无发言时
.txt是空文件。现在写入一行说明,指向同名 WAV。
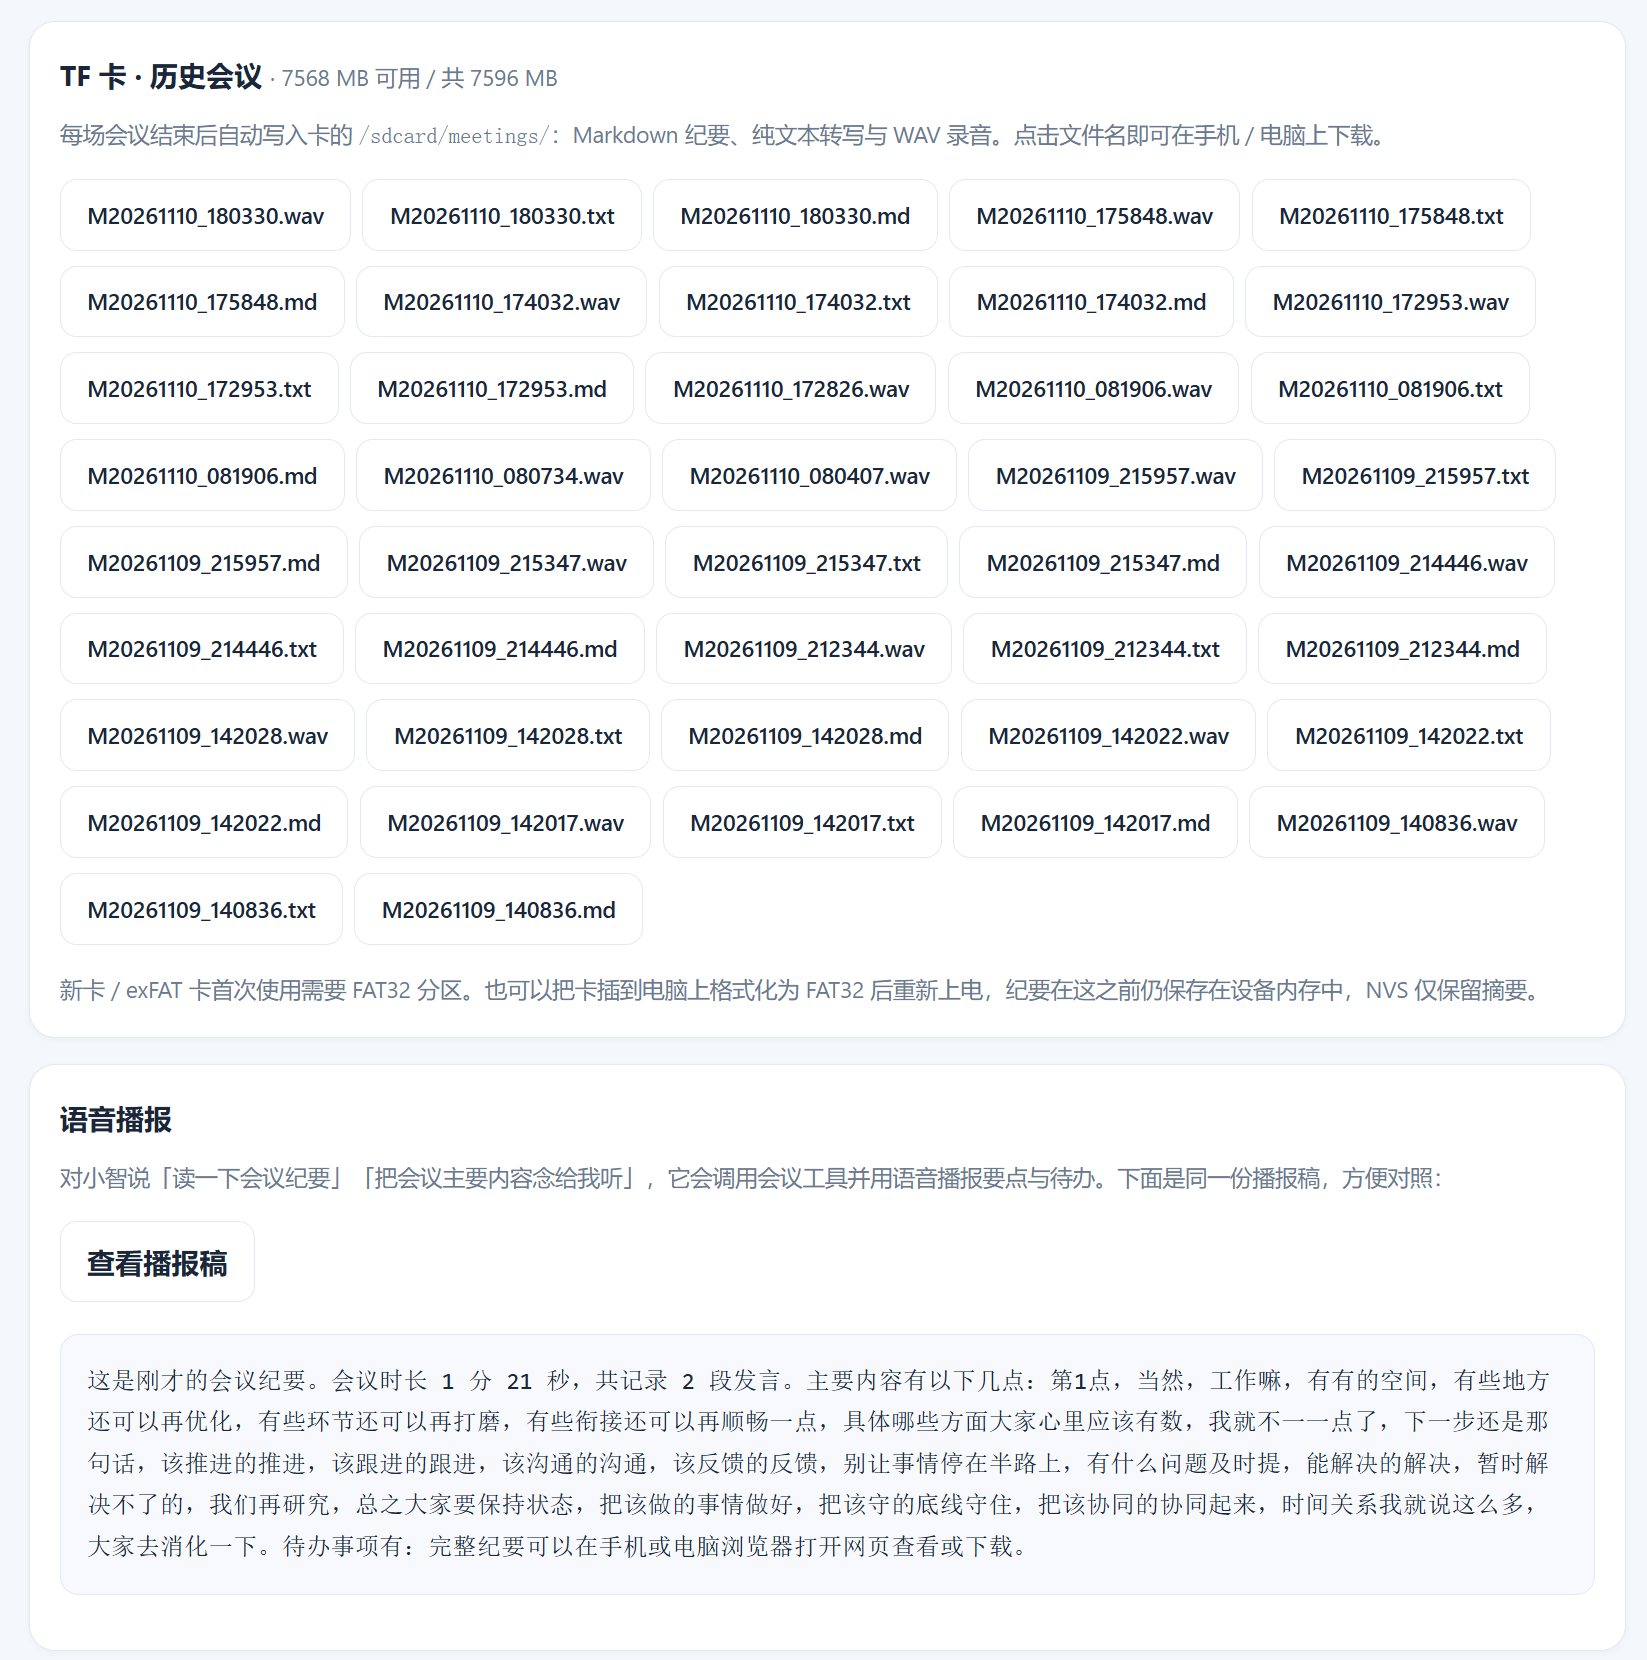
语音播报这一头也要说清边界:设备没有本地 TTS,self.meeting.report 只是把整理好的
纯中文播报稿作为 MCP 返回值交给云端大模型,由它调用 TTS 念出来;/api/report
返回同一份稿子方便在网页对照。断网时这条链路不可用,但纪要本身照常生成。
十二、固件与烧录
编译产物打包成 Espressif Flash Download Tool 能直接用的格式,两种方法等价,已做逐字节比对校验。
工具设置(关键):
| 项 | 值 |
|---|---|
| ChipType | ESP32-S3 |
| SPI SPEED | 80 MHz |
| SPI MODE | DIO |
| Flash Size | 16 MB |
| WorkMode / LoadMode | Develop / UART |
方式 A(推荐,只填一行):
merged/xiaozhi_dfr1221_16MB_merged.bin → 地址 0x0,文件 16,777,216 B(已按 16MB 全片补齐 0xFF)。
界面上有 DoNotChgBin 就勾上 —— 镜像头里已经写好 DIO / 80MHz / 16MB,不需要工具改写。
方式 B(5 个分分区文件):
| 地址 | 文件 | 大小 (B) | 内容 |
|---|---|---|---|
0x0 |
0x00000_bootloader.bin |
16,544 | 二级 bootloader |
0x8000 |
0x08000_partition-table.bin |
3,072 | 分区表 |
0xd000 |
0x0d000_ota_data_initial.bin |
8,192 | OTA 初始数据 |
0x20000 |
0x20000_xiaozhi_app.bin |
2,770,816 | 主程序(含会议纪要、单角色待机、TF 卡与语音播报) |
0x800000 |
0x800000_generated_assets.bin |
1,262,753 | 字体 / 表情 / 提示音资源 |
等价的 esptool 命令:
esptool.py --chip esp32s3 --port COM10 --baud 921600 \
  write_flash --flash_mode dio --flash_freq 80m --flash_size 16MB \
  0x0 merged/xiaozhi_dfr1221_16MB_merged.bin
整片 16MB 镜像会清空 NVS / WiFi 配网,烧完按小智标准流程重新配网;
只想升级程序时单独烧0x20000那一行,配网信息和已存纪要都不会丢。
合并镜像重建后校验结果:5 个偏移全部 match=True,未用区域全为 0xFF,
sha256.txt 覆盖 8 个文件;分发 zip 约 5.2 MB。
十三、实测数据与已知边界
| 验证项 | 结果 |
|---|---|
| 编译 | ESP-IDF v6.1,ninja 增量,零错误零警告,app 2,770,816 B(0x2a4780),分区剩余 33% |
| 烧录 | COM10 921600,Hash of data verified |
| 启动 | Meeting: meeting manager ready;MCP: 18 tools registered: 11 visible to the model |
| Web 服务 | MeetingWeb: meeting web UI at http://192.168.31.167:80/;Setting WiFi power save level: PERFORMANCE (NONE) |
| HTTP 接口 | /、/api/status(JSON 合法、15 字段)、/api/start、/api/stop、/api/minutes、/api/transcript、/download、/api/config 全部 200 |
| 端到端短会 | 网页开始 → 计时 → 停止 → 生成纪要;重启后 NVS 可读回 |
| 网络 | 关省电后 ping 3 |
| 长会话 | goodbye 后守卫自动重连,日志可见 re-arming → connecting → listening |
| 控制指令分类 | 11 组用例全部通过,含「会议」的真实长句不误伤 |
| 真人语音(修复前) | 开始 → MCP → 结束 → 生成 716 B 纪要,链路首尾已通;但 manual 模式下会议正文 0 条 |
| 逐句转写(修复后) | 三轮独立发声 → 3 条独立 stt → 纪要 3 条 / 200 字,时间戳连贯 |
| 回话打断 | 每句 listening -> speaking -> listening 约 0.9 秒,AI 半句不上屏 |
| 停止残留 | Stop() 后到达的 stt 被 drop late stt after meeting stop 丢弃,不触发闲聊 |
| 待机界面 | StandbyBadge: standby badge created (no clock dial);PetAvatar: 1 skin x 8 state GIFs |
| TF 卡 | exFAT 诊断出 MBR p0 type=0x07;确认格式化后 TF card ready: 7596 MB total / 7595 MB free |
| 写卡压测 | 连续 3 轮开始 / 停止,12 个文件全部写卡并下载,Content-Length 不一致 0 个,WAV 头全部自洽 |
| 稳定性 | 三轮压测无 assert failed / Guru / 重启;未确认的格式化请求返回 400 |
| 真人手指双击 | 12 分钟串口实录:170ms / 275ms 两次双击分别 START / STOP,坐标漂移 9~10px;录制中单击被忽略,双击仍可结束会议 |
| 真人手指长会 | 1 分 56 秒外放长语音 → 11 段逐句 stt → 纪要 1882 B → WAV 3,703,680 B,.md / .txt / .wav 三文件写卡 |
| 语音播报 | 「读一下会议纪要」→ self.meeting.report → 云端 TTS 念出时长 / 段数 / 要点 / 待办 / 网页提示,播报链路打通 |
已知边界:
- 手机 / 电脑必须与设备在同一局域网,没有公网穿透、邮件或微信推送;
- 转写依赖小智云端 ASR,断网时不能新增发言(已记录的仍可查看、导出);
- 服务端长会话会周期性 goodbye,自动重连期间约 1~2 秒语音可能丢失;
- 暂不区分说话人,发言按识别片段时间顺序排列;
- AI 精修需自备 API Key,网页配置的保存 / 清除已测,但未用真实 LLM 端点跑通;
- 每句转写后云端仍会生成 TTS 回复,打断需要约 0.9 秒,这段时间麦克风关闭,紧接的下一句开头可能被截;
- 服务端 VAD 需要一段静音才断句,连续抢话时可能合并成一条较长的转写;
- 早期版本在
StartWav()持锁打日志时偶发 assert 重启,已定位并修复(见第十一章),三轮压测未复现; - 已有 1 分 56 秒外放长语音(11 段转写)跑通完整流程,但真人多人抢话场景下的 VAD 合并率、漏句率仍未系统统计;
- WAV 是设备麦克风采集的连续 PCM,但每句
stt后 AI 回复打断的约 0.9 秒麦克风关闭,录音会有同样缺口; - TF 卡必须是 FAT32;exFAT 卡需确认后格式化,或自行在电脑上改格式。
十四、源码与资源
- 完整工程(含板型源码、会议纪要实现、构建配置):Gitee 仓库 yuntian365/xiaozhi-dfr1221
- 可直接烧录的固件:仓库
firmware/flash_download_tool/目录,或打包好的xiaozhi_dfr1221_flash_download_tool.zip(约 5.1 MB) - 本篇相关文件速查:
main/boards/dfrobot/df-s3-1.85-round/meeting.h— 转写累积、控制指令分类、结构化纪要、AI 精修、MCP 工具、NVS、5 秒会话守卫main/boards/dfrobot/df-s3-1.85-round/meeting_web.h— 裸 socket HTTP 服务与内嵌响应式页面main/boards/dfrobot/df-s3-1.85-round/df_s3_1_85_round.cc— 覆写SetChatMessage()截获stt、双击屏幕 / BOOT 切换录制、SetPowerSaveLevel()常唤醒main/boards/dfrobot/df-s3-1.85-round/sdcard.h— SDMMC 挂载、exFAT 诊断、格式化、WAV 写入与文件列表main/boards/dfrobot/df-s3-1.85-round/clock_face.h—ClockTimeSync校时 +StandbyBadge待机装饰(表盘已移除)main/boards/dfrobot/df-s3-1.85-round/pet_avatar.h/pet_assets.h— 单角色 8 状态 GIF 与口型驱动main/audio/audio_service.h/.cc— 默认关闭的g_audio_input_tap,会议录音旁路main/boards/dfrobot/df-s3-1.85-round/README.md— 板型详细文档、交互说明与验证记录firmware/flash_download_tool/— 合并镜像、分分区 bin、flash_args.txt、sha256.txt、烧录说明
- 仓库保留了
sdkconfig与dependencies.lock,克隆后无需重新 menuconfig 即可复现本次固件;
build/和managed_components/不入库。 - 仓库内不含任何 WiFi 账号、API Key 或账号口令。
实现上的一个取舍:
meeting.h/meeting_web.h和之前的reminder.h/pet_avatar.h/clock_face.h
一样刻意放在头文件里。板目录的*.cc由 CMake glob 收集,新增源文件会强制 CMake 重配置,
覆盖本机build.ninja里规避 Windows 32767 字符命令行上限的补丁。
用CMAKE_NINJA_FORCE_RESPONSE_FILE=ON重新配置过工程后,就可以拆成规范的.cc。
十五、总结与下一步
从「圆屏能聊天」到「圆屏能记会」,音频采集和协议帧格式一行没动,但也不是「复用现成能力」那么轻松。
真正卡住我的是 manual 与 auto 这一个词的语义差别:前者是对讲机,攒到最后才识别一次;
后者才是逐句听写。第一次实测的 0 条转写、以及那句「2 条 27 字」的空纪要,代价就是没早一点读懂它。
剩下花时间的是几件小事:想明白「结束会议」这句话该怎么被可靠地识别、
让双击屏幕不跟单击唤醒和滑动打架(以及后来发现真正作祟的是 LVGL 默认可点击对象吞掉了事件)、
在 AI 每句都想插嘴的情况下把麦克风占住,
以及最后把界面收敛成一台「看得出来是会议机」的设备、把 8GB TF 卡真正用起来。
最后这一轮还顺手抓到并修掉了一个只在卡挂载成功后才出现的 assert 重启 —— 这种问题不把硬件插上跑,是看不出来的。
接下来还想打磨几处:
- 用真人长会议实测,统计 VAD 断句的合并率与漏句率,再决定是否需要本地切段兜底;
- 把 WAV 与逐句转写按时间戳对齐,做「点某句发言跳到对应录音位置」的回放;
- 让语音播报在云端改写措辞时也能保持要点不丢,或提供本地 TTS 兜底;
- 给网页加上听写健康度(最近一条
stt距今多久、重连次数),开会时不用开串口也能判断是否正常; - 长会话 goodbye 做成更平滑的续接,尽量不丢那 1~2 秒;
- 说话人区分(哪怕只按声纹粗分「谁在说」),纪要可读性会再上一个台阶;
- 可选用大模型端点做本地要点重排,让不配 Key 的纪要也更接近成稿。
如果你也有一块 DFR1221,欢迎直接烧来试。烧坏了重烧 0x20000 就能回来,
也欢迎在评论区贴你跑出来的第一份纪要 —— 特别是你在真人会议里遇到的断句问题,
很想看看别的小智服务端在 VAD 上是什么脾气。
许可与致谢:本项目基于开源项目 xiaozhi-esp32,许可证沿用上游
LICENSE。
硬件资料参考 DFRobot 官方 Wiki、原理图与ST77916_LVGL_DEMO示例;板级适配的背景见本系列前一篇
《给 DFR1221 圆屏装上「小智 AI」》。
文中出现的角色形象均为程序化绘制的原创 Q 版设计,未使用任何第三方品牌素材,相关商标归各自权利人所有。