ChatCoding 防死机指南:ESP-Mosaico 480×480屏效开发的10大极简工程范式
标签:*ESP-Mosaico ChatCoding Lua沙箱 UI特效 代码规范 性能优化*
摘要:*当屏幕尺寸被固定、算力被锁定、内存被框死,再叠加"由 AI 逐轮生成代码"这一非常规的开发方式,工程约束的意义就不再只是"写得更整齐",而直接决定了这个项目能不能跑起来、能不能改得动。*
## 前言:三类痛点,一个解法方向
用 ChatCoding 做嵌入式屏效开发,踩的坑高度相似,基本可归为三类。
1、会话层面:上下文膨胀导致死锁。 屏效项目的特征是"反复微调"——改一版颜色、换个动效节奏、加一条轨迹。每一轮都在往会话里累积代码,几百轮之后历史体积触发压缩,压缩后仍然超限,会话直接卡在无法继续的状态。此时损失的不只是时间,而是整条可追溯的迭代记录。
2、代码层面:冗余度高,改一处崩全局。 AI 在缺乏约束时会倾向"补全式生成"——加抽象层、加配置框架、加通用容错。这些在服务端叫工程素养,在 480×480 的固件里就是负债。更麻烦的是结构一旦嵌套,第二次修改的定位成本会指数上升。
3、运行层面:资源边界不可控。 生成时在开发机上跑得好好的代码,烧进硬件开始掉帧、花屏、重启。原因是算力和内存的边界从未被显式声明过——没有人告诉生成器"只有 40ms 一帧""只有 512 个粒子"。
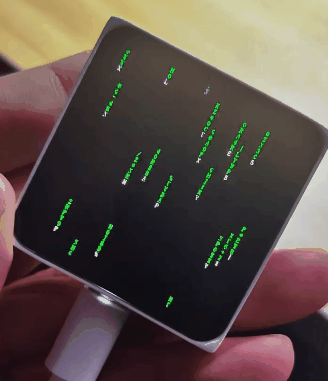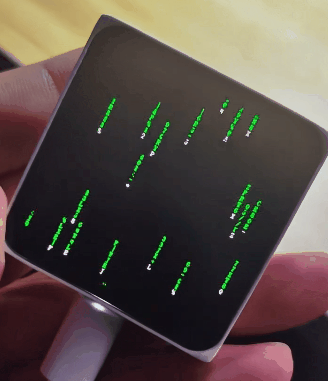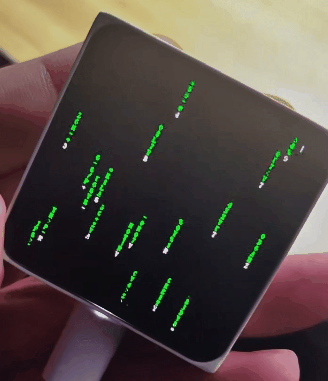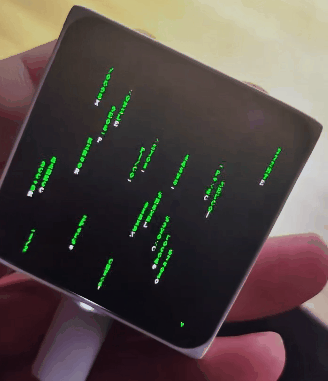
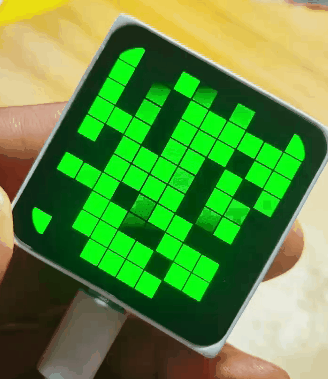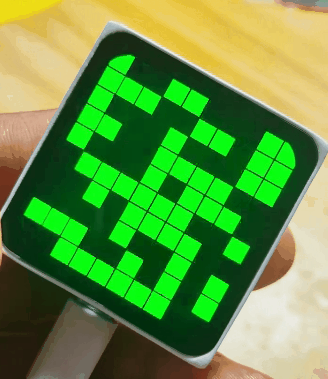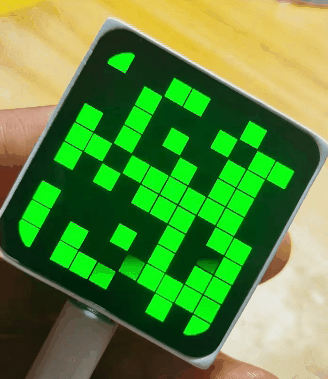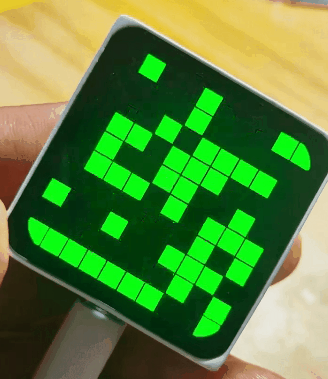
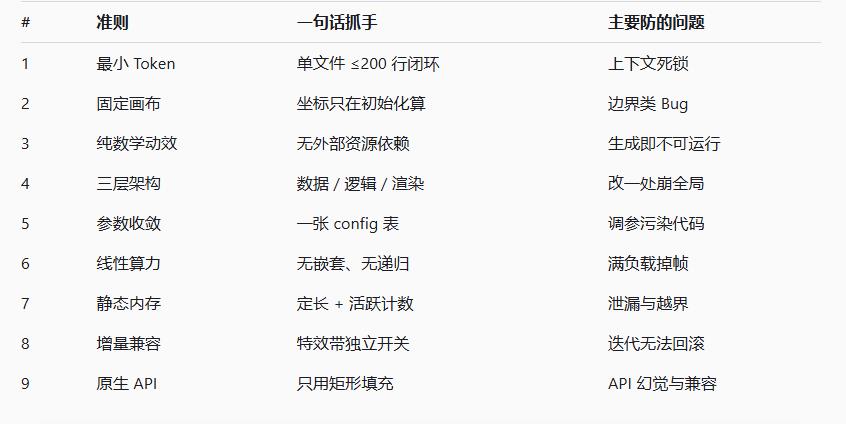
针对这三类问题,可以提炼出一套针对固定画布的极简工程范式。它不是通用编程规范,而是专门用来约束 AI 生成行为、同时把 480×480 画布的物理特性转成工程优势的一组规则。以下 10 条,适用于像素点阵、矩阵灯效、数学动效这类轻量屏效项目。
## 准则一:最小 Token 原则 —— 单功能代码体量刚性可控
核心内涵:以"用最少代码实现核心效果"为第一优先级,主动拒绝过度封装、冗余抽象与提前设计。
落地要点
核心逻辑走线性流程,不套用设计模式,不引入多层抽象
点阵、常量、坐标数据直接硬编码,不做多余的动态生成封装
单功能模块控制在 200 行以内,单文件完成完整闭环
为什么有效:这是所有准则的前置条件。代码体量直接决定生成准确率——约束越少、路径越短,模型偏离意图的空间就越小。同时它把会话 Token 的增量压在低位,从根源上避免"压缩后仍超限"的死锁。
注意边界:200 行是上限而非目标。真正要守的是"单文件闭环"这一条——跨文件的依赖关系才是增量修改最容易出错的地方。
## 准则二:固定画布约束 —— 全量坐标静态预计算
核心内涵:480×480 是常量而非变量。所有布局、网格、点阵坐标在初始化阶段一次算完,运行时零坐标换算。
落地要点
网格、矩阵、文字布局全部用固定像素值,不做百分比自适应、不做多分辨率兼容
点阵字模、图形顶点数据预计算后存入常量表,运行时只查表
居中与对齐规则一次计算生效,运行时不存在动态布局逻辑
为什么有效:分辨率适配是边界类 Bug 的最大来源——比例计算、取整偏差、越界裁切,每一个都能在长时间运行后暴露成画面撕裂。把画布当常量,等于一次性删掉整条分支逻辑。
注意边界:这条准则的代价是"不可移植"。这是刻意的取舍:轻量屏效项目追求的是特定硬件上的极致稳定,而不是跨设备通用性。两者不可兼得,需要主动选边。
## 准则三:纯数学驱动动效 —— 零外部资源的动态视觉
核心内涵:所有动态效果完全由基础数学函数生成,不依赖外部字体、图片、音频,全程代码内闭环。
落地要点
以正弦、线性插值、伪随机数、距离场作为动效原子
通过相位偏移与幅值调节,组合出呼吸、流动、聚散、波纹等经典效果
动效逻辑与渲染逻辑彻底分离,改节奏不影响绘制
为什么有效:外部资源引入的是"加载—解码—缓存"整条链路,每一环在嵌入式环境里都是潜在失败点,且 AI 生成时无法验证资源是否真实存在。纯数学方案没有路径依赖,生成即可运行,可移植性也最强。
注意边界:三角函数在嵌入式上没有硬件加速,sin/cos 应预先做成 512 项查表,热路径只做查表与插值。这一条不做,前面所有性能承诺都会失效。
## 准则四:三层极简架构 —— 数据 / 逻辑 / 渲染的解耦范式
核心内涵:强制采用"数据层—逻辑层—渲染层"三层扁平结构,拒绝更深的嵌套。
落地要点
数据层:点阵、常量、配置参数,不含任何业务逻辑
逻辑层:动效计算与状态更新,不触碰任何绘图 API
渲染层:纯绘制,只依据数据层与逻辑层的结果输出画面
为什么有效:这三层的划分恰好对应三类修改需求——换文字改数据层、调动效改逻辑层、加特效改渲染层。AI 做增量修改时,"改哪一层"是被结构强制约束的,单次修改的影响面天然可控,改崩全局的概率大幅下降。
注意边界:三层是上限,不是模板。三五十行的小 Demo 强行分三层反而增加阅读成本,此时把层级降为注释分段即可——扁平是目的,分层只是手段。
## 准则五:参数单点收敛 —— 全配置化的热更新设计
核心内涵:所有可调参数统一收敛到一张全局 config 表,附默认值与钳位范围,调参不碰核心代码。
落地要点
速度、颜色、尺寸、周期等可调项全部集中管理
每项明确默认值、最小值、最大值,越界自动钳位
支持外部热更新,不必重传全量代码即可调整效果
为什么有效:调参是屏效开发里频次最高的动作,也是最容易污染代码的动作——参数一旦散落在各处,每次微调都要通读全文。收敛到一张表后,调参退化成一次字段赋值,生成精度和调试效率同时提升。
注意边界:并非所有参数都适合外放。分辨率、缓冲尺寸、网格边长属于重建类参数,热改会导致缓冲与实际尺寸错配,进而越界写入。这类参数应保持为编译期常量,只对手感类参数开放下发。
## 准则六:线性算力承诺 —— O(n) 复杂度的性能边界
核心内涵:核心算法严格控制在线性时间复杂度,禁止嵌套循环、递归、实时排序等高开销结构,单帧算力完全可预测。
落地要点
单帧遍历次数与元素数量成正比,不存在指数增长路径
网格与粒子更新统一为单次全量遍历,不做多轮迭代至收敛
特效升级只增加单元素计算量,不改变基础复杂度
为什么有效:嵌入式开发最典型的翻车方式是"生成时流畅、满负载就卡"——因为没人在提示里声明过时间预算。约束复杂度等价于把性能风险前置到设计阶段,帧率稳定性在写第一行代码时就可以预判。
注意边界:物理松弛、沙堆稳定化这类逻辑天然倾向写成"循环直到稳定",必须改成固定迭代次数,超出上限即接受当前状态。视觉上几乎看不出差异,但主循环不会被卡死。
## 准则七:静态内存模型 —— 固定长度数组的零波动设计
核心内涵:完全静态的内存模型。所有数组与表格在初始化时定长,运行期无动态插入、删除、扩容。
落地要点
像素点、网格单元、粒子数组一律定长,上限硬编码
状态更新用标记法,不在遍历过程中改变数组长度
禁止运行时动态创建对象,把 GC 压力压到最低
为什么有效:内存相关的崩溃点——泄漏、越界、索引错乱、分配失败返回 nil——几乎全部源于"长度可变"。改成定长加活跃计数器之后,这一类崩溃从根上消失,长时间运行的稳定性显著提升。
注意边界:定长不等于不用。所有写回缓冲的下标在写入前仍需钳制到合法区间,因为定长只保证了"表存在",不能保证"索引正确"。
## 准则八:增量迭代兼容 —— 模块化叠加的升级路径
核心内涵:所有特效采用可插拔设计,支持逐个叠加、独立开关,升级过程不需要重构底层。
落地要点
每个特效对应独立的开关参数与渲染分支,默认关闭
新增效果只在渲染层做叠加,不修改原有核心逻辑
效果异常时用参数一键关闭,快速回退到稳定版本
为什么有效:这条直接对应 ChatCoding 的渐进式开发节奏——基础版跑通、加特效、再调细节。每一步的风险可控,回滚成本极低:出问题时关掉开关即可,不需要回退代码版本。
注意边界:叠加必须共享同一份基础设施工(调色板、查找表、缓冲),而不是每个特效自带一套。否则"可插拔"会演变成内存占用翻倍。
## 准则九:原生 API 优先 —— 最小依赖的渲染策略
核心内涵:只用平台原生的基础绘图能力(矩形填充、纯色绘制),不调用复杂图形、矢量字体、位图加载等扩展接口。
落地要点
文字与图形全部由基础矩形像素拼接实现
颜色与透明度直接用原生支持的格式,不自建色彩空间
规避路径绘制、抗锯齿、渐变等重渲染操作
为什么有效:依赖越少,生成代码的可运行率越高。扩展接口最容易出现的情况是"AI 编造了一个看起来合理但实际不存在的 API",而基础矩形填充这类原语的语义足够简单,几乎不会生成错误。同时它也天然规避了跨版本迁移的兼容问题。
注意边界:逐矩形绘制在 480×480 上开销不小。同样的颜色连续像素应按行合并成色段再提交,把几百次调用压到十几次——这是能否跑满帧率的关键一步优化。
## 准则十:内置兜底机制 —— 可观测可降级的鲁棒设计
核心内涵:代码自带基础观测能力与降级逻辑,无需额外调试工具即可定位问题,极端场景自动降级保底。
落地要点
内置帧耗时统计与运行时长计数,直观反馈性能状态
连续低帧率时自动关闭非核心特效,保证基础画面流畅
数值异常与边界越界自动钳位,不触发运行时错误
为什么有效:硬件调试的成本远高于桌面,能把"在设备上反复试探"变成"看屏幕上的自检指标",排查时间可以压缩数倍。降级逻辑则保证最坏情况仍然可用——画面变简单,但不会黑屏、不会重启。
注意边界:降级要有明确优先级顺序(先减粒子、再降迭代、最后降刷新率),且不允许跳过安全校验。无限降级到零帧和崩溃是同一个结果。
## 十条准则速查表
## 一个最小骨架
把上面十条压进一份不到三十行的结构里,形态大致如此:
lua

-- ① 参数单点收敛 + 范围钳位
local
CFG = {
 speed  = {v =
1.0, min = 0.1, max = 4.0
},
 hue    = {v =
32,  min = 0,   max = 255
},
 glow   = {v =
0,   min = 0,   max = 1},   -- ⑧ 特效默认关闭
}
-- ② 固定画布:坐标一次算完
local W, H = 480, 480
local CX, CY = W >> 1, H >> 1
-- ⑦ 静态内存:定长预分配
local MAX_P = 512
local
px, py = {}, {}
for i = 1, MAX_P do px[i], py[i] = 0, 0 end
-- ③ 纯数学:正弦查表,热路径不调 math.sin
local
SIN = {}
for i = 0, 511 do SIN[i] = math.sin(i * 2 * math.pi / 512) end
local function clamp(v, lo, hi)
 if v ~= v then return lo end            -- NaN 兜底
 if v < lo then return lo end
 if v > hi then return hi end
 return
v
end
-- ④ 逻辑层:不碰绘图 API
local function update(t)
 for i = 1, MAX_P do
   local a = (i * 11 + t * CFG.speed.v) % 512
   px[i] = clamp(CX + SIN[
math.floor(a)] * 200, 0, W - 1
)
   py[i] = clamp(CY + SIN[
math.floor(a) * 3 % 512] * 200, 0, H - 1
)
 end
end
-- ④ 渲染层:只输出画面(⑨ 原生矩形,按需合并色段)
local function draw()
 fw.clear(
0
)
 for i = 1, MAX_P do
   fw.rect(px[i], py[i],
1, 1, CFG.hue.v)   -- ⑥ O(n) 单次遍历
 end
end
-- ⑩ 兜底:帧耗时自检 + 分级降级
function on_frame(dt, t)
 local
t0 = fw.millis()
 update(t)
 draw()
 if fw.millis() - t0 > 40 then
   CFG.glow.v =
0                          -- 先关非核心特效
 end
end
这份骨架的价值不在功能,而在结构:每一条准则都能在几行代码里找到对应位置。后续所有增量修改,都应该落在这个既有骨架的某个格子里,而不是另起一层。
## 适用场景与取舍
这十条准则的共同目标只有一个:在 AI 生成的效率优势与嵌入式的资源铁幕之间,找到那个能长期维持的平衡点。
它们最适配的场景是:固定分辨率的嵌入式屏效开发、创客原型快速验证、点阵与像素风格视觉 Demo、数学动效类作品。这些场景共享同一个特征——画布小、资源紧、迭代频,恰好是"严格约束"收益最大的地方。
反过来说,这套范式并不适合需要多分辨率适配、需要复杂布局系统、或需要与大量第三方库协作的项目。准则二和准则九在那类场景里会变成束缚,而不是护栏。
真正的工程判断在于:先确认你的项目属于哪一类,再决定要不要接受这些约束。 一旦决定接受,就守到底——半套约束带来的复杂度,往往比完全不加约束更难收拾。