ESP-Mosaico Claw 11个 LLM 后端横向对比:基于硬件Agent闭环的实测选型指南
标签:*ESP-Mosaico、ESP-Claw、ChatCoding、LLM 选型、硬件 Agent、Token 计费、Vibe Mode*
## 导读
很多玩 ESP-Mosaico ChatCoding 的创客都会踩同一个坑:直接选旗舰大模型,简单调试几个 Demo,Token 费用就快速失控。
ESP-Mosaico Claw 不是普通代码 Copilot,它是一套**带硬件在环反馈的常驻 Agent 闭环**,自动探测、日志读取、报错重试机制,会持续触发 LLM 调用,成本逻辑和普通 AI 代码工具完全不一样。
这里结合 DeepSeek V4-Pro 真实计费账单,先拆解 Claw 本身的优势与固有短板,再横向对比面板内置 11 款 LLM 后端在国内环境下的适配能力,给出基于硬件 Agent 特性的分层选型方案,而不是只看模型跑分。
## 一、前置认知:ESP-Mosaico Claw 的机制、优势与先天短板
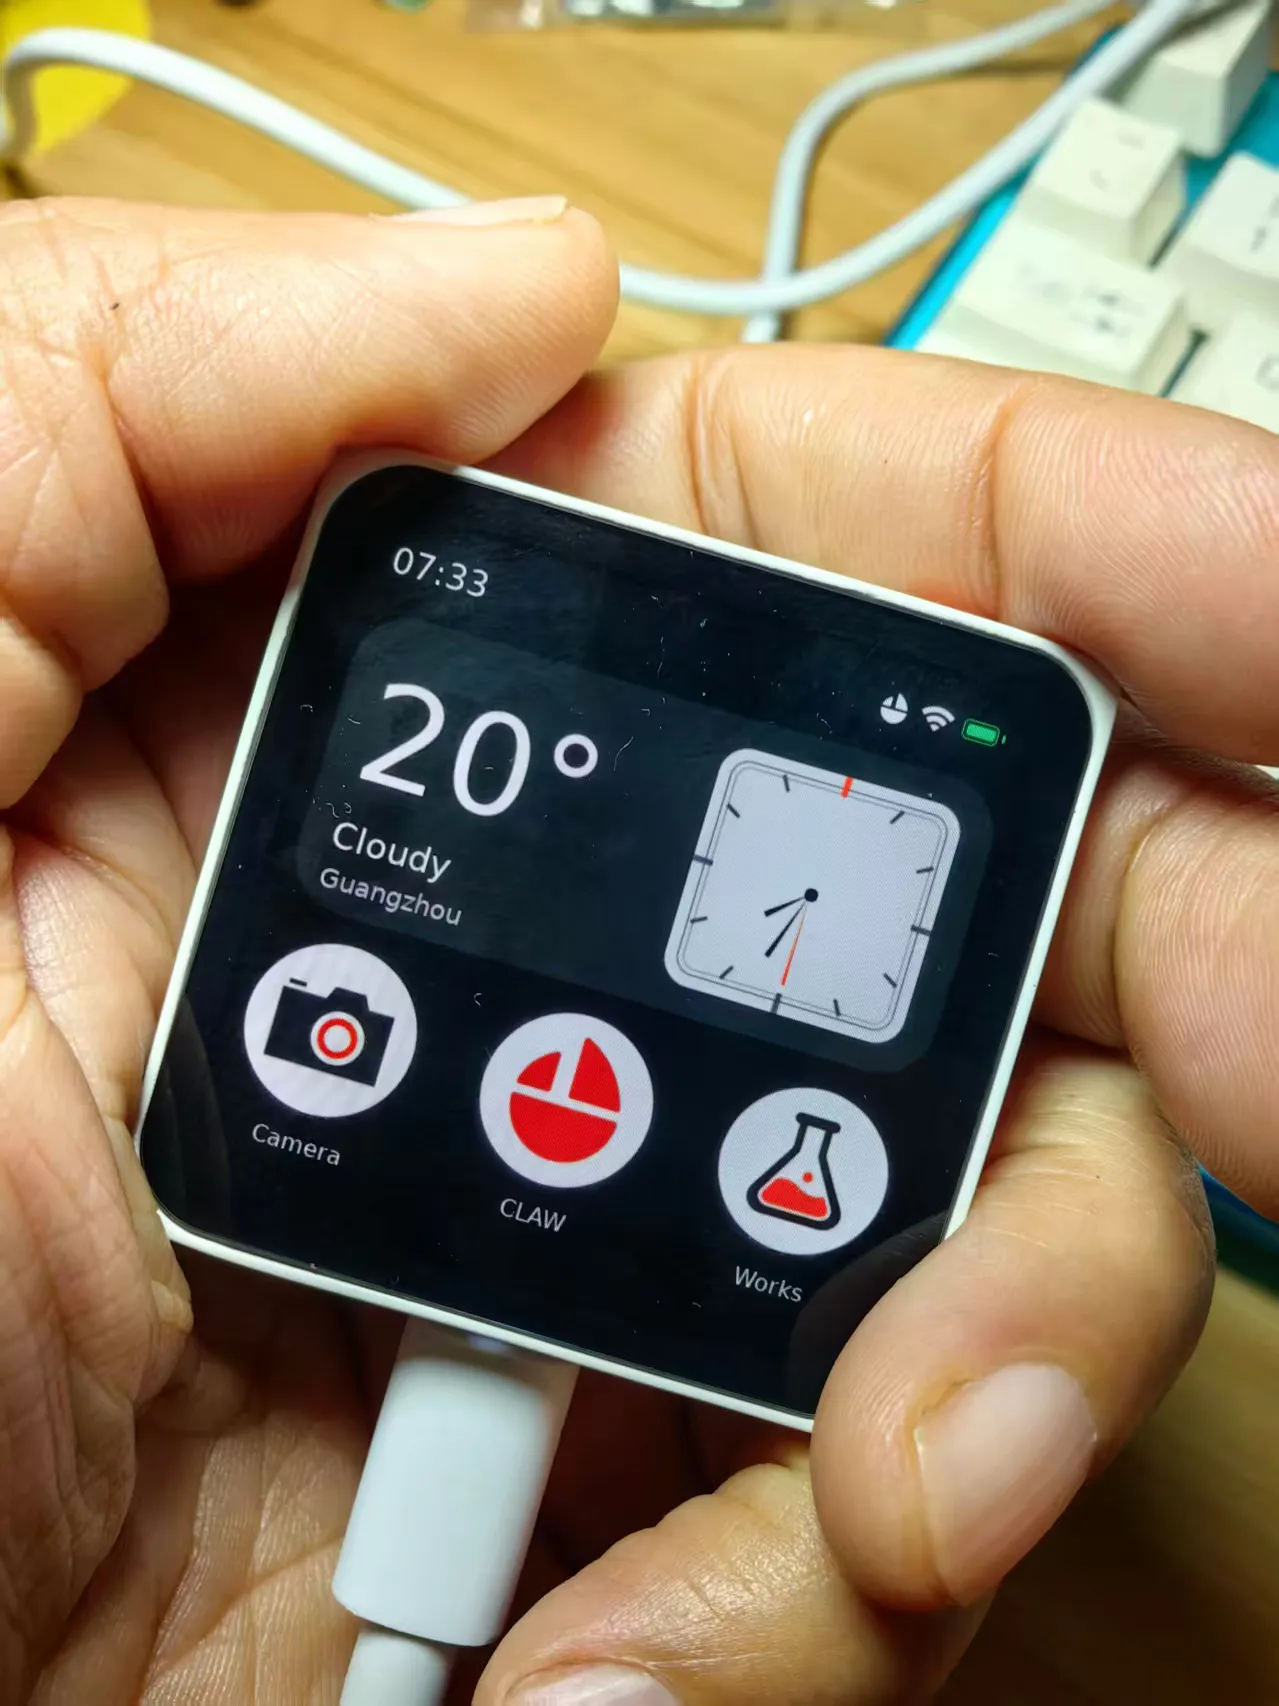
选型踩坑的根源,大多是忽略了 Claw 和普通代码助手的本质差异。普通代码助手:单次提问、单次返回代码,会话结束;Claw 运行在 Vibe Mode 底座之上,是面向硬件的自动化 Agent。
### Claw 的核心优势(决定了它对 LLM 的特殊要求)
1. **硬件在环(HIL)多轮闭环**
下发脚本后不会断开会话,主动读取设备日志、捕获 ESP 底层错误码、判断外设资源冲突、校验渲染结果,自动生成探测、修复、降级脚本。**一次用户需求,会自动拆成多轮 LLM 调用**。这是 ChatCoding 的核心价值,也是 Token 消耗最主要来源。
2. **硬件上下文感知**
自带磁吸模块识别、屏幕参数、I2C 总线状态、WiFi 状态、板载 Lua 库清单,LLM 需要理解 Mosaico 专属 Lua API、嵌入式报错码,而不是通用 Python 代码。
3. **IM 远程双向交互通道**
支持微信 / 飞书远程下发指令,日志、报错、运行结果原路回传 IM;LLM 同时要承接口语化需求、解读专业报错、输出简洁可执行脚本。
4. **沙箱隔离 + 硬件资源调度**
自动处理屏幕独占、外设互斥、任务启停,LLM 输出脚本必须符合 Lua 沙箱约束,不能生成阻塞、越界的危险代码。
### Claw 先天短板(选型时必须规避的风险)
1. **自动重试机制,放大模型成本缺陷**
LLM 输出代码存在 bug 时,Agent 会自动循环探测、重试排错。高单价模型,会让单次错误的调用成本指数级放大。这就是本次账单 Token 暴涨的底层原因。
2. **对输出格式稳定性要求极高**
Agent 需要自动提取 Lua 脚本、解析控制指令。如果模型发散、大段冗余文字、代码块格式混乱,会造成解析失败,触发新一轮重试,额外消耗 Token。
3. **上下文持续累积的开销压力**
Agent 会携带历史脚本、硬件日志、报错记录,上下文持续叠加;但 ChatCoding 轻量任务本身不需要超大长上下文,盲目选用超长上下文模型,只会持续增加输入 Token 开销。
4. **板端直连,网络链路敏感**
是开发板主动发起 API 请求,而非电脑中转。LLM 后端延迟、丢包、防火墙拦截,会被 Agent 误判为硬件故障,触发大量无效重试,浪费额度。
> 选型底层原则:
> 给 Claw 挑选 LLM,优先看:**输出稳定、嵌入式 Lua 理解强、单 Token 单价低、国内网络稳定**;而不是优先看通用推理、长上下文、多模态能力。
> 旗舰强模型适合人工控制轮次的重型工程;自动 Agent 闭环场景,会放大昂贵模型的缺陷。
## 二、实测账单复盘:为什么 V4-Pro 在 ChatCoding 场景水土不服
> 配图:DeepSeek 用量账单截图
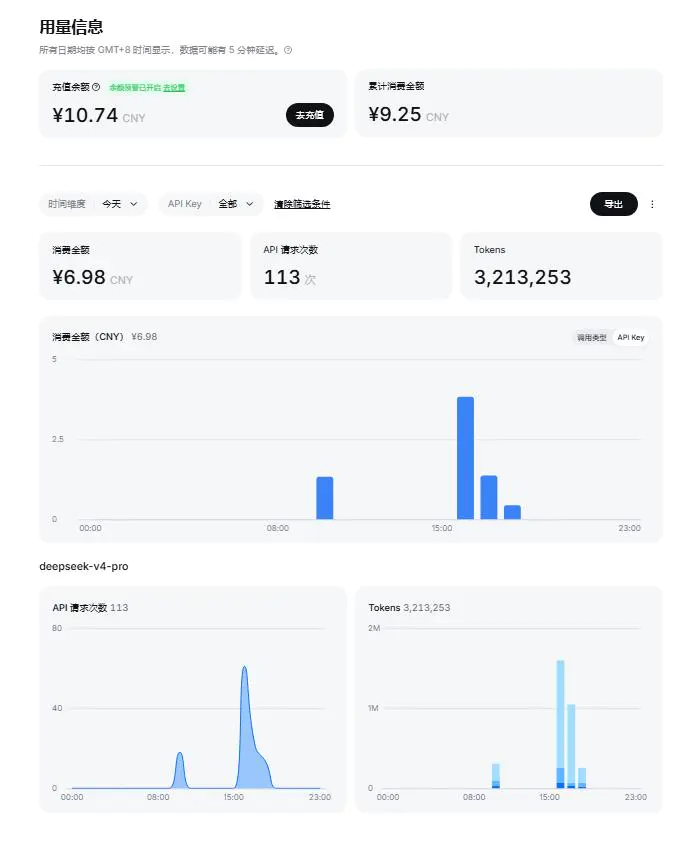
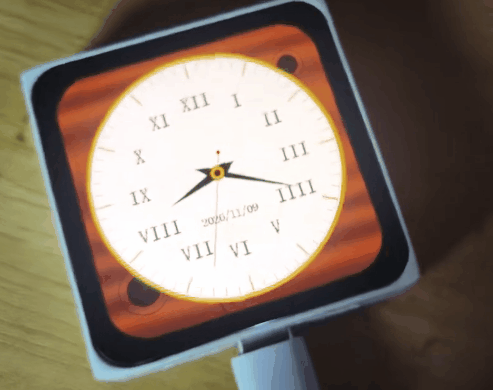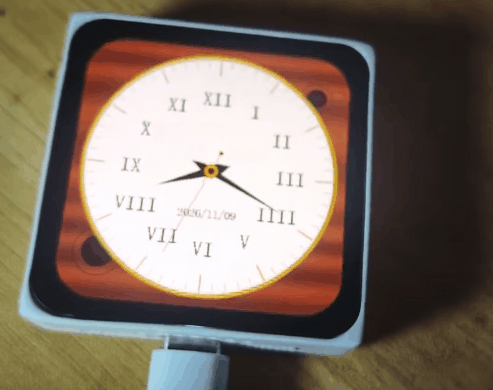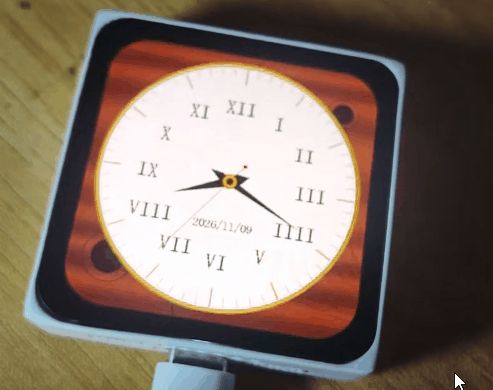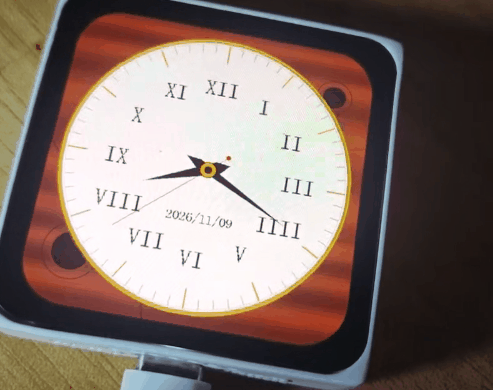
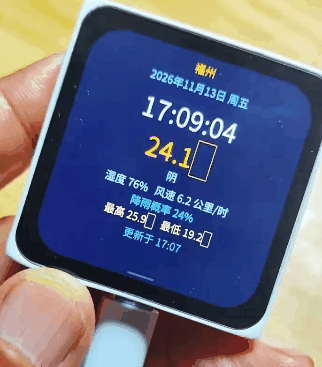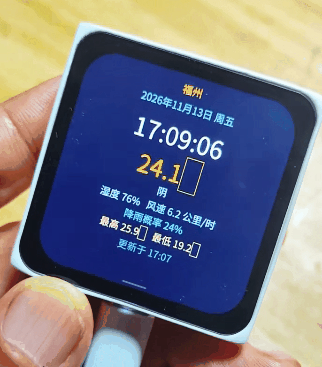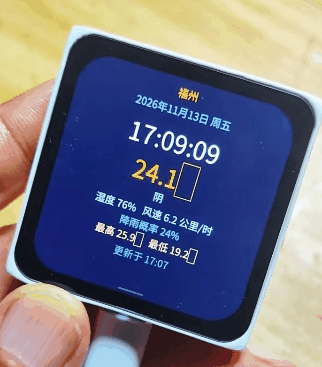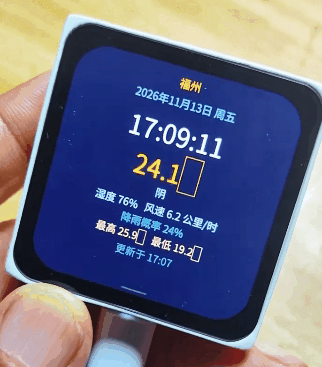
> 图注:DeepSeek V4-Pro 单日实测账单,113 次请求,消耗 3213253 Token,单日消费 6.98 元,测试场景:日月动画与天气时钟等轻量 Demo 调试
本次调试全部属于 ChatCoding 优势区间:单屏 UI 绘制、传感器读取、简单网络请求,**没有 ESP-IDF 底层开发、没有复杂算法**。
- 表象:用户发起 113 次对话请求
- 底层:Agent 自动拆分多轮调用,包含硬件探测脚本、日志解读、报错分析、增量修改、状态巡检,实际 LLM 调用轮次远多于用户手动消息。
DeepSeek V4-Pro 的强项是长文本推理、大型工程重构、深度逻辑推演,更匹配 VibeCoding(电脑端 Agent 操作 ESP-IDF 工程)。
放到 ChatCoding 自动闭环里,短板被持续放大:
1. 单价高,每一轮自动重试、每一次日志解读都带来更高成本;
2. 能力过剩,简单 Lua 脚本生成任务,不需要重型推理能力;
3. 输出偏向详细长文本,附带大量无关说明,拉高输出 Token。
> 场景边界划分
> DeepSeek V4-Pro:VibeCoding、ESP-IDF 大型工程重构、复杂硬件故障深度根因分析(人工管控轮次)
> DeepSeek V4-Flash:ChatCoding、IM 远程调试、轻量 Demo、自动闭环场景(Agent 自主多轮调用)
说明:还不确定DeepSeek V4-Flash是否能用,仅为分析
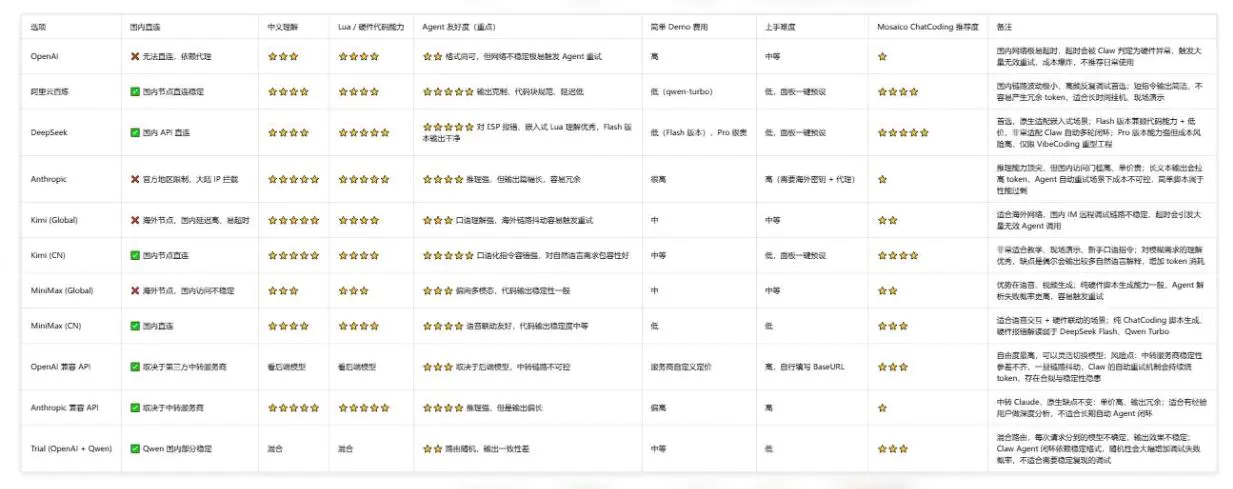
## 三、面板 11 款 LLM 后端|国内环境综合适配对比(结合 Claw Agent 特性)
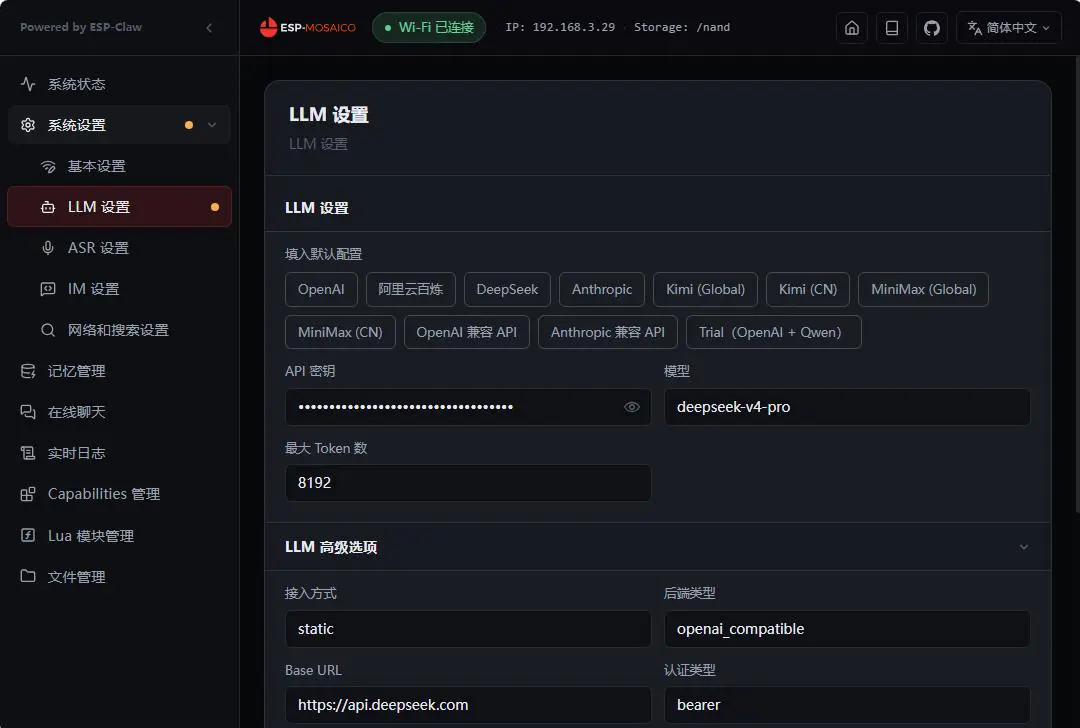
评估维度增加**Agent 友好度**,重点考核:输出稳定性、代码格式一致性、嵌入式报错理解、网络延迟、重试成本风险。
## 四、分层选型策略:按使用场景匹配模型,而不是单纯看模型强弱
结合 Claw 的 Agent 闭环特性,把创客日常使用场景分为 4 类,给出清晰选型方案:
1. **场景 1:日常主力 ChatCoding、IM 远程调试、高频 Demo 迭代(绝大多数创客)**
推荐:DeepSeek V4-Flash
理由:嵌入式代码、ESP 报错解读能力第一梯队;输出简洁,冗余文本少;国内直连稳定;单 Token 成本低。面对 Agent 自动多轮巡检、重试,成本可控,综合均衡。
2. **场景 2:教学演示、新手体验、大量口语化模糊指令**
推荐:Kimi (CN)
理由:中文口语理解能力最强,对不严谨的自然语言指令容错高,适合现场演示一句话控制硬件;降低新手上手门槛。
代价:同等任务 Token 消耗略高于 Flash、Qwen,不适合长时间不间断自动调试。
3. **场景 3:长时间挂机、自动化 HIL 测试、对网络稳定性要求极高**
推荐:阿里云百炼 qwen-turbo
理由:国内阿里云节点,抖动、丢包、拦截概率最低;输出克制,代码块规整,Agent 解析成功率高,无效重试最少。适合 7×24 小时 IM 远程硬件测试。
4. **场景 4:重型底层开发(VibeCoding,电脑端控制 ESP-IDF 工程)**
推荐:DeepSeek V4-Pro、Anthropic
理由:调用轮次由开发者手动控制,不会无限制自动重试;需要深度代码重构、复杂底层逻辑推演,旗舰模型优势才能发挥出来。
## 五、进阶调优:不止换模型,从机制上减少 Token 浪费
选对模型只是第一步,结合 Claw 本身的弱点,配套优化策略,进一步控制开销:
1. 合理设置 LLM 最大输出 Token 上限,ChatCoding 的 Lua 脚本大多简短,限制上限可以抑制模型输出大段无关解释;
2. 严格区分两套调试范式:Flash/Kimi CN 用于快速原型演示;阿里云百炼用于长时间自动化 HIL 测试;**禁止用 Pro 模型跑自动闭环**;
3. 尽量避开海外模型:哪怕偶尔连通,链路抖动带来的超时,会触发 Agent 大量无效重试;
4. 在全局提示词增加格式约束:优先输出 Lua 代码,减少多余文字说明,提升 Agent 自动解析成功率;
5. 定期新建会话:避免历史日志、脚本持续堆积,上下文无限膨胀抬高输入 Token。
## 六、总结
ESP-Mosaico Claw 这套体系的核心矛盾,是**自动多轮 Agent 闭环**和**大模型调用成本**之间的平衡。
普通 AI 代码工具,模型越强越好;但 Claw 自带硬件在环、自动探测、重试巡检的闭环机制,会持续发起 LLM 调用,把模型单价高、输出不稳定、网络差的缺陷持续放大。
选型逻辑的核心,跳出 “模型越强越好” 的误区:轻量 ChatCoding 自动闭环,优先稳定、低成本、懂嵌入式 Lua 的轻量化模型;只有 VibeCoding 重型工程开发,才适合启用旗舰推理模型。
结合本次量化账单的真实消耗数据,再匹配自身的网络环境、调试目标,才能稳定、低成本玩转 ESP-Mosaico 硬件 Agent 开发。