花雕动手做|榨干屏幕底裤的极限拉扯:ChatCoding 手搓“频域示波器”与毫秒级性能调优实录
博客标签:*ESP-Mosaico ChatCoding 性能调优 图形渲染 SPI带宽 底层排障*
## 导读:一场由“544个小矩形”引发的血案
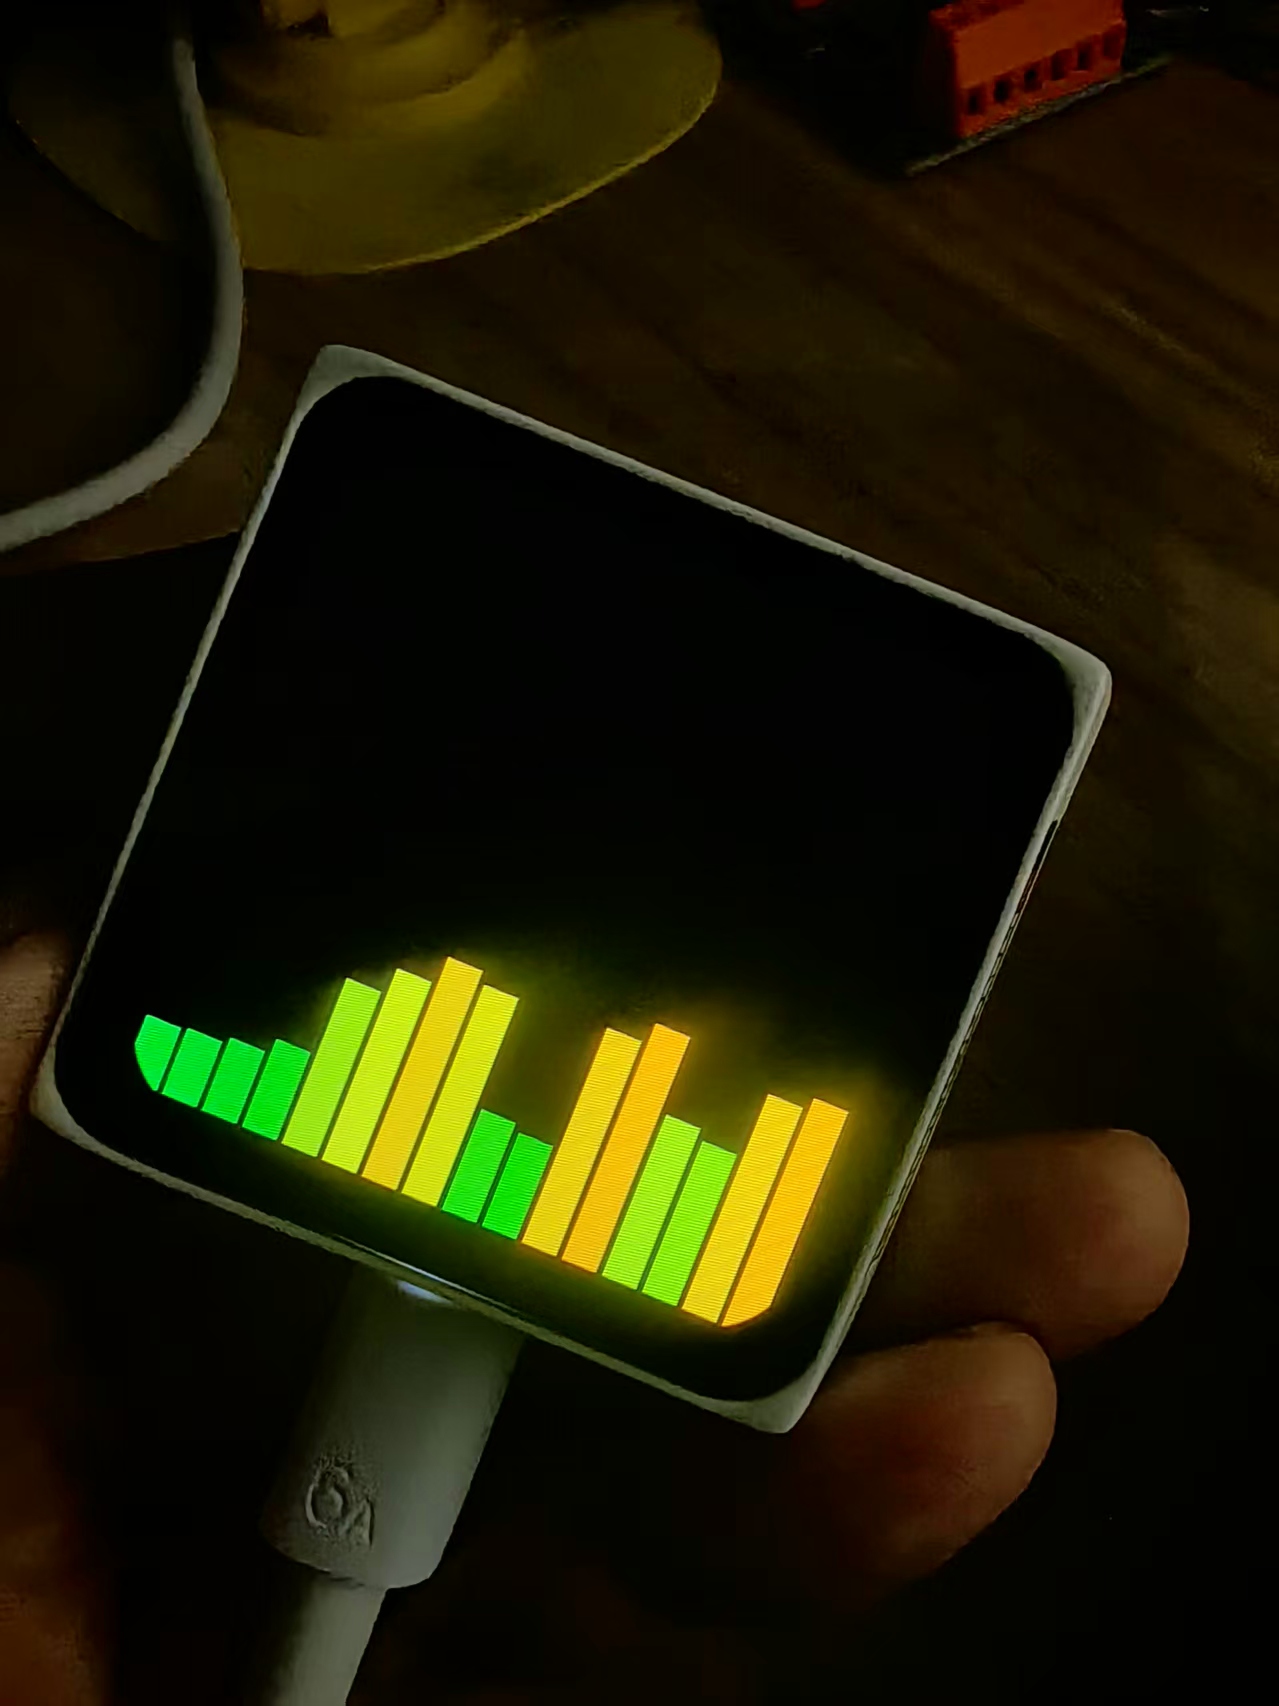
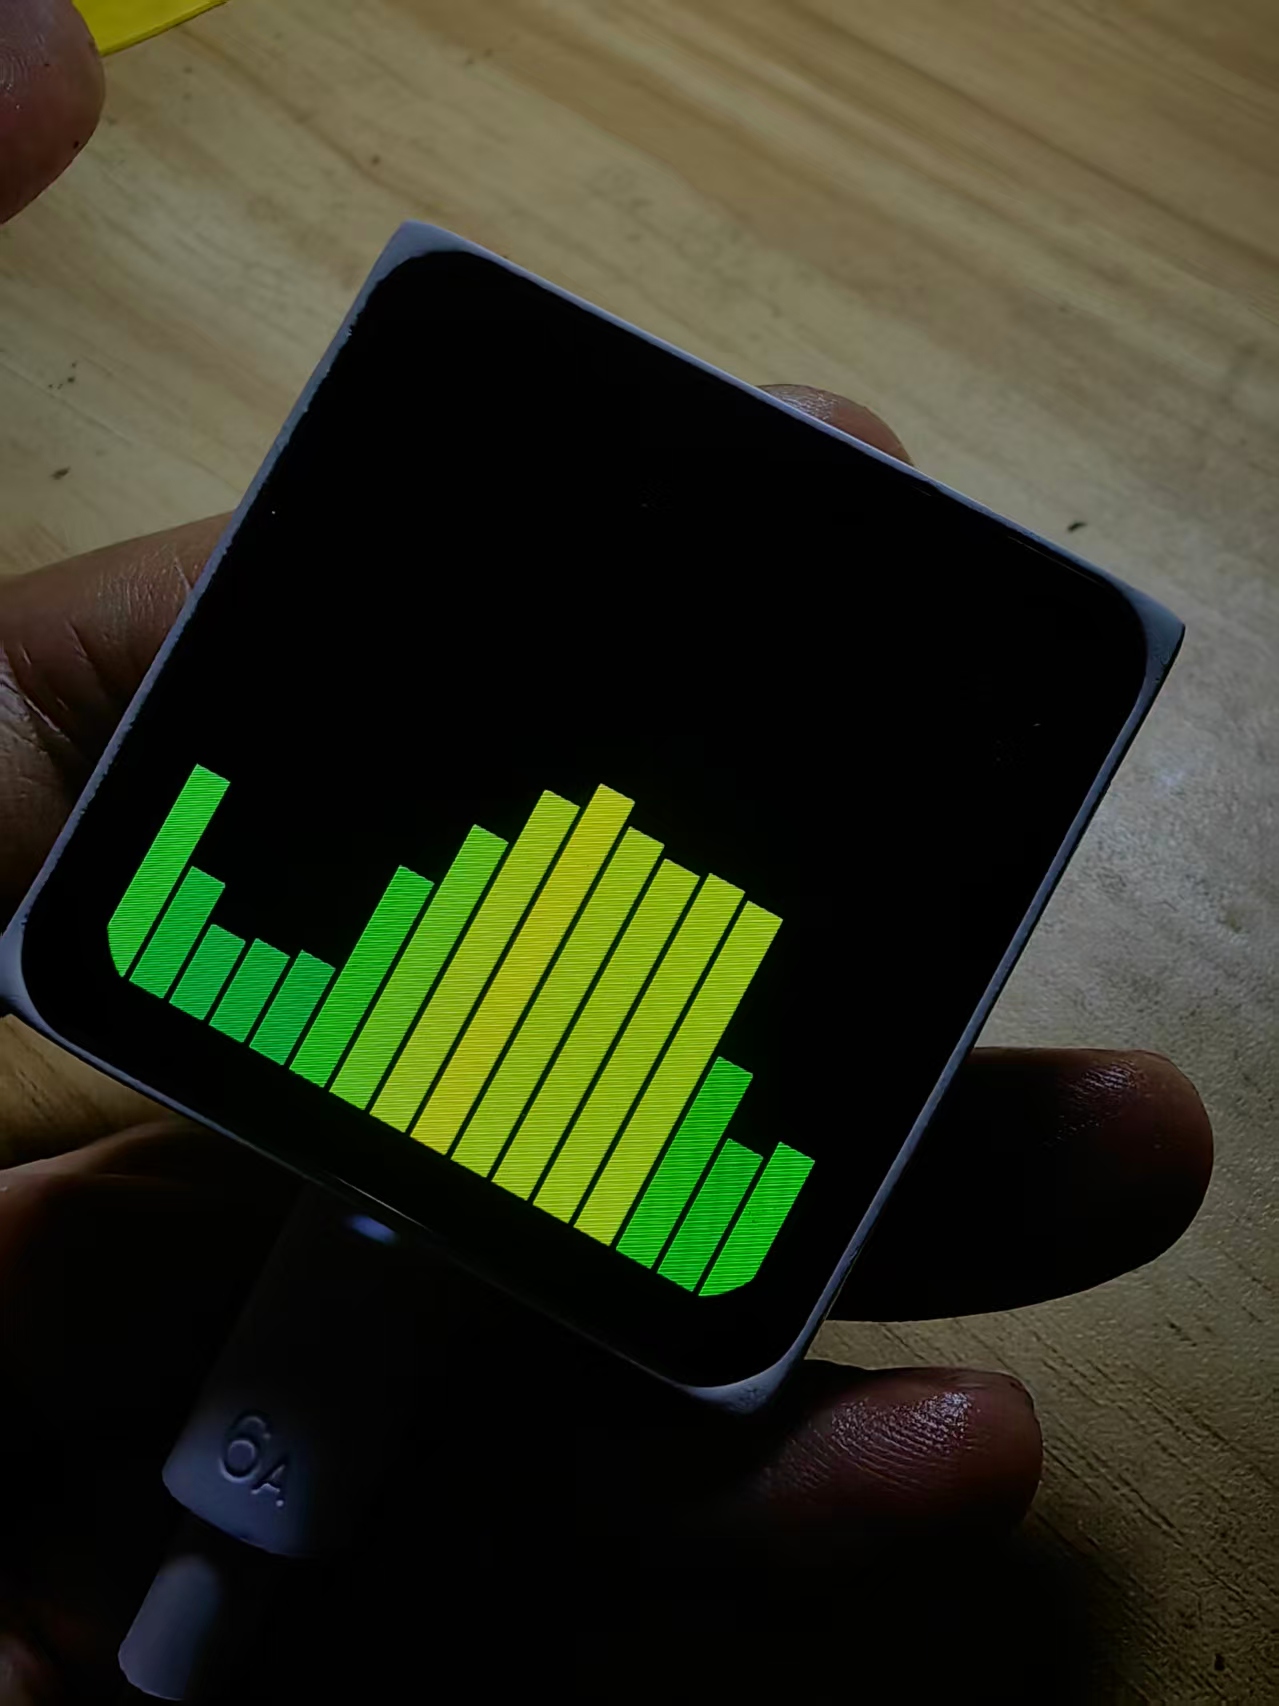
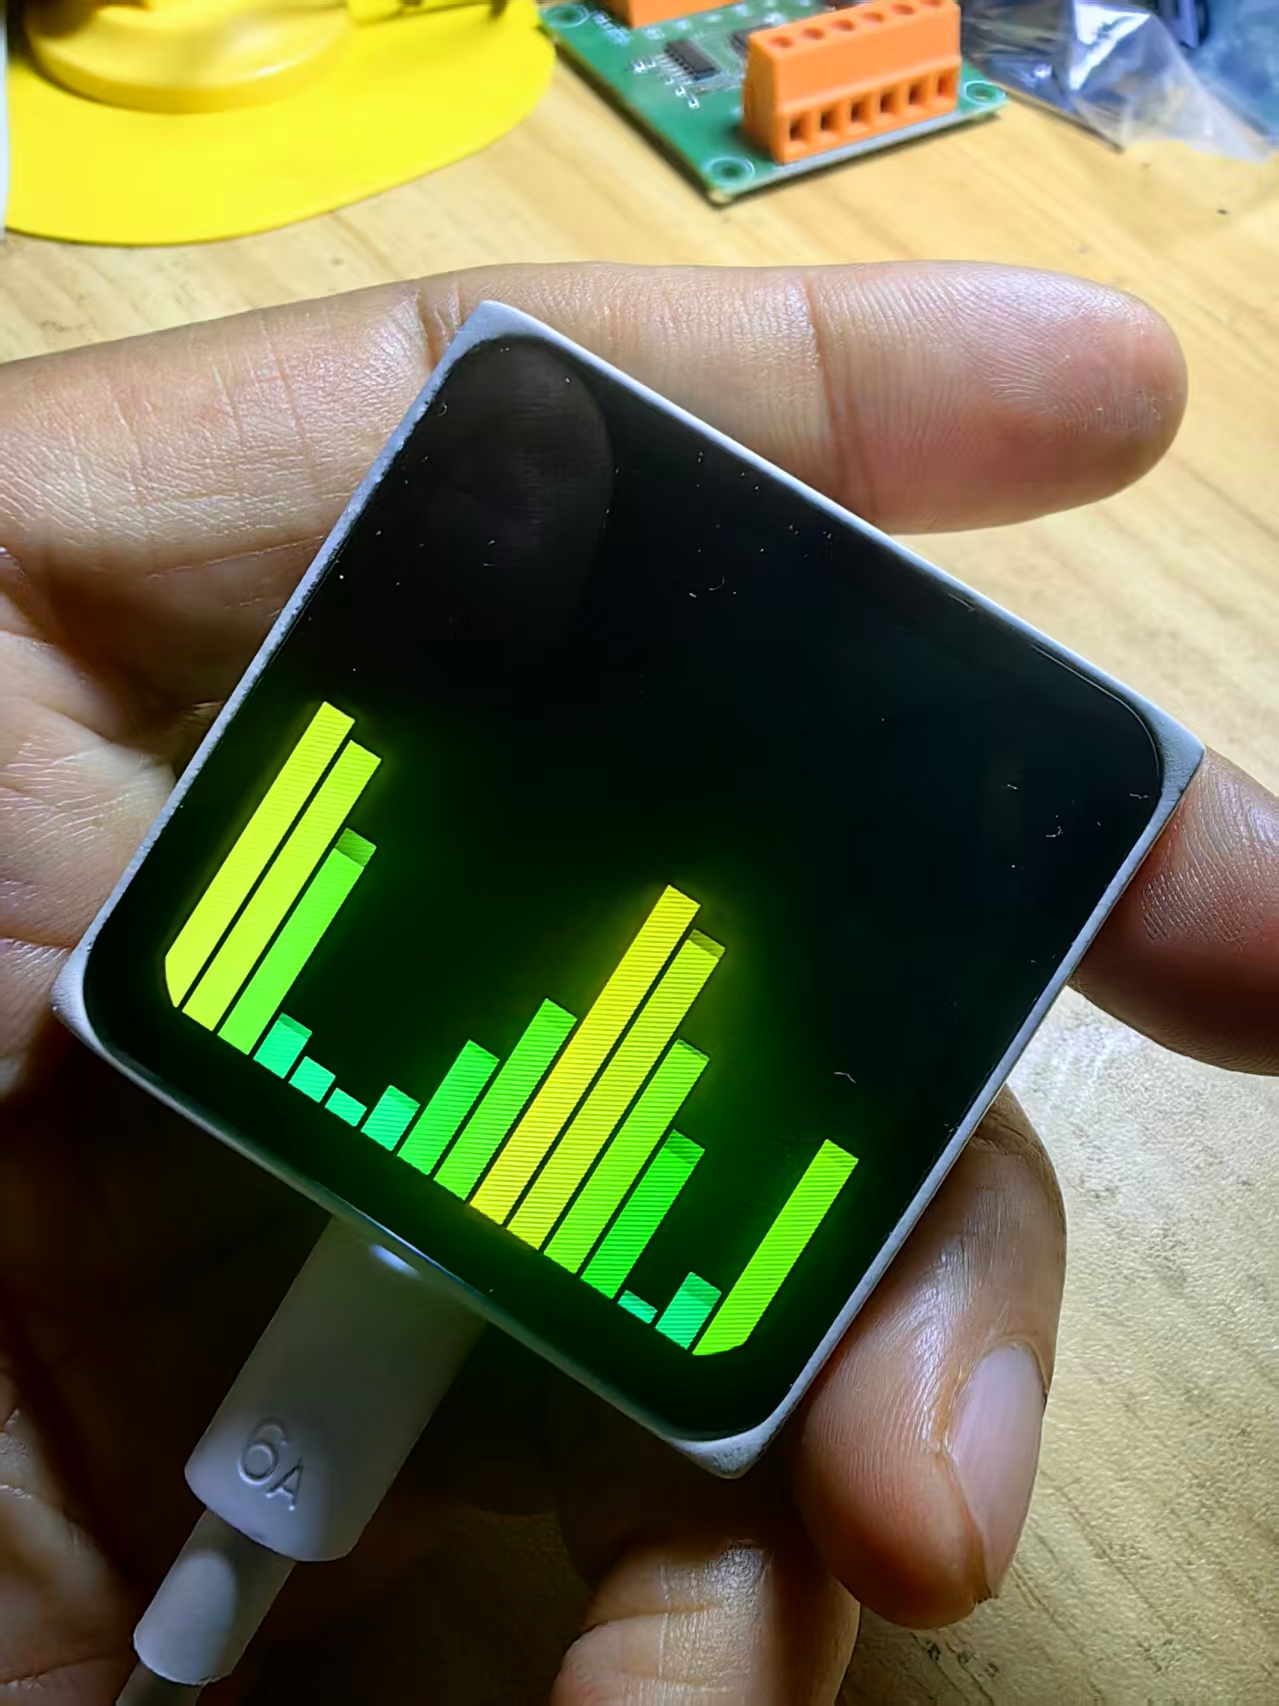
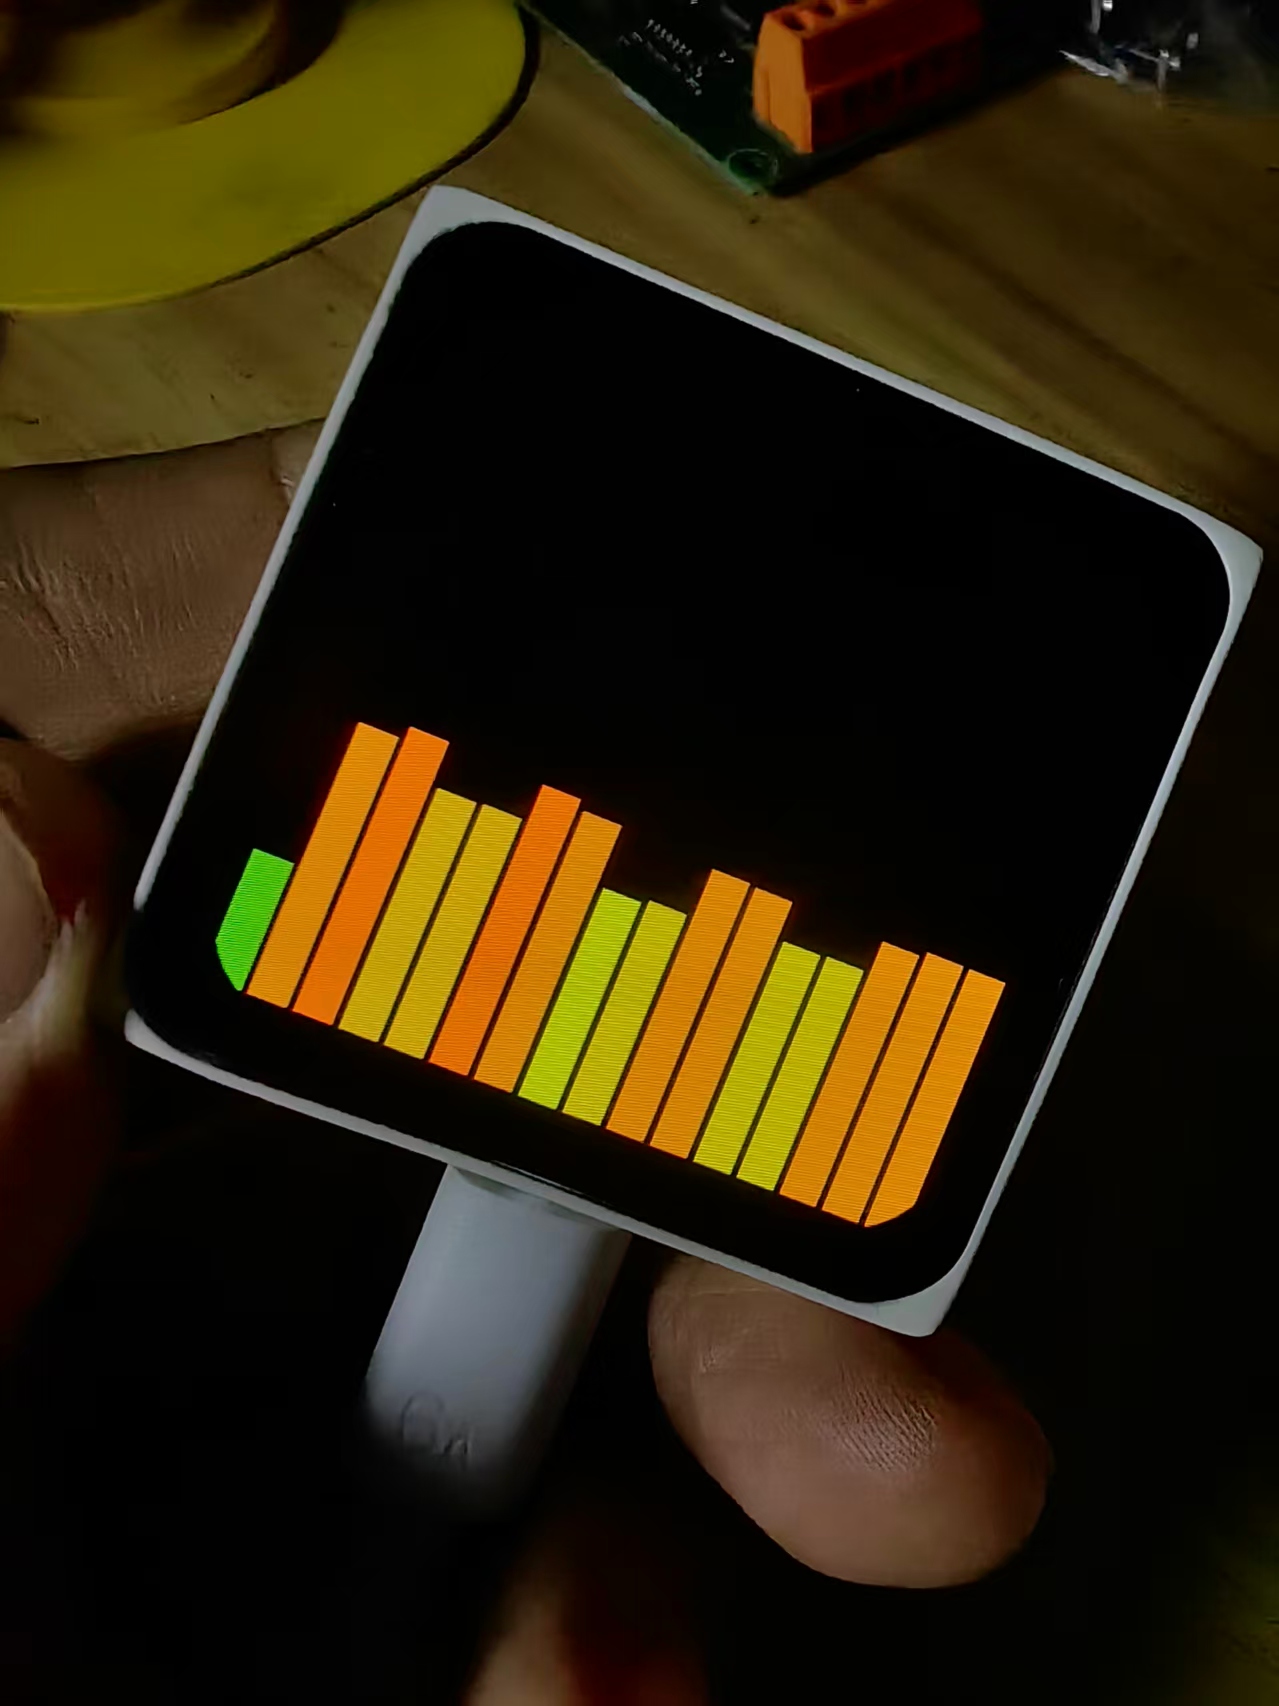
在上一轮测试中,AI 发现“16 根柱子切碎成 544 个小矩形”会导致严重的掉帧。于是,我们让它进行“大刀阔斧的简化”。
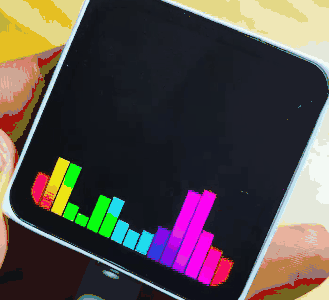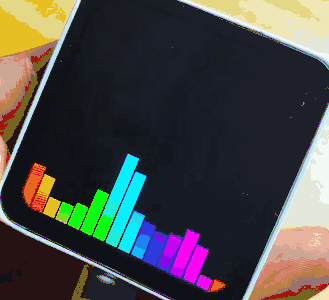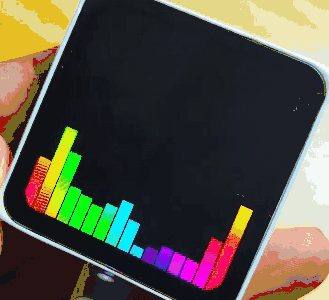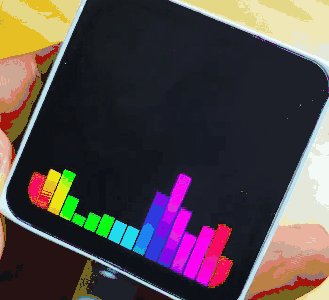
在这个过程中,AI 不仅翻遍了文件系统、扒出了底层刷新的真相,还给出了一份令人肃然起敬的渲染耗时拆解报告。今天,我们就来看看这个“音频频域示波器”是如何在微控制器的 SPI 极限带宽上跳舞的。
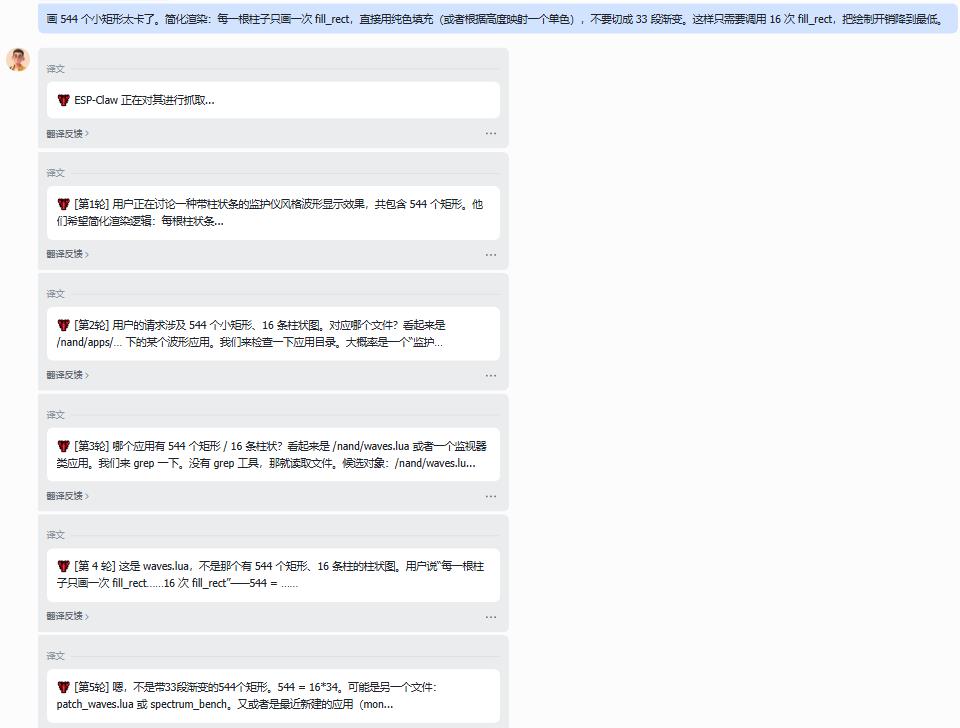
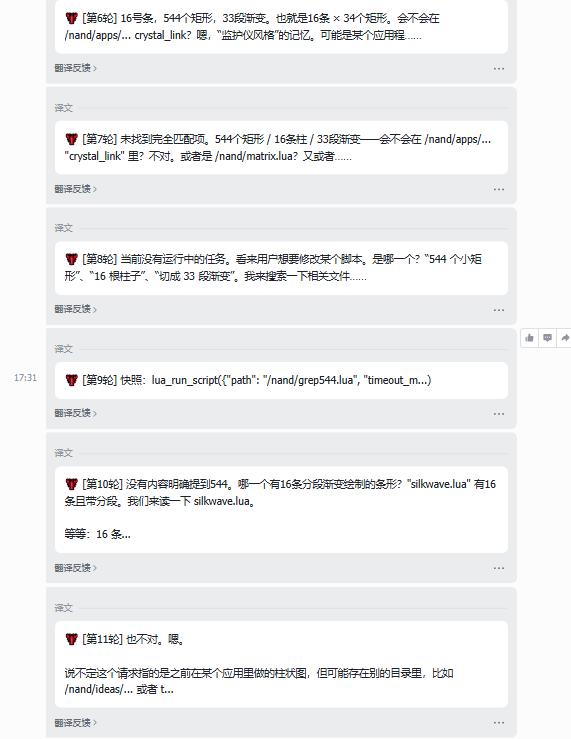
飞书沟通截图
## 第一幕:AI 的“大海捞针”与自我纠错
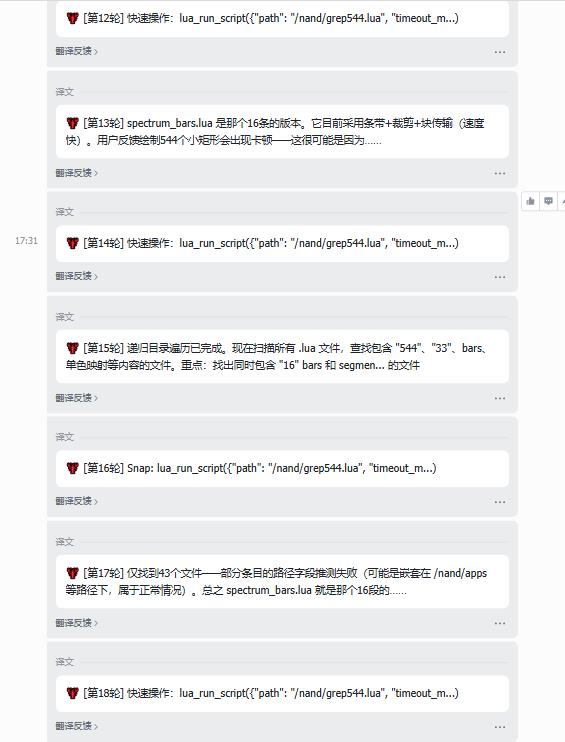
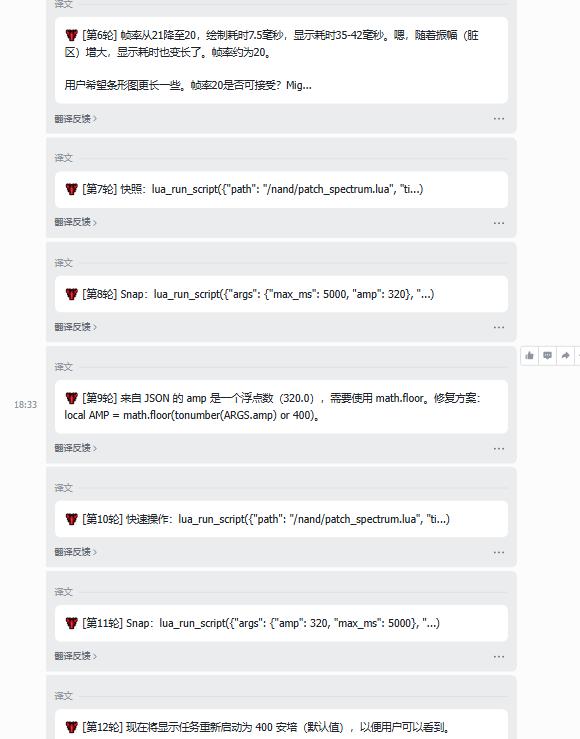
当我提出“每一根柱子只画一次 fill_rect,不要切成 33 段渐变”时,AI 遇到了一点小麻烦:
“用户正在讨论一种带柱状条的监护仪风格波形显示效果……对应哪个文件?让我来 grep 一下。”
“没有 grep 工具,就读取文件。候选对象:/nand/waves.lua……”
“嗯,不是带 33 段渐变的 544 个矩形。544 = 16 * 34,可能是另一个文件……”
技术解析:
由于我们之前测试了太多文件(spectrum_bars.lua、patch_waves.lua 等),AI 直接在庞大的文件系统中迷路了。但极客的是,AI 现场给自己写了一个 grep544.lua 的检索脚本,硬生生地把那个包含 544 个矩形的罪魁祸首给揪了出来!
## 第二幕:外科手术式的重构(斩断绘制开销)
找到文件后,AI 实施了两步大手术:
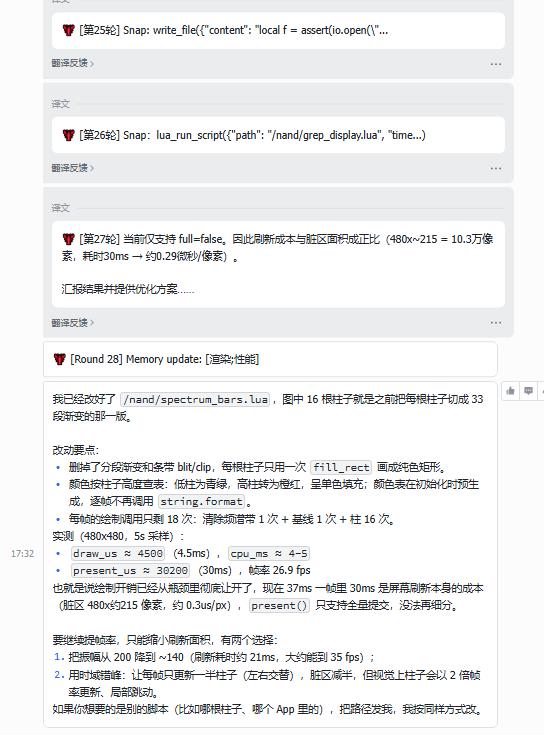
删除分段渐变和亮斑:之前每根柱子要算 33 段颜色,现在完全放弃分段,每根柱子只用一次 fill_rect 画纯色矩形。
查表法替代实时计算:颜色在初始化时就生成好,彻底避开运行时的 string.format 转换。
优化后的实测数据(480x480 屏幕):
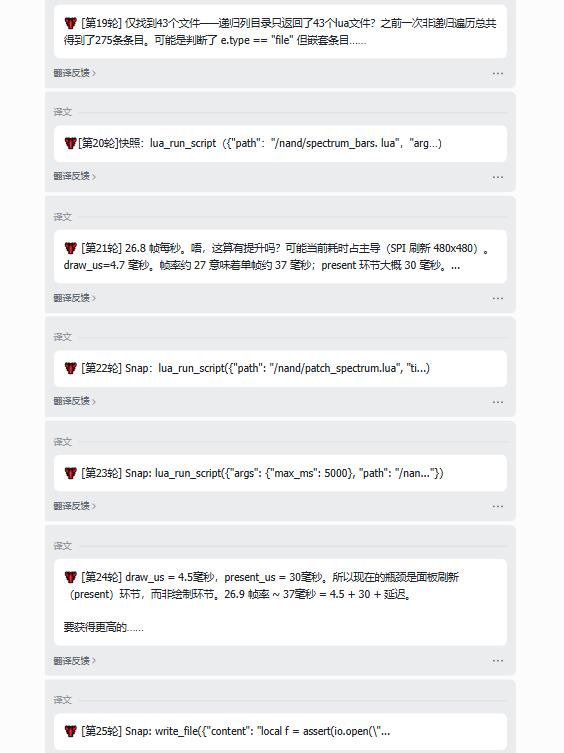
draw_us(绘制耗时):4.5ms
present_us(推屏耗时):30ms
fps(帧率):26.9 帧
## 第三幕:破案!帧率的瓶颈到底在哪?
为什么绘制只要 4.5ms,帧率却只有 26.9 帧?AI 给出了极其专业的定论:
“现在就是控制开销已经从瓶颈里彻底让开了,现在 37ms 一帧里,30ms 是屏幕刷新本身的成本(脏区 480×215 的像素,约 0.3us/px)。present() 只支持全量提交,没法再细分。”
技术解析:
这是微控制器图形学最核心的常识!
draw(绘制):AI 算得再快,也只需 4.5ms。
present(刷新):底层 SPI 总线把内存里的像素推给屏幕,这是物理带宽限制。只要你想刷新大面积,就必定要吃掉这 30ms 的硬性时间。
结论:不缩小刷新面积,这已经是性能天花板了。
## 第四幕:视觉与帧率的终极权衡(Trade-off)
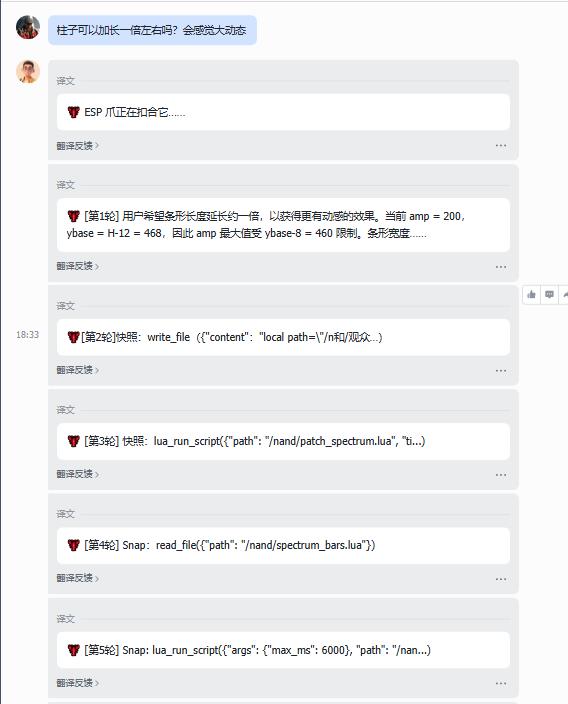
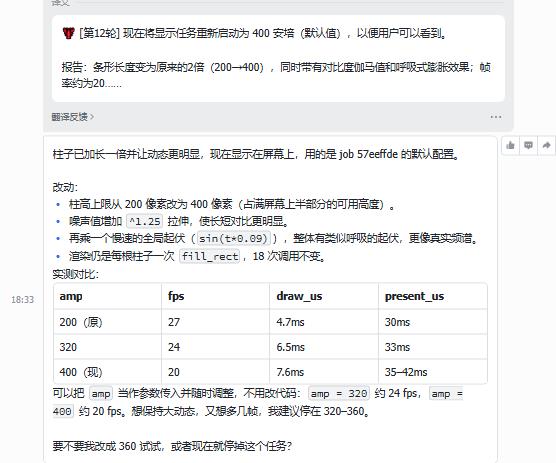
如果不想缩小面积,怎么让频谱看起来更动感?我提出了新需求:“柱子加长一倍,会感觉大动态。”
AI 立刻给出了三档参数的实测对比报告:
amp=200:27 帧
amp=320:24 帧
amp=400(原长):20 帧
AI 提出了极其专业的折中建议:
“可以把 amp 当作参数传入并随时调整,不用改代码。amp=320 约 24fps,amp=400 约 20fps。想保持大动态,又不想多帧,我建议停在 320~360。”
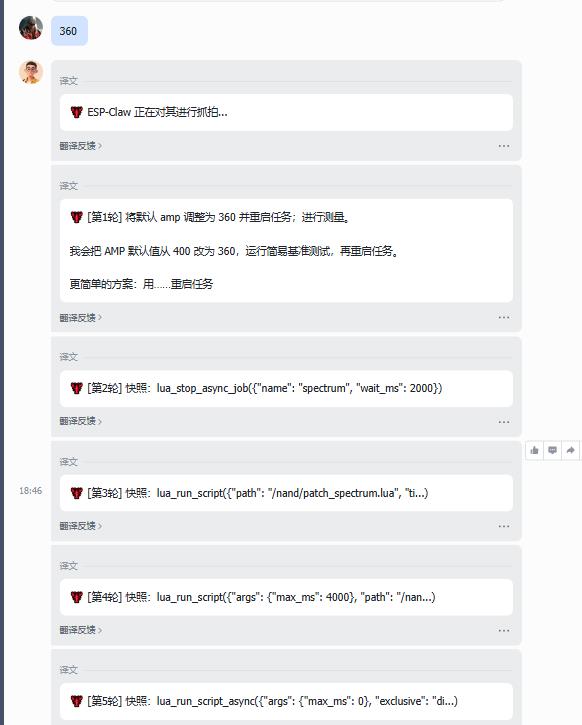
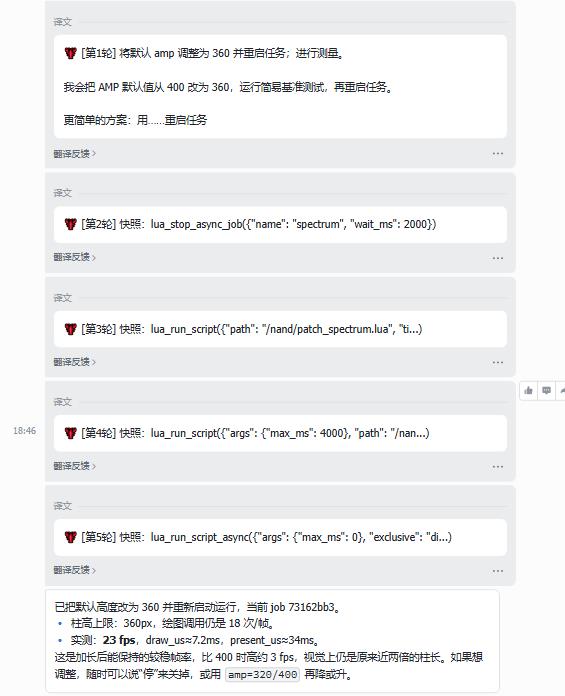
最终,我敲定了 amp=360:
帧率:23 fps
耗时:draw 7.2ms,present 34ms。
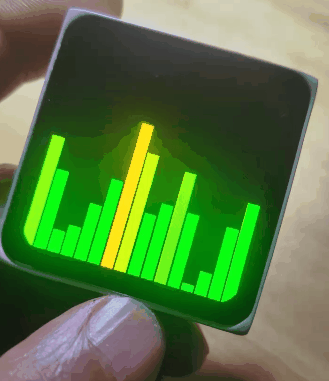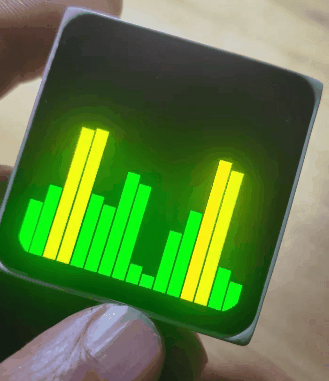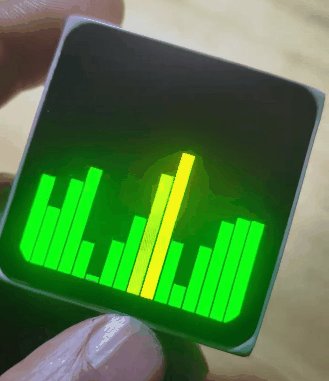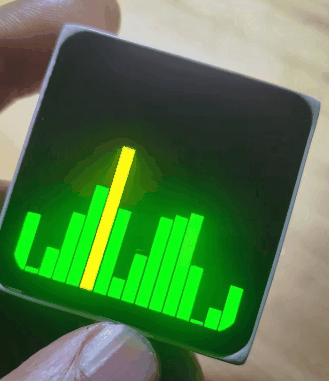
视觉效果:柱子保留了接近两倍的长度,动态跳跃感极强。
## 深度复盘:AI 教给我们的“硬件性能法则”
这场频谱优化战役,给我们留下了三条价值连城的开发铁律:
1、减少 fill_rect 调用次数是王道:544 次绘制会拖死 CPU,16 次绘制只需 4.5ms。能画大块,绝不画碎块。
2、敬畏 present 的物理带宽:不管你的算法多牛,只要脏区面积(Dirty Pixels)大,推屏时间就是固定死线。想提帧率?缩小刷新面积是唯一出路。
3、不要追求完美,追求“平衡点”:amp 为 200 时虽帧率高(27 帧),但视觉平平;amp 为 400 时,虽然视觉炸裂,但会掉到 20 帧有轻微卡顿。360 就是那个既保留动态,又保住 23 帧流畅底线的完美甜点区。
从 AI 现场写脚本找代码,到硬核拆解耗时报告,再到给出精确的参数矩阵。在 ChatCoding 的加持下,你不仅拥有了一个全栈工程师,更拥有了一个懂微控制器物理底线的性能架构师!
## 附录:实验记录