DeepSeek/Kimi/阿里云怎么选?ESP-MosaicoClaw后端LLMToken实测对比
标签:*ESP-Mosaico、Claw、ChatCoding、硬件在环 HIL、AI Agent、大模型 API、具身智能*
## 导读
玩 ESP-Mosaico 的 Claw、ChatCoding 硬件在环,很多人卡在一个核心问题:**到底选哪家大模型后端?**
Claw 不是普通聊天机器人,它是一个持续长会话、自带硬件元数据、会自动重试、循环生成 Lua 脚本的硬件 Agent。同样一句提示词,在不同模型下,格式稳定性、口语理解、缓存成本、超时重试开销,天差地别。
本文基于我们大量 ChatCoding 真机测试,把 DeepSeek、Kimi、阿里云百炼 Token Plan 三套方案,从计费机制、缓存红利、能力适配、坑点、适用场景做完整横向拆解,给做硬件 Agent、具身智能原型的创客一个可落地的选型结论。
> 前置说明:我们的核心场景
> ESP-Mosaico Claw,ChatCoding 生成 Lua 脚本
> 硬件在环 HIL 闭环:自动读取硬件信息、报错回传、多次重试迭代
> 支持 IM 远程通道(微信 / 飞书)下发指令
> 两种交互:口语自然语言指令、标准化精简提示词
> 痛点:自动重试会放大 Token 消耗,缓存机制直接决定长期成本
## 一、三套方案基础定位一句话区分
1. **DeepSeek(deepseek-flash,V4.1-Flash-1017)|按量付费 + 峰谷分时 + 超低 KV 缓存**
主打:**长会话 Agent 性价比之王**,缓存命中价格极低,闲时半价,自带图像理解,适配摄像头子板视觉 ChatCoding。
2. **Kimi(kimi-k3.1-pro)|按量付费 + 独立缓存写入计费**
主打:**中文口语理解强、指令友好**,适合现场演示、新手语音下发需求;缓存有折扣,但输出 Token 单价偏高。
3. **阿里云百炼 Token Plan 个人版|包月订阅 Credits 打包**
主打:预算固定、不用算 Token,额度一口价;缺点是**没有原生缓存优惠**,长会话持续 HIL 场景消耗更快,附带并发上限。
## 二、核心计费与缓存机制深度拆解(硬件 Agent 最关键)
> 对 Claw 这种每次请求都带上固定硬件描述、系统约束、沙箱规则的 Agent,**缓存是省钱核心**。每次请求重复前缀(硬件型号、GPIO、模块信息、系统 prompt),缓存命中后输入成本大幅下降。
### 1. DeepSeek Flash
- 计费模式:后付费,按 Token 实时结算,**分高峰 / 闲时**
- 高峰:工作日 9:00-12:00、14:00-18:00;其余为闲时(晚上、周末、节假日半价)
- 缓存命中输入:闲时 0.02 元 / 百万 Token,高峰 0.04 元 / 百万 Token(这个是巨大红利)
- 缓存未命中输入:闲时 1 元,高峰 2 元
- 输出:闲时 4 元 / 百万 Token,高峰 8 元 / 百万 Token
- 缓存特点:KV-Cache 架构优化,缓存体积很小,Agent 场景缓存收益非常明显;支持**关闭思考模式**,减少冗余思考文本输出,直接压低输出开销。
- 附加能力:原生支持图像理解,后续摄像头子板截图、报错图片可以直接传给模型分析;同时兼容 OpenAI / Anthropic 双协议,Claw 后端切换零改造。
- 短板:高峰时段输出价格翻倍;口语理解柔和度略弱于 Kimi,非常严谨的口语指令偶尔会理解偏差。
### 2. Kimi K3.1-pro
- 计费模式:按量后付费,缓存写入单独计费(5min / 1h 两种 TTL)
- 输入:13 元 / MTok;输出:68 元 / MTok
- 缓存命中读取:1.3 元 / MTok(为原价 1/10)
- 缓存写入一次性收费:5min 档 13 元,1h 档 26 元
- 缓存特点:自动识别重复请求前缀,适合会话稳定的交互;但缓存写入单独收费,如果会话频繁新建、断断续续,缓存红利会被吃掉。
- 附加能力:中文自然语言、口语指令理解是三者里最强,对模糊、生活化描述兼容性好,生成代码块格式稳定,不容易乱码。
- 短板:**输出 Token 很贵**,而 ChatCoding 恰恰是输出密集场景(生成 Lua 脚本);一旦触发多次重试,费用上涨很快;没有分时优惠。
### 3. 阿里云百炼 Token Plan 个人版
- 计费模式:包月订阅,固定 Credits 额度,四档:Lite (19.5 元 / 2w)、Essential (39.5 元 / 4.5w)、Standard (139 元 / 8w)、Pro (312 元 / 20w)
- 缓存特点:**套餐本身不提供独立缓存折扣**,Credits 不区分缓存命中 / 未命中,只要调用就消耗额度;长会话持续 HIL、反复携带硬件上下文,额度消耗速度会远高于按量方案。
- 附加能力:一套额度可以切换千问、DeepSeek 等多款模型;自带 Harness 智能体工具、联网搜索能力;适合不想管理余额、预算固定的开发者。
- 硬性红线(非常重要,Claw 用户必看):个人版仅限交互式使用,**禁止自动化脚本、循环批量调用**,持续无人值守自动 HIL 闭环有违规封号风险;还有 5 小时、7 天滚动窗口限流,短时间高频重试容易直接额度耗尽。
## 三、多维度对比总表(适配 ESP-Mosaico Claw)
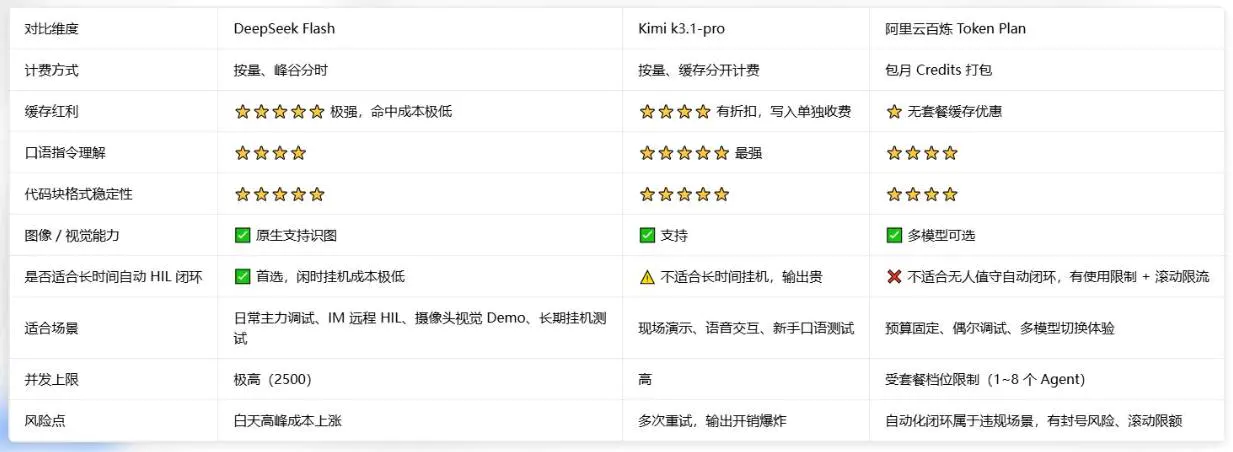
## 四、结合 ESP-Mosaico Claw 实战场景,怎么选
### 场景 1:主力长期调试、远程 HIL 闭环、微信 / 飞书 IM 远程控制(绝大多数创客的主力场景)
**优先 deepseek-flash(V4.1-Flash-1017)**
理由:
1. 我们 Claw 的 HIL 闭环,输入是固定硬件元数据,缓存命中占比极高,长期跑下来成本碾压另外两者;
2. 晚上、周末闲时半价,适合挂机跑自动测试;
3. 可以关闭思考模式,砍掉多余思考文本,配合我们之前设计的 10 个极简低 Token 动画 Demo,把输出开销压到最低;
4. 自带图像理解,后续摄像头子板视觉项目无缝衔接,不用换后端。
> 实操建议:自动 HIL 测试尽量安排在闲时;系统提示词固定,尽量复用同一个会话,最大化缓存收益。
### 场景 2:线下演示、直播、给新手体验,大量语音口语下发指令
**优先 Kimi k3.1-pro**
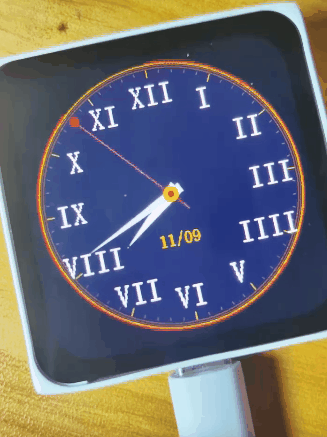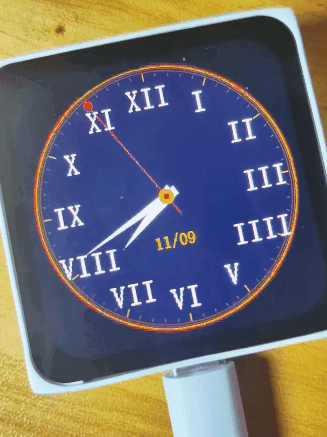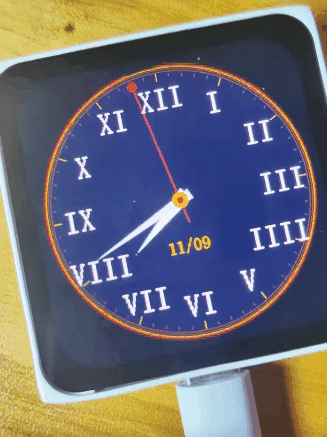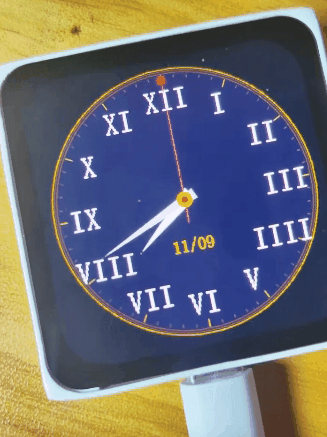
理由:Kimi 对自然语言、模糊描述的理解最好,用户随口说 “做一个慢慢变色的表盘”,更容易一次性生成符合预期的 Lua 代码,减少重试。
> 实操建议:演示尽量短会话,不要开启长时间自动重试,避免高额输出消耗。
### 场景 3:预算不想浮动、偶尔把玩、频繁切换多款模型体验,不做无人值守自动闭环
**阿里云百炼 Token Plan,Essential(39.5 元档)性价比最高**
理由:一口价,不用每天看余额;一套额度可以切换千问、DeepSeek 等模型做对比测试。
> 红线提醒:**不要开自动循环 HIL 重试**,这个套餐协议禁止自动化后端调用,容易触发 Key 封禁,只适合手动下发指令交互式体验。
## 五、Claw 使用三个后端通用避坑(踩坑实录)
1. **自动重试是成本杀手**
不管哪个模型,只要 Agent 判定脚本报错、超时,就会重新生成一次输出 Token。所以我们之前的方案:**提示词约束精简输出、禁止模型写解释文字、一个 Demo 只做单一效果**,不是单纯为了好看,是控制成本的核心手段。
2. 缓存不是万能的
缓存依赖稳定的会话前缀。频繁新建会话、每次都修改系统提示词,缓存命中率会大幅下降,红利直接消失。
3. 联网搜索务必关掉
Claw 做硬件脚本生成,不需要联网;一旦开启联网搜索,不仅额外扣费,还会拉长响应时间,超时之后触发重试,双重浪费额度。
## 六、总结
ESP-Mosaico Claw 硬件 Agent,和普通聊天、普通 AI 编码场景有本质区别:**它是持续长会话、带固定硬件上下文、存在自动重试的闭环系统,缓存机制权重 > 单纯的对话能力**。
- 追求长期挂机、远程 HIL、低成本主力后端:**deepseek-flash**
- 追求现场口语演示、新手友好:**Kimi k3.1-pro**
- 预算固定、手动把玩、多模型对比体验:**阿里云百炼 Token Plan**
没有绝对最好的后端,只有匹配你当前开发模式的选择。很多创客踩坑,就是直接拿聊天模型的选型经验套到硬件 Agent 上,忽略了重试、缓存、计费协议这些硬件在环独有的约束。