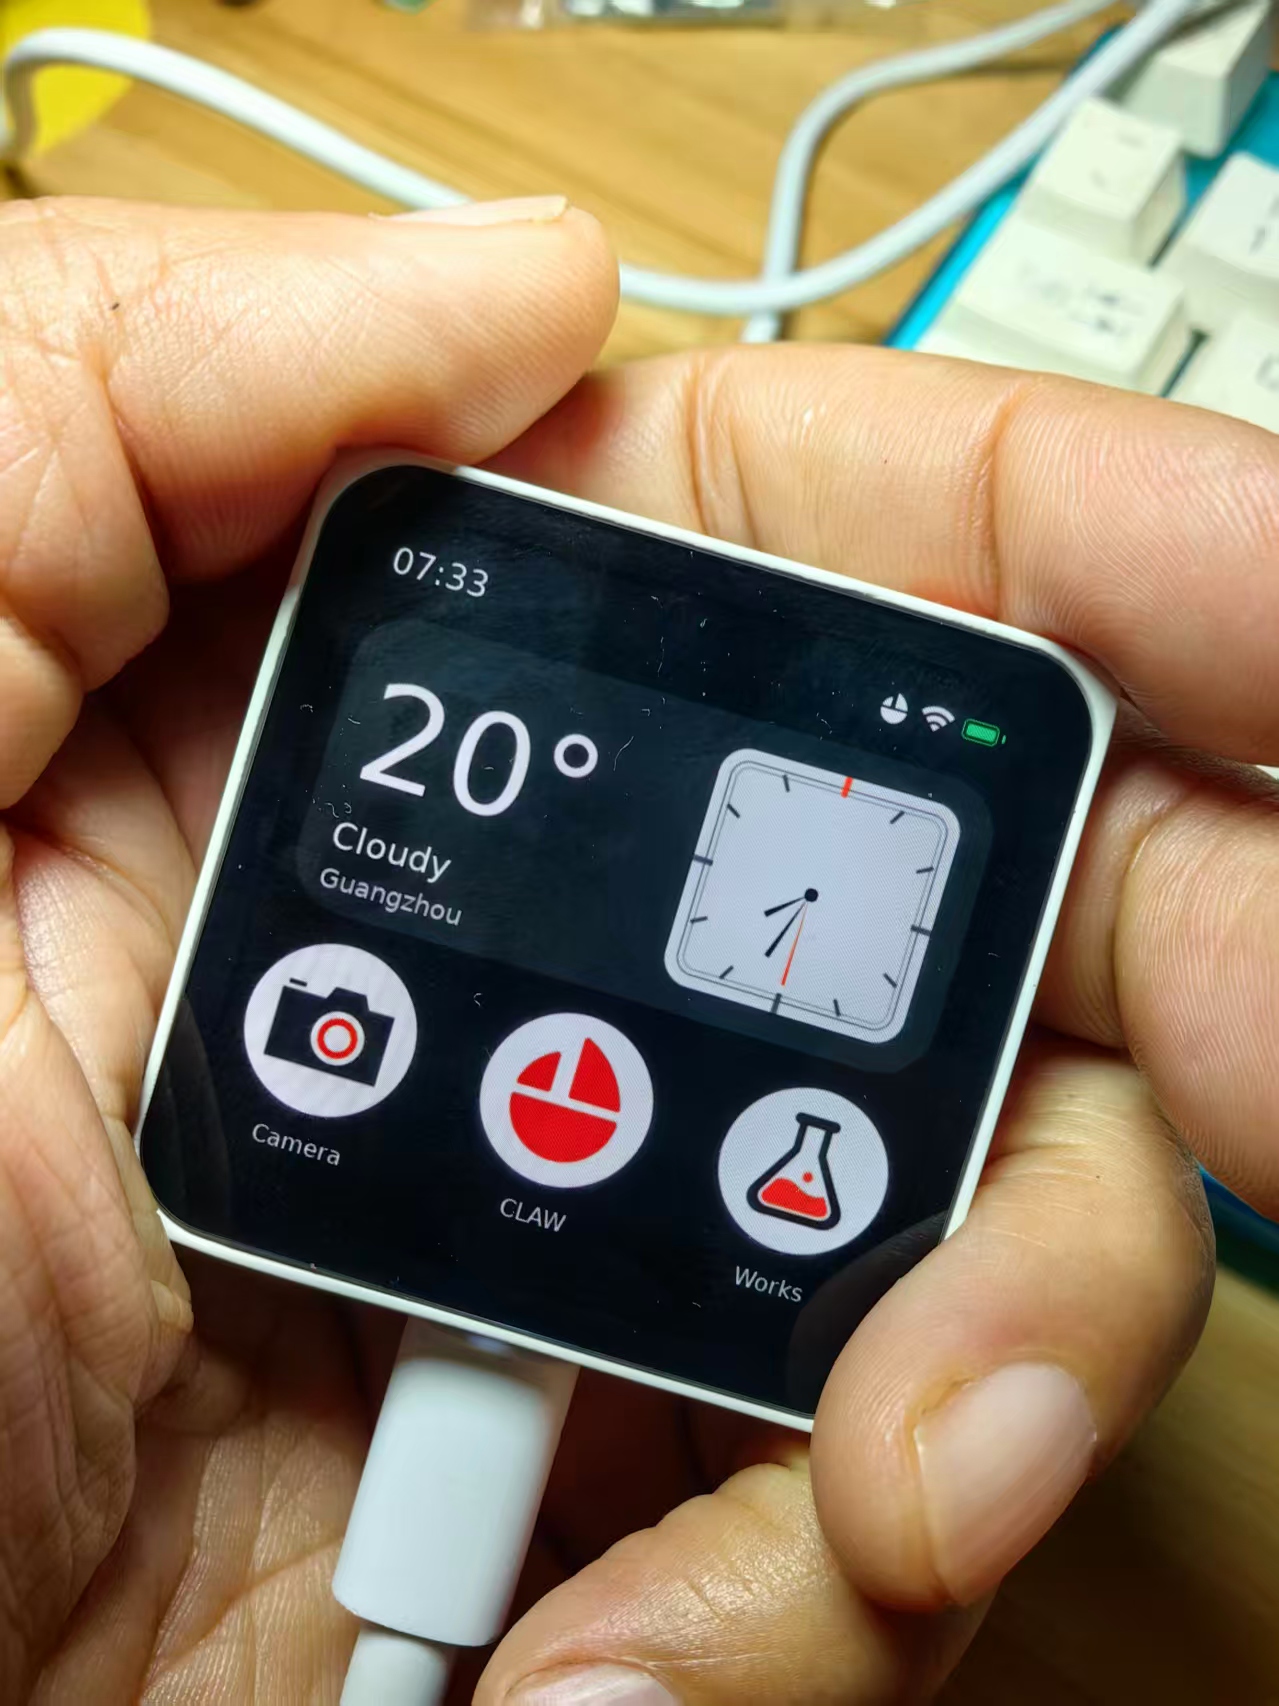
飞书发一句话,ESP-Mosaico 屏幕呼吸灯就改好了:远程HIL实战 + DeepSeek账单
标签:*ESP-Mosaico、ESP-Claw、ChatCoding、硬件在环 HIL、飞书 IM 远程、Agent 闭环、Lua 脚本、DeepSeek-Flash*
## 导读
前面我们完成了 Claw 三大后端 DeepSeek / Kimi / 阿里云百炼的选型对比,也看过 Claw 后台里的 IM 远程通道、网络和搜索设置页面。很多人对 ChatCoding 的理解停留在:拿着板子、对着屏幕语音下发指令。
但这套体系最有价值的延伸形态,是脱离设备本地,通过 IM 消息远程完成完整硬件在环闭环。
本文结合飞书聊天交互实录 + DeepSeek 官方 API 用量账单,完整复盘同一个呼吸动画原型的多轮迭代过程,一边看 Agent 怎么自动解析需求、热部署脚本、自检真机状态,一边量化看懂:远程硬件 Agent 多轮迭代,到底消耗多少 Token、花多少钱,同时拆解实战里踩过的模型名称大小写坑。
> 前置说明
> 环境:ESP‑Mosaico V1.2 + ESP‑Claw,开启飞书 IM 通道;后端选用 deepseek-flash;开启`exclusive=display`独占屏幕模式,新任务自动关停旧屏幕任务。
## 一、整条链路先看懂:飞书消息是怎么控制硬件的
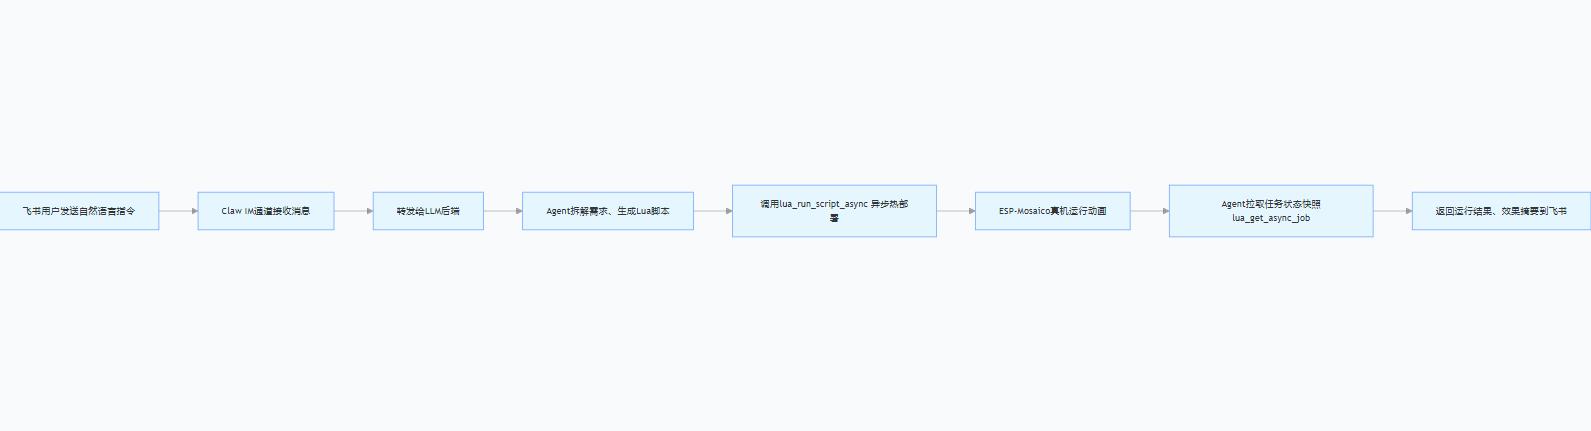
全程不需要电脑烧录、不需要登录设备网页控制面板,所有交互全部在飞书对话框内完成,是典型的远程硬件在环 HIL 闭环。
## 二、逐轮对话实战解读(飞书交互日志)
### 第一轮:初始需求,遭遇模型名称 400 报错
用户指令:
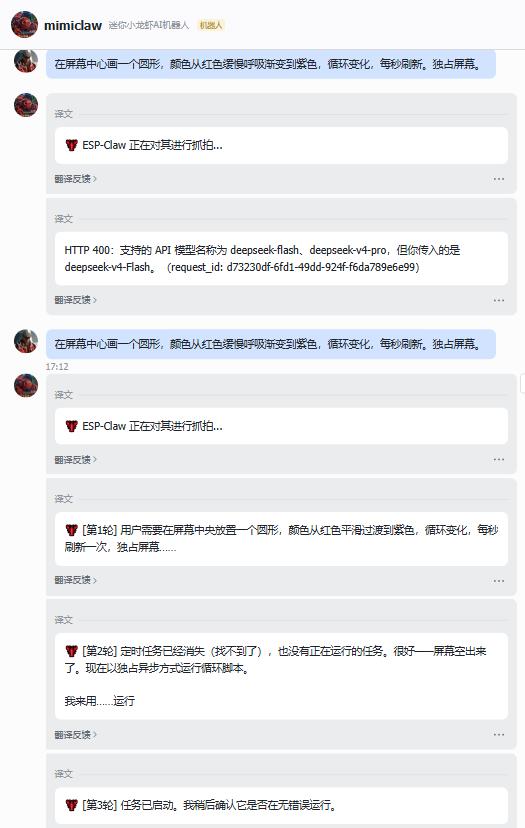
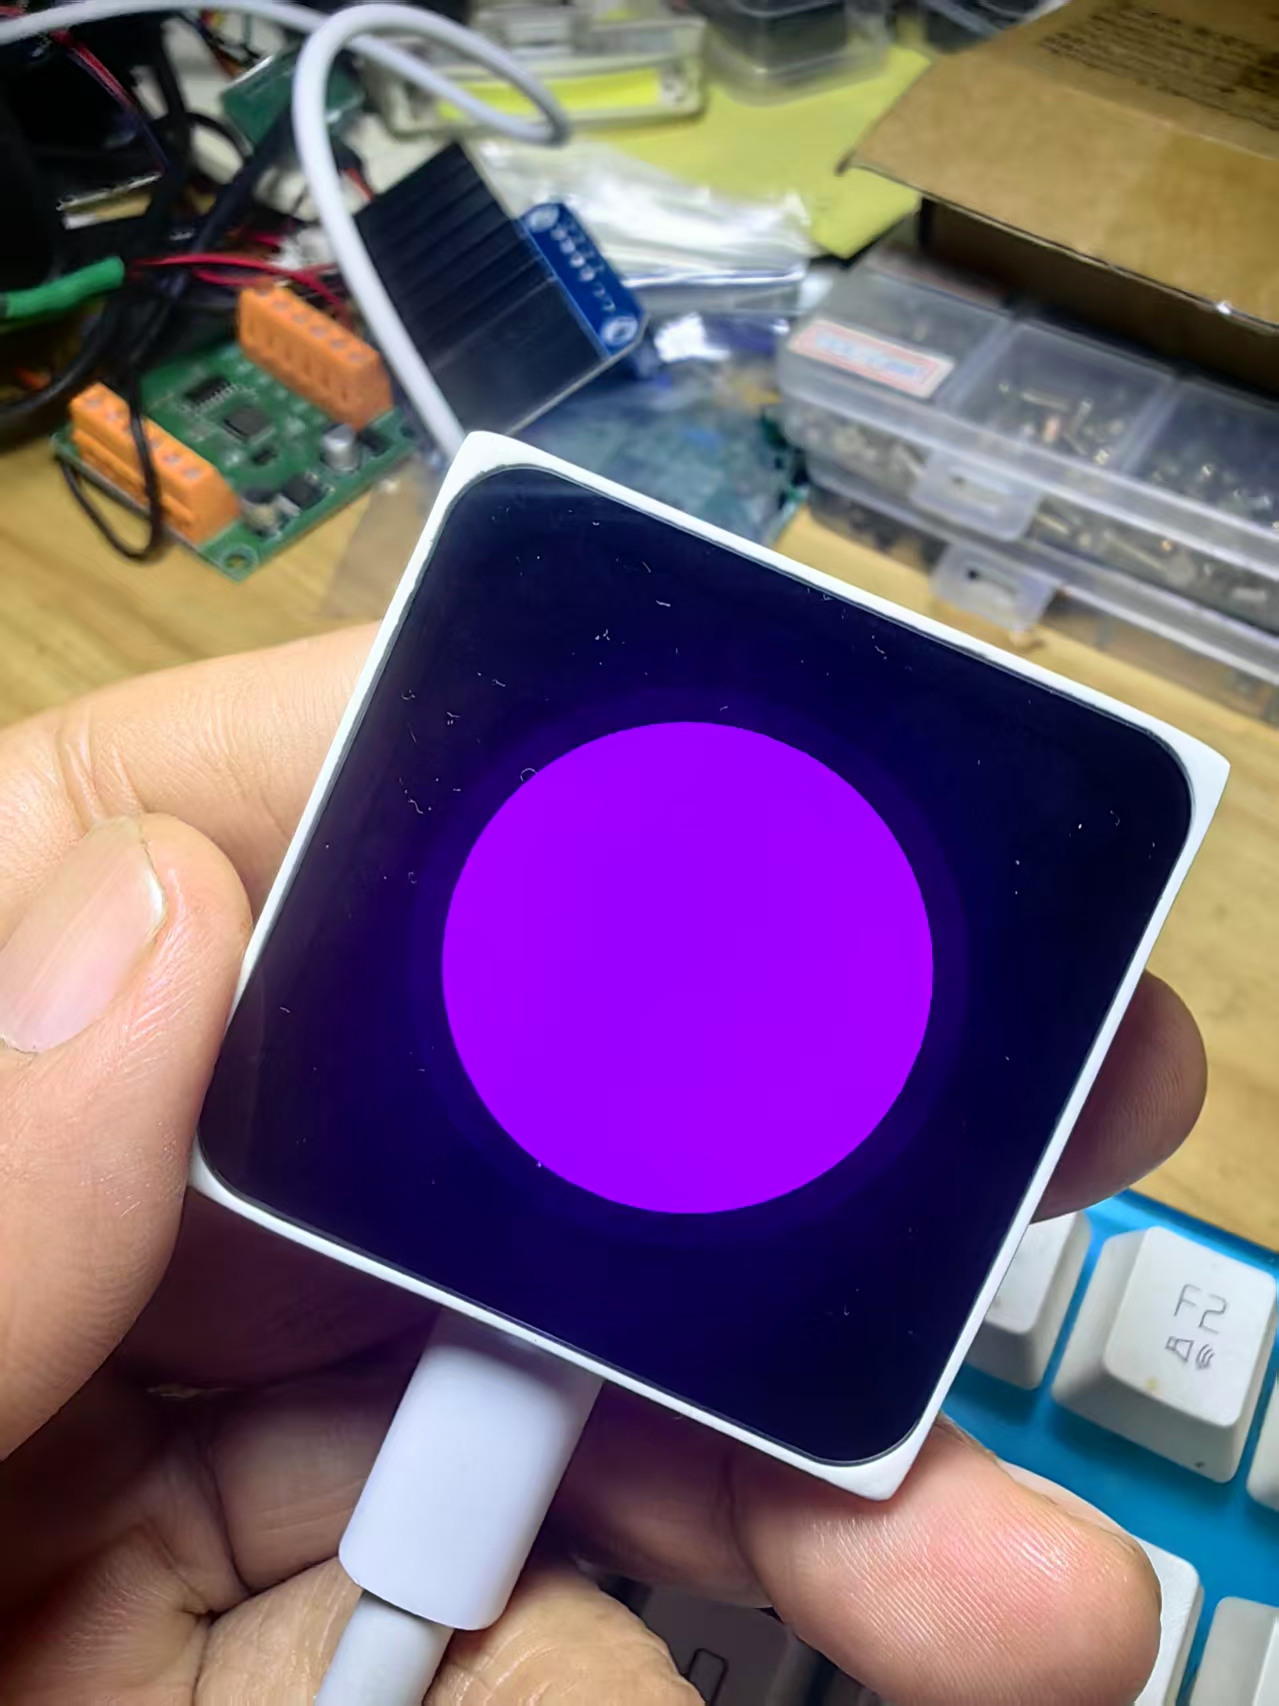
> 在屏幕中心画一个圆形,颜色从红色缓慢呼吸渐变到紫色,循环变化,每秒刷新。独占屏幕。
Agent 日志:`ESP-Claw 正在对其进行抓拍...`
随即抛出报错:
> HTTP 400: 支持的 API 模型名称为 deepseek-flash、deepseek-v4-pro,但你传入的是 deepseek-v4-Flash。
报错根因:
DeepSeek 接口对模型名称**严格精确字符串匹配、区分大小写**。配置里填写了大写 F 的`deepseek-v4-Flash`,但服务端只认小写规范标识`deepseek-flash`。这是接入 API 非常高频的细节坑,切换后端时模型名称必须原样复制服务商文档。
修正模型名称后,Agent 启动三轮闭环流程:
- 第 1 轮:解析需求,翻译为技术规格:屏幕中央圆形、红紫平滑渐变、每秒刷新、独占屏幕
- 第 2 轮:自动检索、清理正在运行的旧定时任务,释放屏幕资源,使用独占异步方式提交脚本
- 第 3 轮:提交任务,等待启动,计划后续自检确认运行状态
最终返回效果摘要:
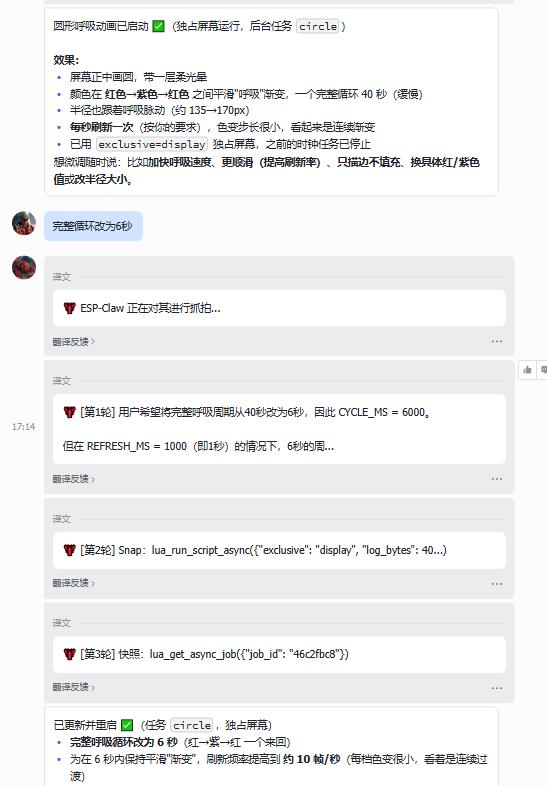
> 圆形呼吸动画已启动(独占屏幕运行,后台任务 circle)
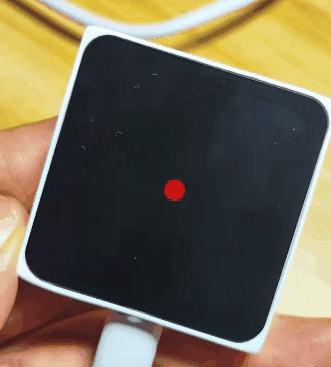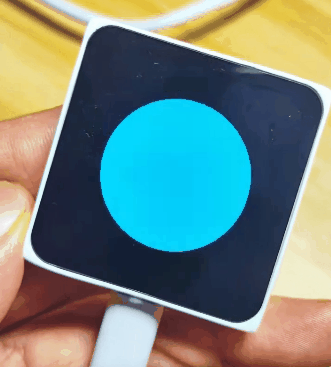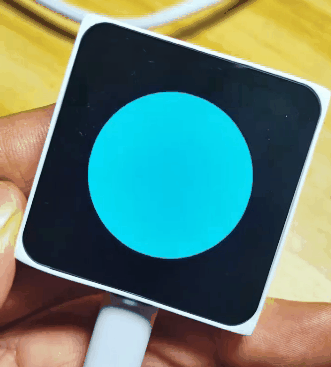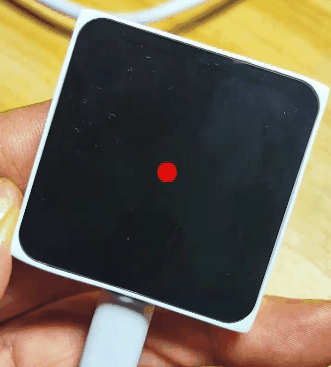
> 屏幕正中画圆,带一层柔光晕;颜色红↔紫循环,完整周期 40 秒;半径同步脉动;每秒刷新;开启 exclusive=display 独占,自动停止之前屏幕任务。
这里核心机制是 `exclusive=display` 独占模式:屏幕属于互斥硬件资源,开启独占标记后,新的屏幕绘图任务会自动终止原有屏幕脚本,避免多个绘图脚本抢占画面、出现画面撕裂、异常闪屏。这是硬件 Agent 非常关键的内置资源调度能力。
### 第二轮:二次迭代,修改循环速度
用户指令:
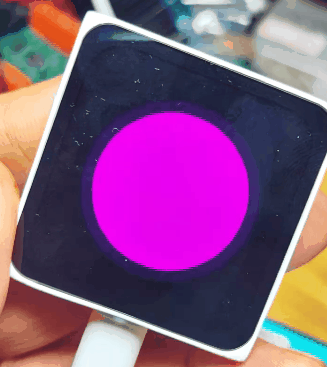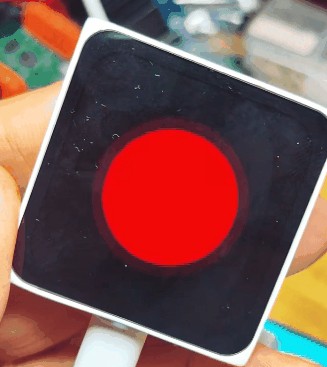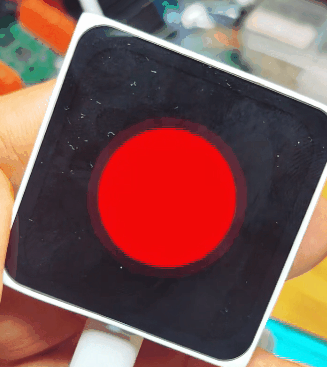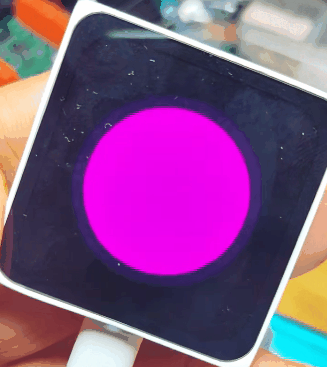
> 完整循环改为 6 秒
Agent 自动识别需求矛盾:原刷新间隔 1000ms(1 秒一帧),如果总周期压缩到 6 秒,仅 6 个采样点,渐变会生硬卡顿。
Agent 自主做工程权衡优化:
- 设置周期 `CYCLE_MS = 6000`
- 自动提升帧率至约 10 帧 / 秒,缩小每一步颜色变化幅度,保证视觉顺滑
同时给出可选方案:如果你就要严格每秒一跳、6 级跳跃效果,我可以改回 1000ms 刷新。
这也是 AI Coding Agent 和普通代码生成器最大区别:它理解硬件显示的感官约束,会主动权衡参数,而不是死板直译文字。
### 第三轮:第三次迭代,增加色彩通道、调整脉动范围
用户指令:
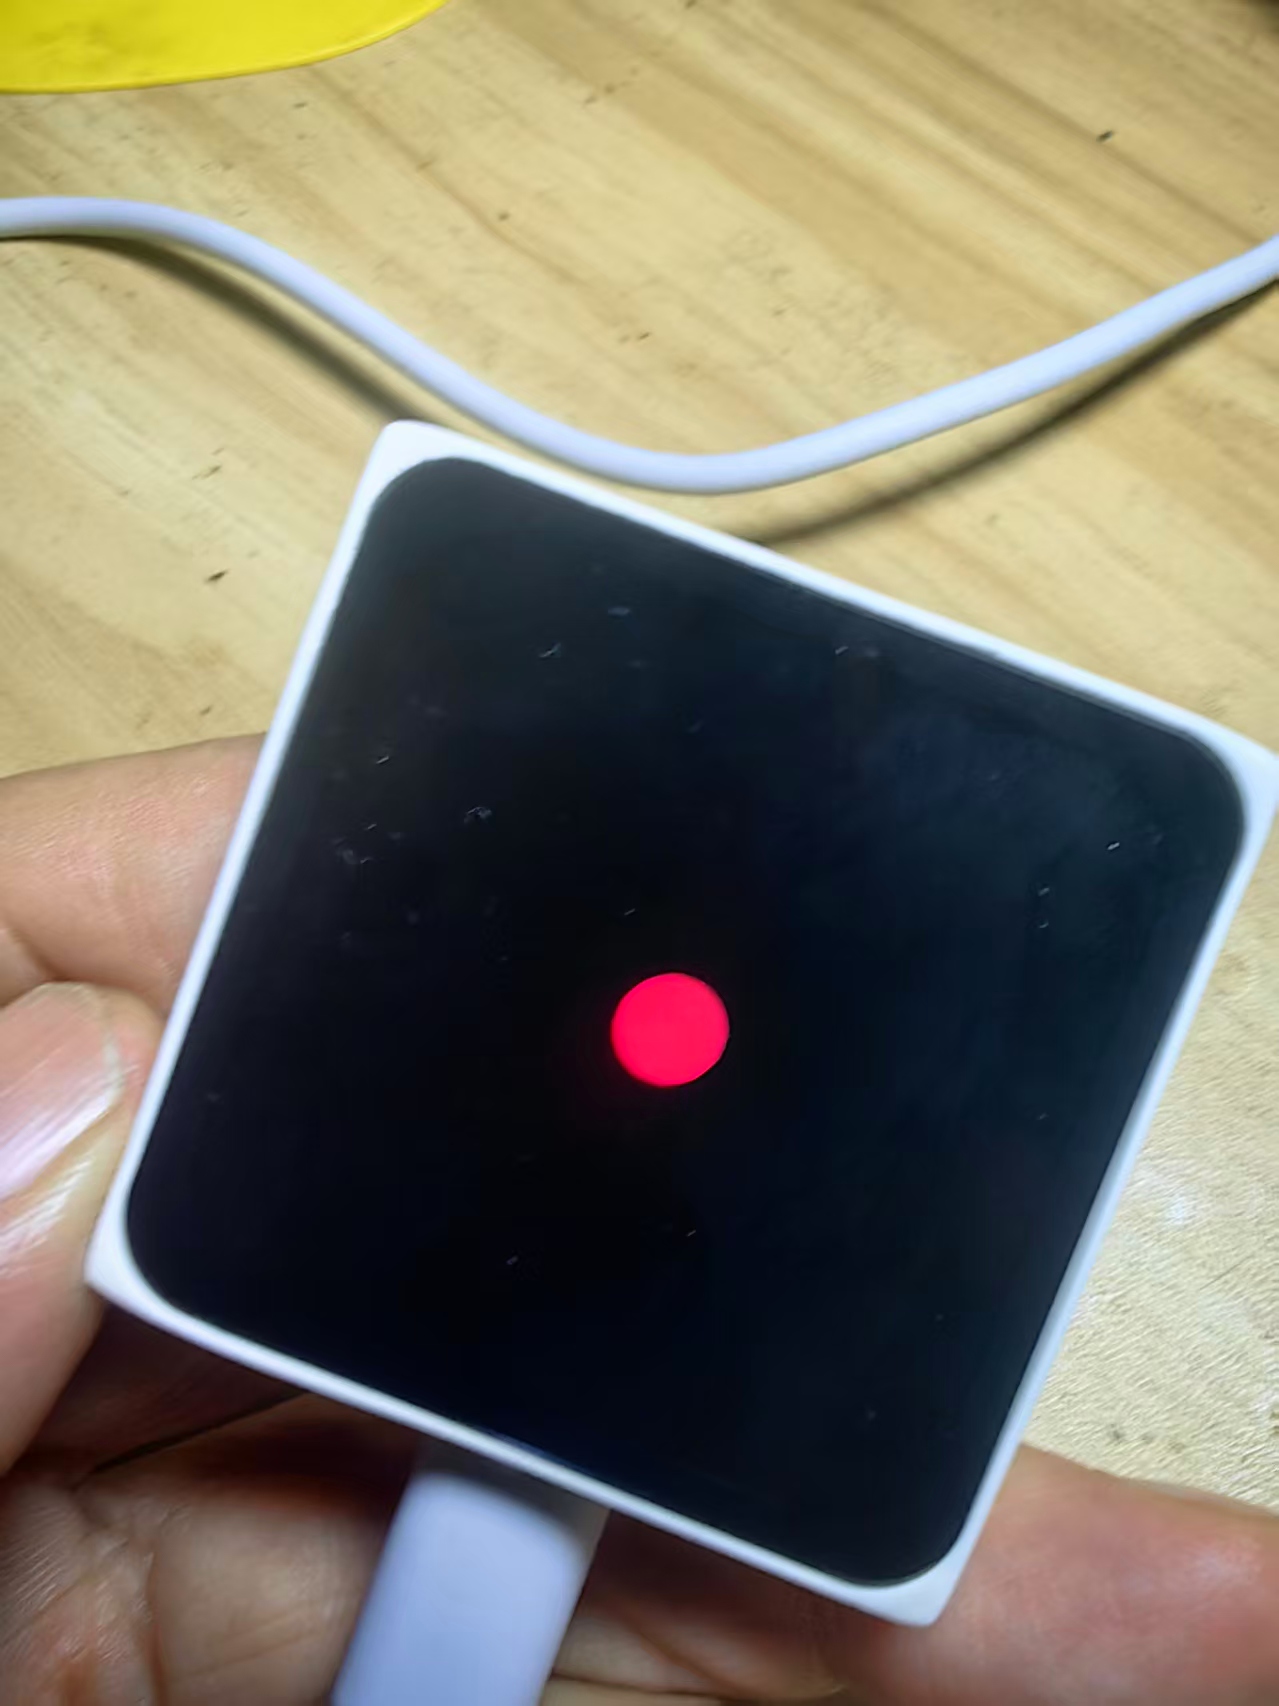
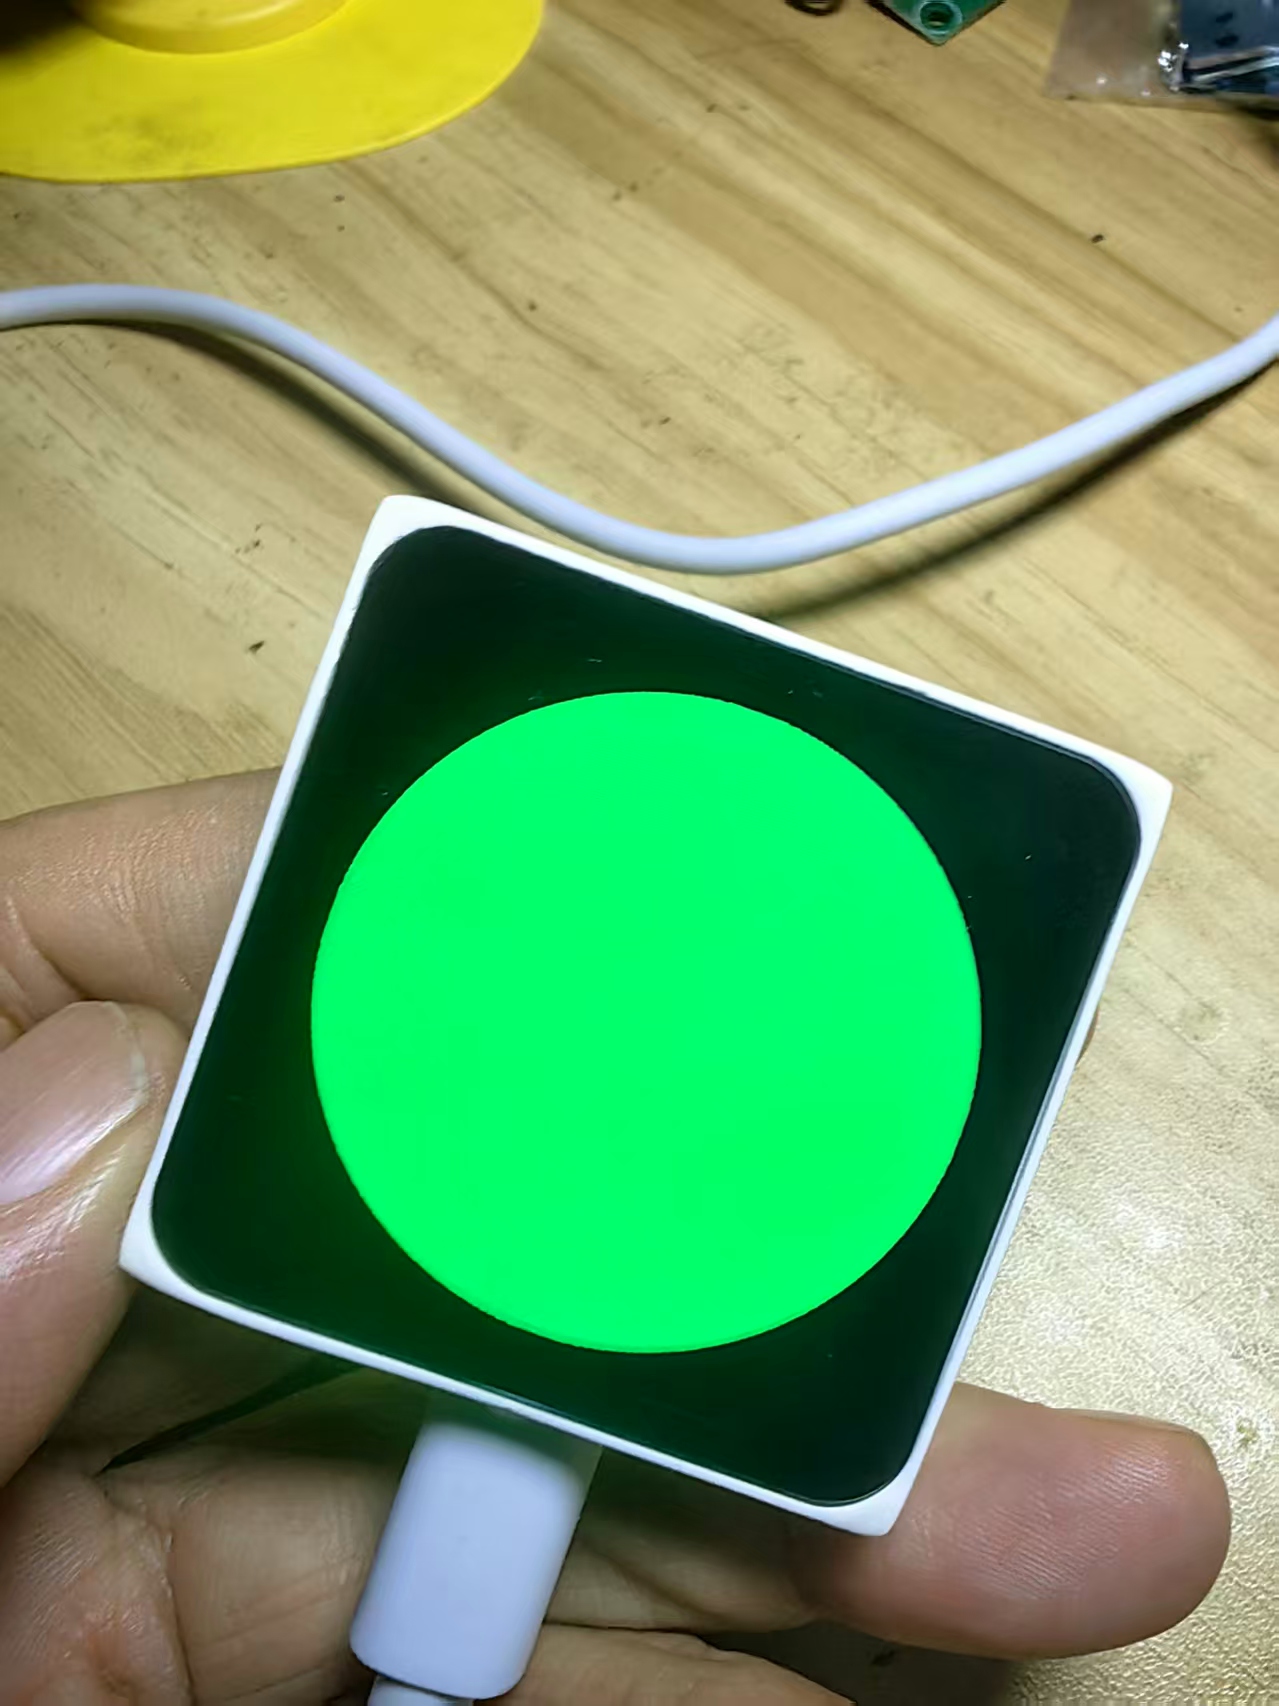
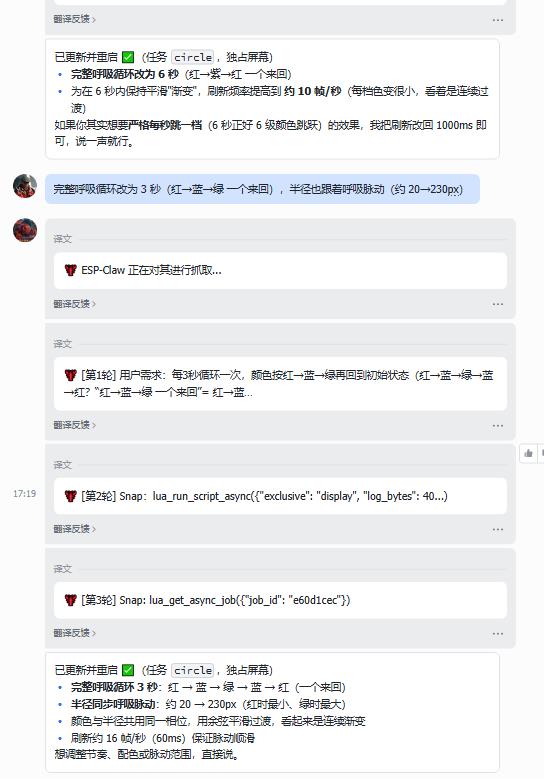
> 完整呼吸循环为 3 秒(红→蓝→绿一个来回),半径也跟着呼吸脉动(约 20→230px)
解析、生成、部署完成后返回:
> 已更新并重启(任务 circle,独占屏幕)
> 完整呼吸 3 秒,红→蓝→绿→红;半径同步 20~230px 脉动;颜色与半径共用相位,余弦平滑过渡;刷新约 16 帧 / 60ms,保证顺滑。
重点亮点:**颜色变化和半径脉动复用同一个相位变量**。
Agent 自发做了优化,同一时间相位驱动两套变化,放大缩小和变色完全同步,呼吸一体感更强,而不是两套独立随机变化。
附录:飞书原始通信截图(手机端与电脑端效果相同)
## 三、配套用量账单解读:本次整套测试真实成本
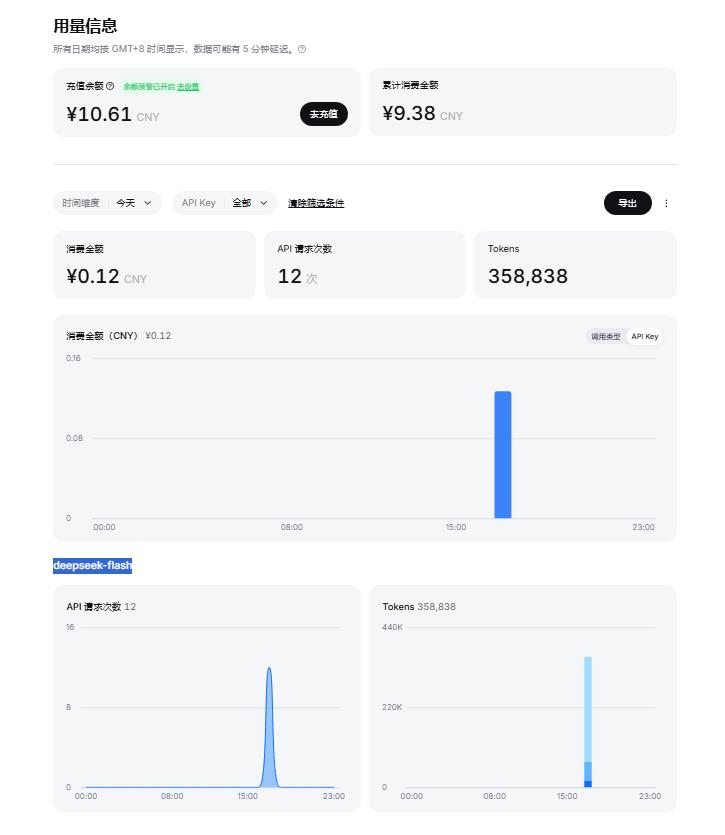
上面这三段连续迭代,对应的 DeepSeek 后台用量面板数据:
- 账户余额:¥10.61
- 账户历史累计消费:¥9.38
- 本次测试时段统计:
- 消费金额:**0.12 元**
- API 请求次数:**12 次**
- 总 Token 消耗:**358,838 Token**
- 使用模型:`deepseek-flash`
图表上消费、请求次数、Token 三条曲线的尖峰完全重合,时间和飞书聊天记录一一对应,证明这一批调用全部来自本次远程 HIL 测试,没有其他额外调用。
很多人会疑惑:明明只有 3 条用户自然语言指令,为什么会产生 12 次 API 调用、35 万 + Token?
1. 硬件 Agent 闭环≠一问一答聊天:一条用户指令会触发多轮思考:需求解析 → Lua 脚本生成 → 任务快照自检,形成完整闭环;
2. 每次请求都携带固定硬件上下文:包含 ESP-Mosaico 硬件能力、绘图 API、Lua 库定义、当前运行任务、历史日志,这部分是 Token 消耗的大头;
3. DeepSeek-Flash 的 KV 缓存在这里发挥巨大价值:固定系统提示词、硬件描述被缓存,命中后输入 Token 成本大幅压低,这也是 35 万 Token 仅花费 0.12 元的核心原因。
对比之前的后端选型结论:同样多轮迭代场景,如果换成 Kimi k3.1-pro,输出 Token 单价更高,整套测试费用会明显上涨。DeepSeek-Flash 低单价 + KV 缓存,非常适配这类长上下文、反复迭代的硬件 Agent 场景。
附录:今天 deepseek-flash 使用量截图
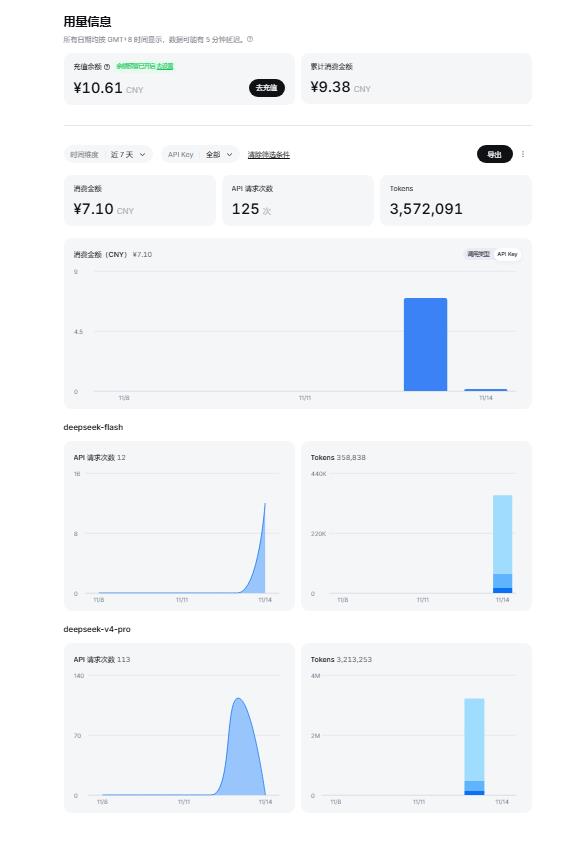
与昨天使用量对比(昨天使用 deepseek-v4-pro,费用 6.98元)
## 四、核心能力拆解
1. **IM 通道 = 远程交互入口**
飞书在这里只是消息传输载体,替代本地触屏、网页面板输入;核心逻辑依然是 ESP-Claw 的 Agent 调度框架,微信、飞书可以按需切换。
2. **异步任务 API 是闭环基石**
`lua_run_script_async`:异步提交脚本,后台热部署运行,不阻塞消息回复;
`lua_get_async_job`:拉取任务快照、运行状态,判断脚本是否正常执行。
Agent 依靠这两个接口,实现 “下发 → 等待 → 自检反馈” 闭环。
3. **资源隔离:独占屏幕机制**
专门针对屏幕这种互斥硬件资源设计,自动管理任务启停,避免资源冲突。
4. **增量迭代范式**
三次指令都是在`circle`任务基础上修改参数,不是每次全部重写脚本,和之前表盘踩坑实录结论一致:ChatCoding 天然适合小步增量调参。
## 五、实战踩坑 & 成本优化清单
1. **模型名称大小写敏感**
DeepSeek 等很多 LLM 接口为精确字符串匹配,名称写错直接返回 400,配置 LLM 后端时严格复制官方模型标识。
2. **帧率和周期需要权衡**
单纯缩短周期不调整帧率,动画效果会卡顿,优秀 Agent 会主动做帧率优化。
3. **远程链路注意控制重试**
IM 转发多一层网络链路,更容易超时,超时触发重试会叠加 Token 消耗,建议限制 Agent 最大重试次数。
4. **HTTP 白名单与搜索开关**
在 Claw【网络和搜索设置】页面:调试阶段 HTTP 白名单可以临时填`*`放行;正式使用收紧域名;**非必要一定关闭 Brave Search**,搜索单独计费,还会拉长响应时间,诱发超时重试。
5. **最大化缓存收益**
尽量复用同一个会话,不要频繁新建会话,稳定不变的硬件上下文才能持续命中 KV 缓存,降低 Token 开销。
## 六、适用场景与边界
适合:
- 不在设备旁,远程调试屏幕动画、传感器交互、参数微调
- 远程演示:发送消息,远端板子实时更新效果
- 快速迭代艺术交互原型
不适合:
- 长时间无人值守高频自动循环测试(网络抖动、持续 Token 消耗风险)
- 底层驱动、复杂工程开发(这类场景更适合 VibeCoding 电脑端 ESP-IDF 路线)
## 结尾
很多人理解的 ChatCoding,局限在设备本地语音交互。而这套飞书远程 HIL 案例,搭配用量账单,完整展示了它的另一种落地形态:**硬件 Agent 可以和任意 IM 打通,硬件原型变成聊天窗口里可实时调试的远端实体**。
一句话描述需求,Agent 自动完成需求解析、脚本生成、资源抢占、热部署、状态回传;同时依托 DeepSeek-Flash 的缓存优势,多轮迭代的成本极低。这就是面向创客、具身智能原型非常轻量化的开发范式。
附录:实验记录
1、第二轮:二次迭代,修改循环速度为6秒
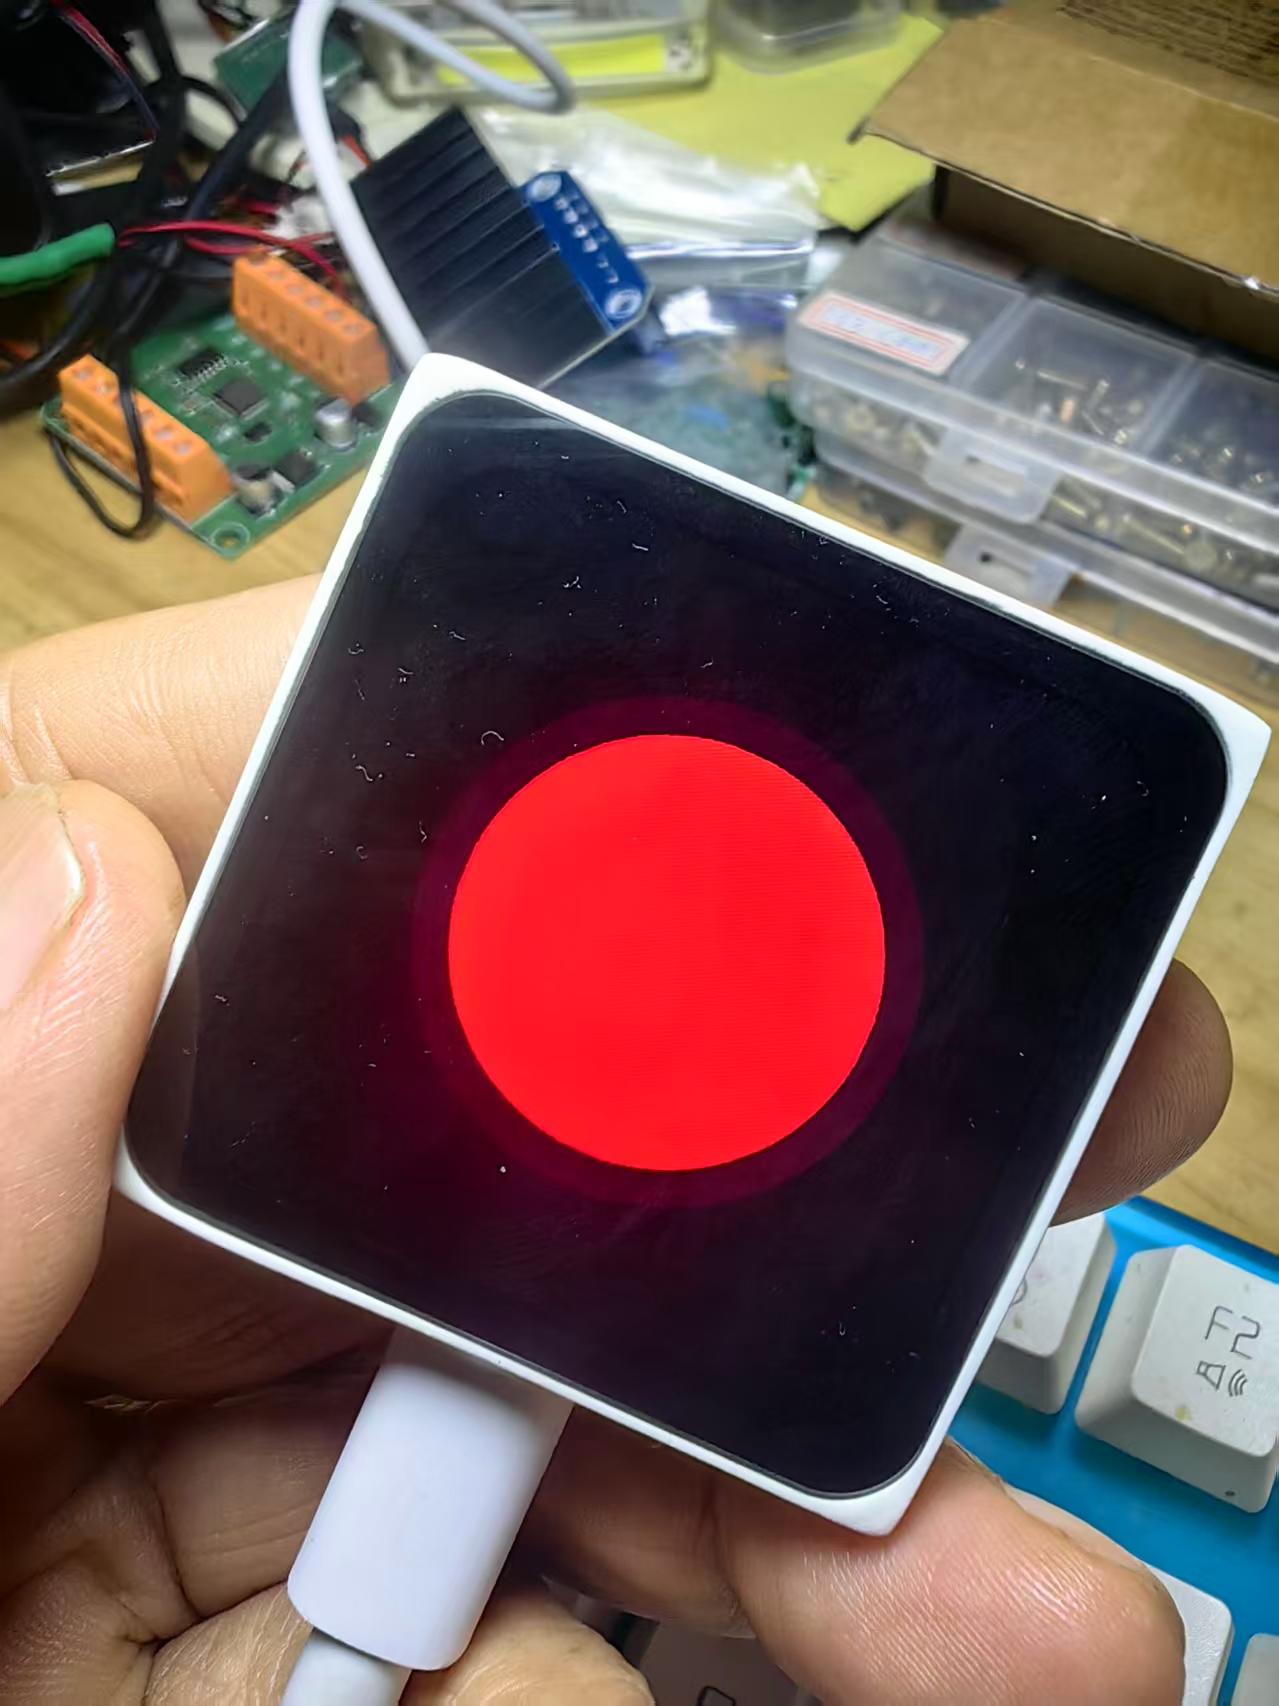
2、第三轮:第三次迭代,增加色彩通道、调整脉动范围